UTF — универсальная кодировка для всего
В прошлый раз мы рассказали про Юникод — универсальную таблицу символов, в которой есть знаки почти всех языков. Вот краткое содержание:
- Когда компьютеры только появились, у них была кодировка только для букв латинского алфавита и некоторых знаков — всего 7 бит и 128 символов.
- С развитием технологий многие страны сделали себе альтернативные восьмибитные кодировки — в них можно было хранить уже 256 символов.
- Кроме латиницы, в таких кодировках записывали буквы национальных алфавитов и другие нужные символы.
- Это сработало в тех странах, где алфавит состоит из небольшого числа букв (20—40), но не решило проблему с иероглифами. Тогда страны Азии сделали свои кодировки.
- В итоге всё это привело к тому, что файл с одного компьютера мог не прочитаться на другом компьютере, если там не было нужной кодировки.
- Для решения этих проблем сделали Юникод — универсальную таблицу, в которую можно поместить 1 112 064 символа.
- Сейчас в Юникоде записаны символы почти всех языков мира, но свободных позиций там осталось ещё около 80%.
Получается, что Юникод — универсальное решение проблемы совместимости текста. Текстовый файл, записанный в таком формате, можно прочитать на любом современном компьютере. Поддержка Юникода есть во всех новых операционных системах последних лет.
Чтобы пользоваться Юникодом, нужна была новая кодировка, которая бы определяла правила хранения информации о каждом символе. Такой кодировкой стала UTF — про неё и поговорим. Она сложно устроена: будет интересно всем, кто интересуется компьютерами.
UTF — универсальная кодировка для хранения символов
Юникод как таковой отвечает на вопрос «Как мы храним символы?». Он объясняет, каким символам мы присваиваем какие коды; по какому принципу выделяем эти коды; какие символы используем, а какие нет.
Но также нам нужно знать, как хранить и передавать данные о символах Юникода. Вот это и есть UTF.
UTF (Unicode Transformation Format) — это стандарт кодирования символов Unicode. Разберём на куски:
- Стандарт — то есть всеобщая договорённость. Разработчик в России и Мексике открывают одну и ту же документацию и одинаково понимают, как им работать с данными. Договорились такие.
- Кодирование — то есть как мы представляем эти данные на компьютере. Это одно большое число? Несколько чисел поменьше? Сколько байтов выделять на эти символы? Нужно ли специально говорить компьютеру, что сейчас будут символы Юникода?
Что такое UTF-8?
Сейчас самая популярная разновидность UTF-кодировки — это UTF-8.
Чаще всего упоминание UTF-8 можно встретить в самом начале HTML-кода, когда мы объявляем кодировку в заголовке страницы. Строчка <meta charset=»utf-8″> как раз говорит браузеру, что всё текстовое содержимое страницы нужно отображать по формату UTF-8.
Число 8 означает, что для хранения данных используются 8 бит информации. Ещё есть 16- и 32-битные кодировки: UTF-16 и UTF-32.
Проблема нулевых байтов
Сейчас немного информатики, потерпите.
Компьютер кодирует числа с помощью единиц и нулей в двоичной системе счисления. Она позволяет закодировать любое число, если дать ей достаточно места в памяти. Эти места измеряются в битах. Одним битом можно закодировать 0 или 1; двумя битами — числа от 0 до 3; восемью битами — от 0 до 255 и так далее. Биты слишком мелкие, поэтому для удобства хранения и обработки компьютеры группируют их по 8 бит, это называется байтом. В памяти можно выделять только байты, а не отдельные биты.
Максимальное количество символов в Юникоде — 1 112 064. Для хранения числа такого размера нам нужен 21 бит. Получается, что кодировка должна уметь работать с 21-битными числами.
Самое простое решение — выделить на каждый символ по 3 байта, то есть 24 бита. Например, символ с номером 998 536 в двоичной системе счисления выглядит так:
Если мы разобьём это на три байта и добавим впереди нужное количество нулей до трёх байтов, то получится такое:
00001111 00111100 10001000
Кажется, что мы сразу нашли способ кодирования: просто выделяй на все символы по три байта и кайфуй.
Но что, если нам нужен, например, символ под номером 150?
Разобьем снова на три байта:
00000000 00000000 10010110
У нас получилось в самом начале два нулевых байта. Проблема в том, что многие системы передачи данных воспринимают нулевые байты как конец передачи. Если они встретят такую последовательность, то решат, что передача окончена, а всё, что идёт дальше, — лишний шум, который обрабатывать не нужно. Если в нашем Юникод-тексте много символов из начала таблицы (например, всё на английском), то с чтением такого файла возникнут проблемы.
Чтобы выйти из этой ситуации, придумали UTF-8 — кодировку с плавающим количеством символов.
Как устроена кодировка UTF-8
В UTF-8 каждый символ кодируется разным количеством байтов — всё зависит от того, какой длины исходное число. Сначала расскажем теорию, потом нарисуем, как это работает.
До 7 бит — выделяется один байт, первый бит всегда ноль: 0xxxxxxxx. Иксы — это биты нашего числа. Например, буква A стоит на 65-м месте в таблице, а если перевести 65 в двоичный код, получится 1000001. Ставим эти 7 бит в наш шаблон и получаем нужный юникод-байт: 01000001.
Ноль здесь — признак того, что перед нами символ из первых 128 символов таблицы. Они совпадают с таблицей ASCII, поэтому одним байтом можно закодировать все стандартные математические символы, знаки препинания и буквы латинского алфавита.
Если первым в символе идёт ноль, кодировка понимает, что перед нами — один восьмибитный символ. Двух-, трёх- и четырёхбайтные символы всегда начинаются с единицы.
8—11 бит: выделяется два байта — 110xxxxx 10xxxxxx. Две единицы в начале говорят, что перед нами символ из двух байтов. Последовательность 10 в начале второго байта — признак того, что это продолжение предыдущего байта.
12—16 бит: тут уже три байта — 1110xxxx 10xxxxxx 10xxxxxx. Три единицы в начале — признак трёхбайтного символа. Каждый байт продолжения начинается с 10.
17—21 бит: для кодирования нужно четыре байта: 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx.
Короче: в кодировке UTF договорились, что много байтов выделяют только на те символы, которые стоят где-то в глубине таблицы, то есть всякие сложные национальные кодировки, эмодзи и иконки. Чем ближе к началу таблицы символ, тем меньше байтов на него выделяют. А чтобы компьютер понимал, сколько байтов выделено на каждый конкретный символ, сначала ставят специальные маркеры-подсказки.
Практика: кодируем символы в UTF-8
Закодируем в UTF-8 такой Юникод-символ — �� с порядковым номером 66376.
Для этого сначала переведём число 66376 в двоичный формат:
Здесь 17 бит, поэтому для кодирования в UTF-8 нам понадобится 4 байта. Вот шаблон, который нам нужно будет заполнить:
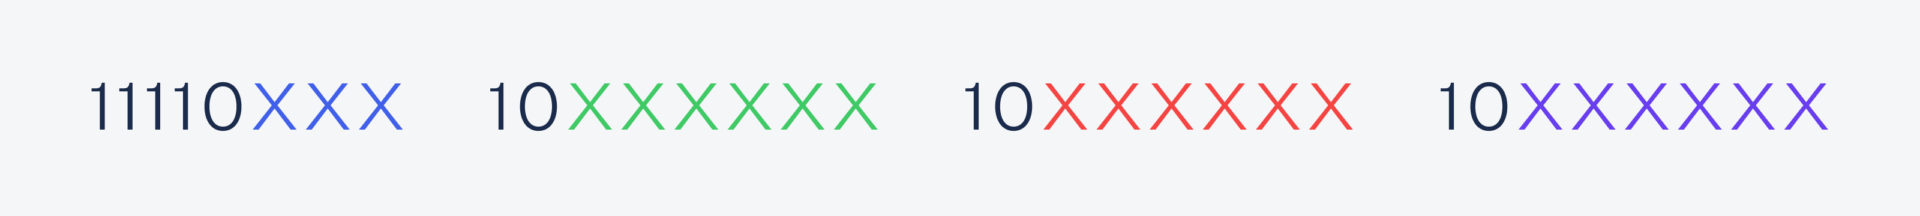
Подготовим наше двоичное число к заполнению по этому шаблону. Для этого разобьем его справа налево на те же группы: 3—6—6—6 символов:
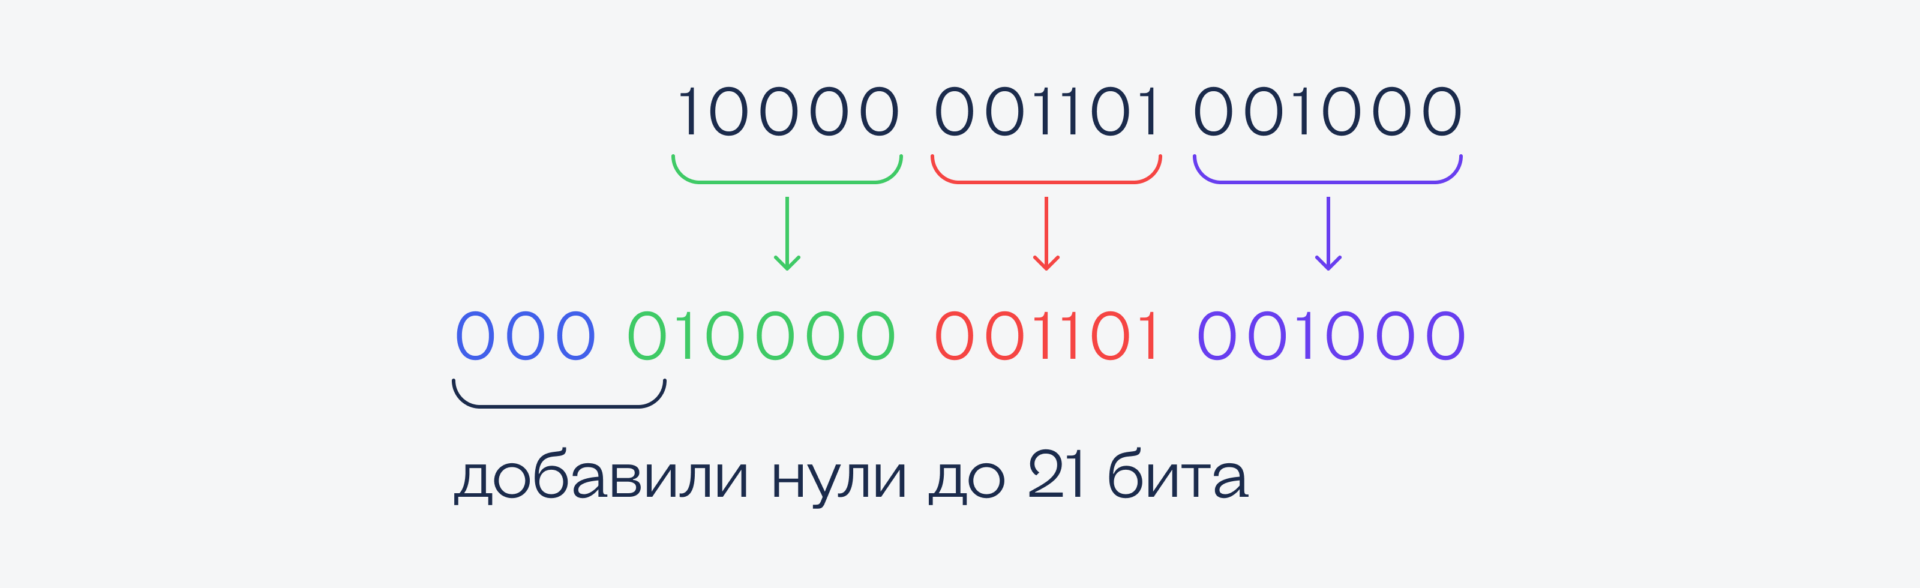
Теперь подставим эти значения в наш четырёхбитный шаблон:
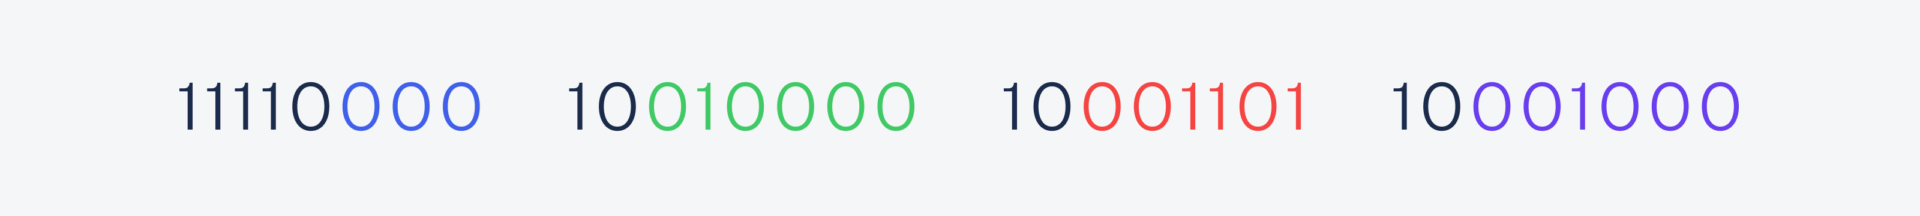
И переведём в шестнадцатеричную систему счисления:
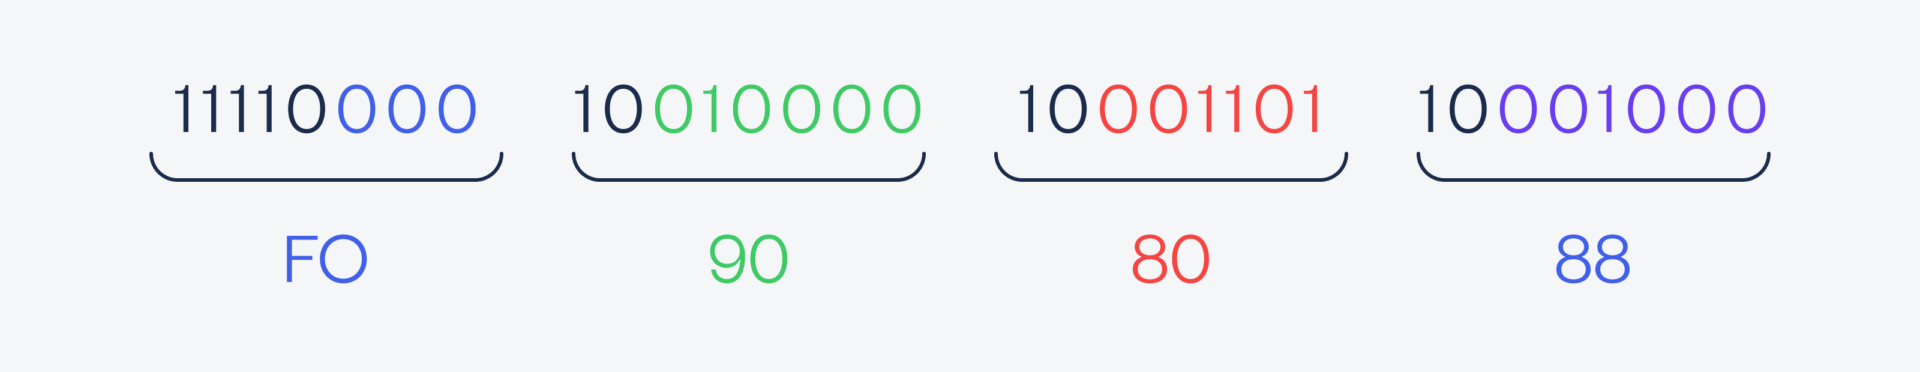
Получается, что символ �� закодируется в четырёх байтах как F0 90 8D 88.
Почему нельзя просто всё кодировать одинаковым количеством бит
Можно, причём так часто делают в некоторых системах. Для этого там используют кодировки UTF-16 и UTF-32 — в них на каждый символ отводится сразу 2 или 4 байта.
Проблема такого подхода в том, что это увеличивает объём памяти, нужный для хранения данных. Проще говоря, те символы, на которых в UTF-8 хватило бы одного байта, здесь занимают в 2–4 раза больше.
С другой стороны, такие кодировки иногда проще в обработке, поэтому их, например, используют как штатные кодировки операционных систем. Так, UTF-16 — стандартная кодировка файловой системы NTFS в Windows.
Проблемы с безопасностью
Так как Юникод с помощью UTF-8 сам преобразует символы в последовательность байтов и наоборот, есть ситуации, когда это может навредить системе и привести к взлому.
Например, пользователю могут прислать файл, который называется otchetexe. txt — кажется, что это обычный текстовый файл, который можно смело открывать. Но на самом деле файл называется otchet[U+202E]txt.exe, а U+202E — это специальный юникод-символ, который включает написание справа налево. После того как Юникод встречает этот символ, он выводит всё написанное после него в обратном порядке. Так простой текстовый файл превращается в исполняемый .exe-файл для Windows. Если его запустить с правами администратора, он может натворить много всякого.
Ещё пример — использование Юникода в разных SQL- и PHP-запросах. Из-за сложных преобразований может произойти переполнение стека — а этим уже могут воспользоваться злоумышленники, чтобы внедрить нужный код для выполнения.
На самом деле Юникод с этой точки зрения — большая дыра в безопасности любой системы, поэтому при работе с ним в критичных ситуациях используют белые списки, то есть те символы, которые использовать безопасно.
Saved searches
Use saved searches to filter your results more quickly
You signed in with another tab or window. Reload to refresh your session. You signed out in another tab or window. Reload to refresh your session. You switched accounts on another tab or window. Reload to refresh your session.
Статья о стандарте Unicode и кодировках
DmitryTsybulkin/unicode
Name already in use
- Local
- Codespaces
Use Git or checkout with SVN using the web URL.
Work fast with our official CLI. Learn more about the CLI.
Sign In Required
Please sign in to use Codespaces.
Launching GitHub Desktop
If nothing happens, download GitHub Desktop and try again.
Launching GitHub Desktop
If nothing happens, download GitHub Desktop and try again.
Launching Xcode
If nothing happens, download Xcode and try again.
Launching Visual Studio Code
Your codespace will open once ready.
There was a problem preparing your codespace, please try again.
Latest commit
Git stats
Files
Failed to load latest commit information.
README.md
Unicode и кодировки UTF-8, UTF-16. Основная информация, необходимая для разработки ПО.
История и введение
При разработке программы, где одной из главных составляющих является задача обработки текста (ввод, редактирование, чтение), важно понимание системы unicode. По своей природе, компьютеры на самом простом уровне работают с битами, но человеку необходимы более сложные сущности, такие как: числа, буквы и другие символы. Поэтому, для их представления в компьютерных системах используются специальные кодировки, способные преобразовывать числовые коды в символы. Кодирование, в свою очередь, – это представление какой-либо информации в ином, закодированном виде, не репрезентативном для человека, который можно вернуть в исходное состояние. Кодировка – это набор правил, описывающий способ перевода одного представления информации в другое.
До появления стандарта unicode, в мире было множество разных схем кодирования символов. Однако, у них было значительное количество недостатков: не было универсальной кодировки — многие схемы были несовместимы по отношению друг к другу; они не описывали все необходимые пользователю символы (наличие множества языков). Для любого компьютера, особенно сервера, необходимо было поддерживать несколько кодировок, но даже при этом существовал риск того, что данные, при передаче, могли оказаться поврежденными.
Одна из наиболее популярных кодировок в тот момент это — ASCII. Всего в систему ASCII включены 128 символов — она использует все комбинации семи битов (от 0000000 до 1111111). Например, последовательность бит двоичной системы 01000001 в изложенной кодировке кодирует символ “A”, или 01000010 кодирует символ “B”. Основная проблема ASCII заключалась в том, что эта кодировка неплохо работала только в англоязычной среде. Использовать её с другими языками было затруднительно.
С целью разрешить несистематизированность и попытаться унифицировать систему кодирования символов, которая могла бы использоваться для множества языков, в 1991 году некоммерческой организацией «Консорциум Юникода» был разработан и предложен стандарт Unicode. В этот консорциум входят такие лидеры компьютерной индустрии, как Apple, HP, IBM, Microsoft, Oracle и т.д. поэтому, эта схема кодирования используется почти во всех современных технологиях и стандартах, а консорциум ставит своими задачами — развитие и распространение этой системы. В результате использования этого стандарта, можно значительно сэкономить на поддержке программного обеспечения. Главной особенностью Unicode является то, что она присваивает уникальный код любому символу, независимо от платформы, программы или языка.
Начиная с октября 1991 года, стандарт постоянно развивается. Последняя версия (12.1) вышла в мае 2019 года. В каждой новой версии появляется больше символов, иероглифов из восточных языков, эмодзи и различных письменностей.
Стандарт состоит из двух основных частей: универсального набора символов (англ. Universal character set, UCS) и семейства кодировок (англ. Unicode transformation format, UTF). Универсальный набор символов перечисляет допустимые по стандарту Unicode символы и присваивает каждому символу код в виде неотрицательного целого числа, записываемого обычно в шестнадцатеричной форме с префиксом U+, например, U+040F. Семейство кодировок определяет способы преобразования кодов символов для передачи в потоке или в файле.
Общее количество кодовых позиций в unicode — 1 112 064, несмотря на значительно больший объём возможных вариантов (2^31 = 2 147 483 648). Это было сделано для совместимости разных представлений: UTF-8, UTF-16 и UTF-32. В последней версии Unicode, за май 2019, количество всех символов составляет 137 994.
Важно отметить, что стандарт unicode полностью совместим основным предшественником — ASCII. Есть конкретная область с кодами от U+0000 до U+007F, которая содержит символы набора ASCII, соответствующие их кодами в ASCII.
Простыми словами, Unicode – это просто огромная таблица соответствия символов и чисел, а различные UTF кодировки определяют, как эти числа переводятся в биты.
Формы представления unicode: UTF-8 и UTF-16
Стандарт Unicode в настоящее время реализуется различными кодировками, самые распространённые — UTF-8 и UTF-16, кодировки с переменной длиной кодирования.
То что кодировка переменной длины, значит, что один символ может быть закодирован разным количеством структурных единиц кодировки, то есть разным количеством байт. Если символ может быть закодирован одним байтом (потому что номер пункта символа очень маленький), UTF-8 закодирует его одним байтом. Если нужно 2 байта, то используется 2 байта. Так, например, латиница кодируется одним байтом, а кириллица двумя байтами. Кодировка сообщает старшим битам, сколькими битами кодируется текущий символ. Такой способ экономит место, но так же, тратит его в случае, если эти сигнальные биты часто используются. Пример кодирования:
UTF-16 является компромиссом в использовании: все символы как минимум двухбайтные, но их размер может увеличиваться до 4 байт. На западных языках обычно эффективнее всего кодируются с использованием стандарта UTF-8 (так как большинство символов в таких текстах могут быть представлены в виде кодов размером в 1 байт). Если же говорить о восточных языках, то можно сказать, что файлы, хранящие тексты, написанные на этих языках, обычно получаются меньше при использовании UTF-16.
Любой символ юникода в кодировке UTF-16 может быть закодирован либо одной парой байт или кодовой парой, либо двумя.
Количество символов, кодируемых одной кодовой парой может быть 65 535 (2^16), что полностью совпадает с базовым блоком юникода. Все символы находящиеся в этом блоке в кодировке UTF-16 будут закодированы одной кодовой парой (двумя байтами), тут все просто.
Для символов, находящихся за пределами базового unicode диапазона потребуется уже две кодовые пары (4 байта). И механизм их кодирования немного сложнее.
Для пояснения, необходимо ввести понятие “суррогатной пары”. Суррогатная пара — это две кодовые пары используемые для кодирования одного символа (итого 4 байта). Для таких суррогатных пар в таблице юникода отведен специальный диапазон от D800 до DFFF. Это значит, что при преобразовании кодовой пары из байтового вида в шестнадцатеричный вы получаете число из этого диапазона, то перед вами не самостоятельный символ, а суррогатная пара.
Чтобы закодировать символ из диапазона 10000 — 10FFFF (то есть символ для которого нужно использовать более одной кодовой пары) нужно:
- Из кода символа вычесть 10000 (шестнадцатеричное) (это наименьшее число из диапазона 10000 — 10FFFF)
- В результате первого пункта будет получено число не больше FFFFF, занимающее до 20 бит
- Ведущие 10 бит из полученного числа суммируются с D800 (начало диапазона суррогатных пар в юникоде)
- Следующие 10 бит суммируются с DC00 (тоже число из диапазона суррогатных пар)
- После этого получатся 2 суррогатные пары по 16 бит, первые 6 бит в каждой такой паре отвечают за определение того что это суррогат,
- Десятый бит в каждом суррогате отвечает за его порядок если это 1 то это первый суррогат, если 0, то второй.
(Подробнее в дополнительной литературе: Как работают кодировки текста. Откуда появляются «кракозябры». Принципы кодирования. Обобщение и детальный разбор).
Иногда, при обработке текста, можно встретить проблему того, что символы, выглядящие для человека одинаково, имеют различное внутреннее представление. Например, букву é в можно представить двумя способами:
- С помощью одной кодовой точки U+00E9.
- С помощью комбинации буквы e и знака акута, то есть — с помощью двух кодовых точек — U+0065 и U+0301 (комбинации символов).
Таким образом, визуально буква будет выглядеть идентично, но закодирована по-разному. Это может быть серьезной проблемой, при написании ПО, потому что она может возникнуть, например, при вводе пользователем каких либо данных: аутентификация в системе — пользователь ввёл верные данные для входа, однако, при поиске записей в БД, запись может быть не найдена, потому что коды символов различны. Для решения этой проблемы существуют алгоритмы нормализации строк (приведение их к каноническому виду).
Существуют четыре стандартных формы (алгоритма) нормализации:
- NFC: Normalization Form Canonical Composition. Форма нормализации C — алгоритм, согласно которому последовательно выполняются каноническая декомпозиция и каноническая композиция.
- NFD: Normalization Form Canonical Decomposition. Каноническая декомпозиция — алгоритм, согласно которому выполняется рекурсивное разложение составных символов на последовательность из одного или нескольких простых символов в соответствии с таблицами декомпозиции. Рекурсивное потому, что в процессе разложения составной символ может быть разложен на несколько других, некоторые из которых тоже являются составными, и к которым применяется дальнейшее разложение.
- NFKC: Normalization Form Compatibility Composition. Форма нормализации KC — алгоритм, согласно которому последовательно выполняются совместимая декомпозиция (алгоритм NFKD) и каноническая композиция (алгоритм NFC).
- NFKD: Normalization Form Compatibility Decomposition. Форма нормализации KD — совместимая декомпозиция — алгоритм, согласно которому последовательно выполняются каноническая декомпозиция и замены символов текста по таблицам совместимой декомпозиции.
Чаще всего используется форма нормализации NFC. При использовании этого алгоритма все символы сначала подвергаются декомпозиции (процесс, при котором все буквы по возможности разбиваются на модификаторы), после чего все комбинирующиеся последовательности подвергаются повторной композиции (процесс, при котором все буквы по возможности объединяются в одну) в порядке, определяемом стандартом. Для практического применения можно выбрать любую форму. Главное — применять её последовательно. В результате поступление на вход программы одних и тех же данных всегда будет приводить к одному и тому же результату.
Несмотря на наличие такого унифицированного стандарта кодирования символов, у Unicode остаются некоторые нерешенные проблемы:
- Тексты на китайском, корейском и японском языках имеют традиционное написание сверху вниз, начиная с правого верхнего угла. Переключение горизонтального и вертикального написания для этих языков не предусмотрено в Unicode — это должно осуществляться средствами языков разметки или внутренними механизмами текстовых процессоров.
- Наличие или отсутствие в Unicode разных начертаний одного и того же символа в зависимости от языка. Нужно следить, чтобы текст всегда был правильно помечен как относящийся к тому или другому языку.
- Так, китайские иероглифы могут иметь разные начертания в китайском, японском (кандзи) и корейском (ханча), но при этом в Unicode обозначаются одним и тем же символом (так называемая CJK-унификация), хотя упрощённые и полные иероглифы всё же имеют разные коды.
- Аналогично, русский и сербский языки используют разное начертание курсивных букв п и т (в сербском они выглядят как и и ш, см. сербский курсив).
- Перевод из строчных букв в заглавные тоже зависит от языка.
- Даже с арабскими цифрами есть определённые типографские тонкости: цифры бывают «прописными» и «строчными», пропорциональными и моноширинными — для Unicode разницы между ними нет. Подобные нюансы остаются за программным обеспечением.
Некоторые недостатки связаны не с самим Unicode, а с возможностями обработчиков текста.
- Файлы нелатинского текста в Unicode всегда занимают больше места, так как один символ кодируется не одним байтом, как в различных национальных кодировках, а последовательностью байтов (исключение составляет UTF-8 для языков, алфавит которых укладывается в ASCII, а также наличие в тексте символов двух и более языков, алфавит которых не укладывается в ASCII). Файл шрифта, необходимый для отображения всех символов таблицы Unicode, занимает сравнительно много места в памяти и требует больших вычислительных ресурсов, чем шрифт только одного национального языка пользователя. С увеличением мощности компьютерных систем и удешевлением памяти и дискового пространства эта проблема становится всё менее существенной; тем не менее, она остаётся актуальной для портативных устройств, например, для мобильных телефонов.
- Хотя поддержка Unicode реализована в наиболее распространённых операционных системах, до сих пор не всё прикладное программное обеспечение поддерживает корректную работу с ним. В частности, не всегда обрабатываются метки порядка байтов (BOM) и плохо поддерживаются диакритические символы. Проблема является временной и есть следствие сравнительной новизны стандартов Unicode (в сравнении с однобайтовыми национальными кодировками).
- Производительность всех программ обработки строк (в том числе и сортировок в БД) снижается при использовании Unicode вместо однобайтовых кодировок.
Unicode — достаточно сложная система, в которой существует множество хитростей и лазеек: от невидимых символов и контрольных знаков до суррогатных пар и комбинированных эмодзи (когда при сложении двух знаков получается третий). По этой причине, злоумышленники, хорошо осведомленные о нюансах Unicode могут использовать их для атаки ПО.
Например, существует атака, описанная OWASP, направленная на поиск недостатков в механизме декодирования, реализованном в приложениях при декодировании формата данных Unicode. Злоумышленник может использовать эту технику для кодирования определенных символов в URL-адресе, чтобы обойти фильтры приложений, таким образом получая доступ к ограниченным ресурсам на веб-сервере или принудительно просматривая защищенные страницы.
Другой пример уязвимости, найденной сравнительно недавно, это брешь в процедуре восстановления забытого пароля на GitHub, которая позволяла злоумышленнику получить пароль от чужого аккаунта.
В рамках этой процедуры восстановления, выполнялось сравнение введённого адреса электронной почты с адресом, который хранится в базе. Алгоритм проверки:
- Введённый адрес переводится в нижний регистр с помощью метода toLowerCase .
- Введённый адрес сравнивается с адресом в базе зарегистрированных пользователей.
- Если найдено совпадение, пароль из базы данных высылается на введённый адрес.
Очевидно, разработчики не знали о коллизии трансляции адресов при использовании метода toLowerCase . В данном случае исправить ошибку просто. Достаточно отправить пароль не на введённый адрес, а на адрес из базы данных.
Связанные с Юникодом баги имеют такое свойство, что их можно встретить в любом приложении, которое обрабатывает текст, введённый пользователем. Уязвимости есть и в веб-приложениях, и в нативных программах под Android и iOS.
Большую известность получила ошибка, связанная с воспроизведением символов Unicode для индийского языка телугу. Проблема возникала на некоторых версиях iOS в приложениях, использующих дефолтный шрифт San Francisсo. Получив всего несколько символов జ్ఞా, пользователь терял управление над многими приложениями в iOS, включая почту и Facebook. Если один из символов телугу появлялся во всплывающих уведомлениях, то блокировался SpringBoard — приложение, отвечающее за главный экран в iOS.
Ошибка изменения символов, приводящая к краху системы, кроется в особенности языка телугу, бенгали и некоторых других диалектов. Она заключается в последовательном построении иероглифов из элементов письма — глифов, при этом имеется определенное расположение символов, не характерное для языка. К сбою приводит преобразование соединительных суффиксов в согласных: когда вторую согласную букву слоговой алфавитной письменности телугу присоединяют к первой согласной для объединения без значительного изменения формы слова. Вследствие несовместимости глифов возникает ошибка, которую не может обработать процессор устройства.
Подводя итог, можно отметить следующие важные моменты касательно Unicode:
Сколько места в памяти компьютера занимает код одного символа
Unicode использует два варианта кодирования: 8-битный и 16-битный. По умолчанию используется 16-битное кодирование, то есть каждый символ занимает 16 бит (два байта); обычно его записывают как U+hhhh, где hhhh — шестнадцатеричный код символа.
Сколько места надо выделить на 1 символ в кодировки ASCII
В кодировке ASCII для кодирования одного символа требуется 1 байт информации (I = 1 байт = 8 битов).
Какой объем памяти занимает символ в кодировках ASCII и Unicode
В кодировке Unicode для хранения одного символа текста используется 2 байта (или 16 бит). А кодировке ASCII один символ занимает 1 байт памяти, что соответствует 8 битам.
Сколько байтов занимает один символ в ASCII
Те, которые входят в старый ASCII, кодируются одним байтом и их значения полностью с ASCII совпадают. Русские и, например, западноевропейские символы кодируются двумя байтами, японские катакана и хирагана — тремя, а есть еще всякая экзотика, где могут быть и четыре байта.
Чему равняется 1 символ
Т. к. 256 = 28, то вес 1 символа — 8 бит. Единице в 8 бит присвоили свое название — байт.
Какой объем занимает 1 символ
Расширенная ASCII позволяет использовать все 8 бит для кодирования. В таблице Unicode используется 2 байта, поэтому можно сказать, что 1 символ в компьютере занимает 1 или 2 байта.
Чему равен 1 символ в байтах
Один символ кодировки UTF-16 представлен последовательностью двух байт или двух пар байт.
Сколько весит один символ в кодировке UTF-8
UTF-8, по сравнению с UTF-16, наибольший выигрыш в компактности даёт для текстов на латинице, поскольку латинские буквы без диакритических знаков, цифры и наиболее распространённые знаки препинания кодируются в UTF-8 лишь одним байтом, и коды этих символов соответствуют их кодам в ASCII.
Сколько весит один символ в кодировке UTF-16
Один символ кодировки UTF-16 представлен последовательностью двух байтов или двух пар байтов.
Сколько весит один символ в UTF 32
Universal Character Set) в информатике — один из способов кодирования символов Юникода, использующий для кодирования любого символа ровно 32 бита. Остальные кодировки, UTF-8 и UTF-16, используют для представления символов переменное число байтов.
Сколько бит на символ
Каждый из этих символов представлен 7 битами данных. Для пересылки символов из расширенной таблицы ASCII (128-255) нужно использовать 8 битов.
Сколько символом в ASCII
В стандартной таблице ASCII 128 символов, пронумерованных от 0 до 127. В них входят латинские буквы, цифры, знаки препинания и управляющие символы.
Сколько весит один символ
При написании сообщения известно, что один символ весит 5 бит, сколько символов в алфавите?
Почему 1 символ равен 1 байт
1 байт= 8 бит, один символ алфавита кодируется одним байтом.
Сколько символов содержит 1 бит
1.1. Бит — это один разряд двоичного кода (двоичная цифра). Может принимать только два взаимоисключающих значения: «да» или «нет», «1» или «0», «включено» или «выключено», и т.
Сколько весит один символ на клавиатуре
Один символ компьютерного алфавита весит \(8\) бит или \(1\) байт.
Сколько весит один пробел
Заметим, что пробел занимает 1 байт.
Сколько весит символ в строке
В современных системах 1 символ строки занимает 1 байт информации.
Сколько памяти отводится для кодирования 1 символа с помощью таблицы кодировки Unicode
Кодировка Unicode использует для кодирования одного символа 16 бит.
Сколько символов в кодировке
Unicode содержит 1,114,112 кодовых значений; на настоящий момент времени, для них назначено более 96,000 символов.
Какое количество информации используется для кодирования одного символа
Традиционно для кодирования одного символа используется количество информации, равное 1 байту, то есть I = 1 байт = 8 битов. Для кодирования одного символа требуется 1 байт информации.
Сколько весит символ в Unicode 16
Один символ кодировки UTF-16 представлен последовательностью двух байтов или двух пар байтов.
Сколько байт один символ UTF-8
UTF-8 — это кодировка символов переменной длины, что, в данном случае, означает длину от 1 до 4 байт на символ.
Сколько весит один символ в UTF-8
UTF-8, по сравнению с UTF-16, наибольший выигрыш в компактности даёт для текстов на латинице, поскольку латинские буквы без диакритических знаков, цифры и наиболее распространённые знаки препинания кодируются в UTF-8 лишь одним байтом, и коды этих символов соответствуют их кодам в ASCII.
Сколько байтов занимает один символ Unicode?
Я немного запутался в кодировках. Насколько я знаю, старые символы ASCII занимали один байт на символ. Сколько байтов требуется для символа Юникода?
Я предполагаю, что один символ Unicode может содержать все возможные символы из любого языка — я прав? Так сколько байт нужно для каждого символа?
А что означают UTF-7, UTF-6, UTF-16 и т. Д.? Это разные версии Unicode?
Я прочитал статью про Unicode из Википедии, но это довольно сложно для меня. Я с нетерпением жду простого ответа.
10 ответов
Вы не увидите простого ответа, потому что его нет.
Во-первых, Unicode не содержит «каждого символа из каждого языка», хотя, безусловно, пытается.
Юникод сам по себе является отображением, он определяет кодовые точки, а кодовая точка — это число, связанное обычно с символом. Обычно я говорю, потому что есть такие понятия, как объединение персонажей. Вы можете быть знакомы с такими вещами, как акценты или умлауты. Они могут быть использованы с другим персонажем, таким как a или u создать нового логического персонажа. Следовательно, символ может состоять из 1 или более кодовых точек.
Чтобы быть полезными в вычислительных системах, нам нужно выбрать представление для этой информации. Это различные кодировки Unicode, такие как utf-8, utf-16le, utf-32 и т. Д. Они отличаются в основном размером их кодовых блоков. UTF-32 — простейшая кодировка, она имеет 32-битный кодовый блок, что означает, что отдельная кодовая точка удобно вписывается в кодовый блок. В других кодировках будут ситуации, когда для кодовой точки потребуется несколько кодовых блоков или эта конкретная кодовая точка вообще не может быть представлена в кодировке (это проблема, например, в UCS-2).
Из-за гибкости объединения символов, даже в данной кодировке число байтов на символ может варьироваться в зависимости от символа и формы нормализации. Это протокол для работы с символами, которые имеют более одного представления (можно сказать, «an ‘a’ with an accent» который является 2 кодовыми точками, одна из которых представляет собой комбинацию символов или «accented ‘a'» которая является одной кодовой точкой).