Что такое рекурсия в python
Взгляните на картинки ниже и вы поймете, что уже встречались с рекурсией в реальной жизни.


В программировании под рекурсией понимается такая функция, которая вызывает саму себя.
Но если вы напишите функцию,которая будет вызывать саму себя бесконечное количество раз, получите ошибку Recursionerror: maximum recursion depth exceeded. Попробуйте запустить у себя на компьютере следующую программу.
Поэтому для того, чтобы написать рекурсивную функцию, у вас должно быть условие выхода. То есть условие, от выполнения которого будет зависеть, нужно ли вызывать функцию вновь. Попробуйте запустить программу ниже.
Условие выхода называют также базовым случаем — самым простым решением какой-нибудь задачи.
Нахождение факториала с помощью рекурсии
Например, базовым случаем (самым простым случаем) нахождения факториала, является 1! или 0!. Это значение гораздо легче найти, чем например 7! (факториал 7).
Но рекурсии кроме базового случая должен присутствовать рекурсивный случай или шаг рекурсии — это способ сведения задачи к более простой. Например, 5! = 1*2*3*4*5 = 4!*5. То есть, чтобы найти факториал пяти, достаточно знать факториал четырех и умножить это на 5. Тогда в общем виде рекурентная формула нахождения факториала будет выглядеть следующим образом:

А код реализации будет следующим:
Нахождение чисел Фибоначчи
Числа Фибоначчи представляют собой рекурентный ряд чисел — это значит, что в этом ряду должны быть обязательно первые члены ряда (обычно это 0 и 1), а все остальные числа находятся от предыдущих путем сложения двух чисел стоящих перед текущим.
В итоге получаем такой ряд: 0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55 и т.д.
У каждого числа в этом ряду есть свой порядковый номер, начинается нумерация с единицы. И давайте обозначим за F(n) — n-ое число Фибоначчи. И тогда,чтобы найти пятое число Фибоначчи нужно сложить два предыдущих к нему F(5) = F(4)+F(4). А общая формула нахождения будет выглядеть следующим образом:
Ниже приведена реализация этой формулы в Python. Более подробно о том, как реализован этот алгоритм, смотрите в видео.
Проверить строку на палиндром(рекурсия)
Палиндром — слово или фраза, которые одинаково читаются слева направо и справа налево.
Строка, состоящая из одного символа, по умолчанию является палиндромом. Это наш базовый или самый простой случай. Также за палиндром мы будет принимать и пустую строку.
А для всех остальных строк мы будет брать первый и последний символ, если они совпадают, то рекурсивно будет проверять строку без этих символов, а в противном случае строка не является палиндромом.
Ниже представлена рекурсивная функция, которая реализует проверку на палиндром.
Как работает рекурсия функции: объясняем на примере Python
Чтобы понять рекурсивные алгоритмы, нужно понять рекурсивные алгоритмы. Или прочитать эту статью.
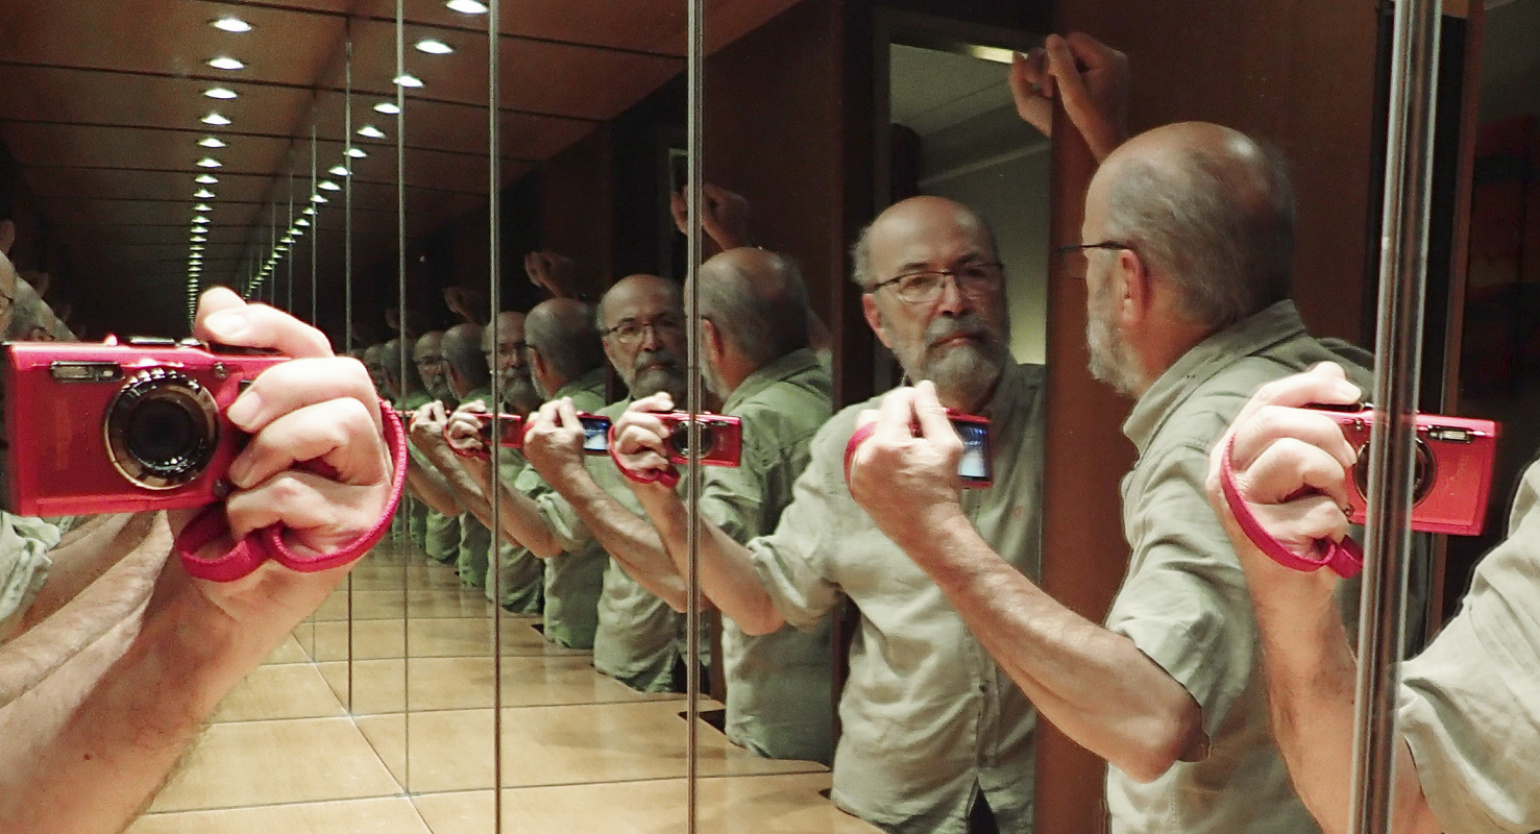
Фото: Bernard Van Berg / Getty Images
Мы уже рассказывали о рекурсии простыми словами и о том, где её можно встретить в реальной жизни. Пришло время объяснить, как и зачем в программировании применяют рекурсивные функции.
Что такое рекурсия: быстрое напоминание
В давние времена некоторые девушки, далёкие от точных наук, любили погадать, закрываясь ровно в полночь в чёрной-чёрной комнате и ставя свечку между двумя зеркалами. Согласно их поверьям, это открывало портал в потусторонний мир. А математики увидели бы в этом наглядное представление рекурсии.
В каждом зеркале отражалась свеча, и отражение этой свечи в другом зеркале, и отражение отражения, и отражение отражения отражения… и так до тех пор, пока девушке не померещится суженый.
Предупреждение: не пытайтесь повторить эксперимент! В кадре задействованы только профессиональные каскадёры! Ни одно животное в процессе съёмки не пострадало!
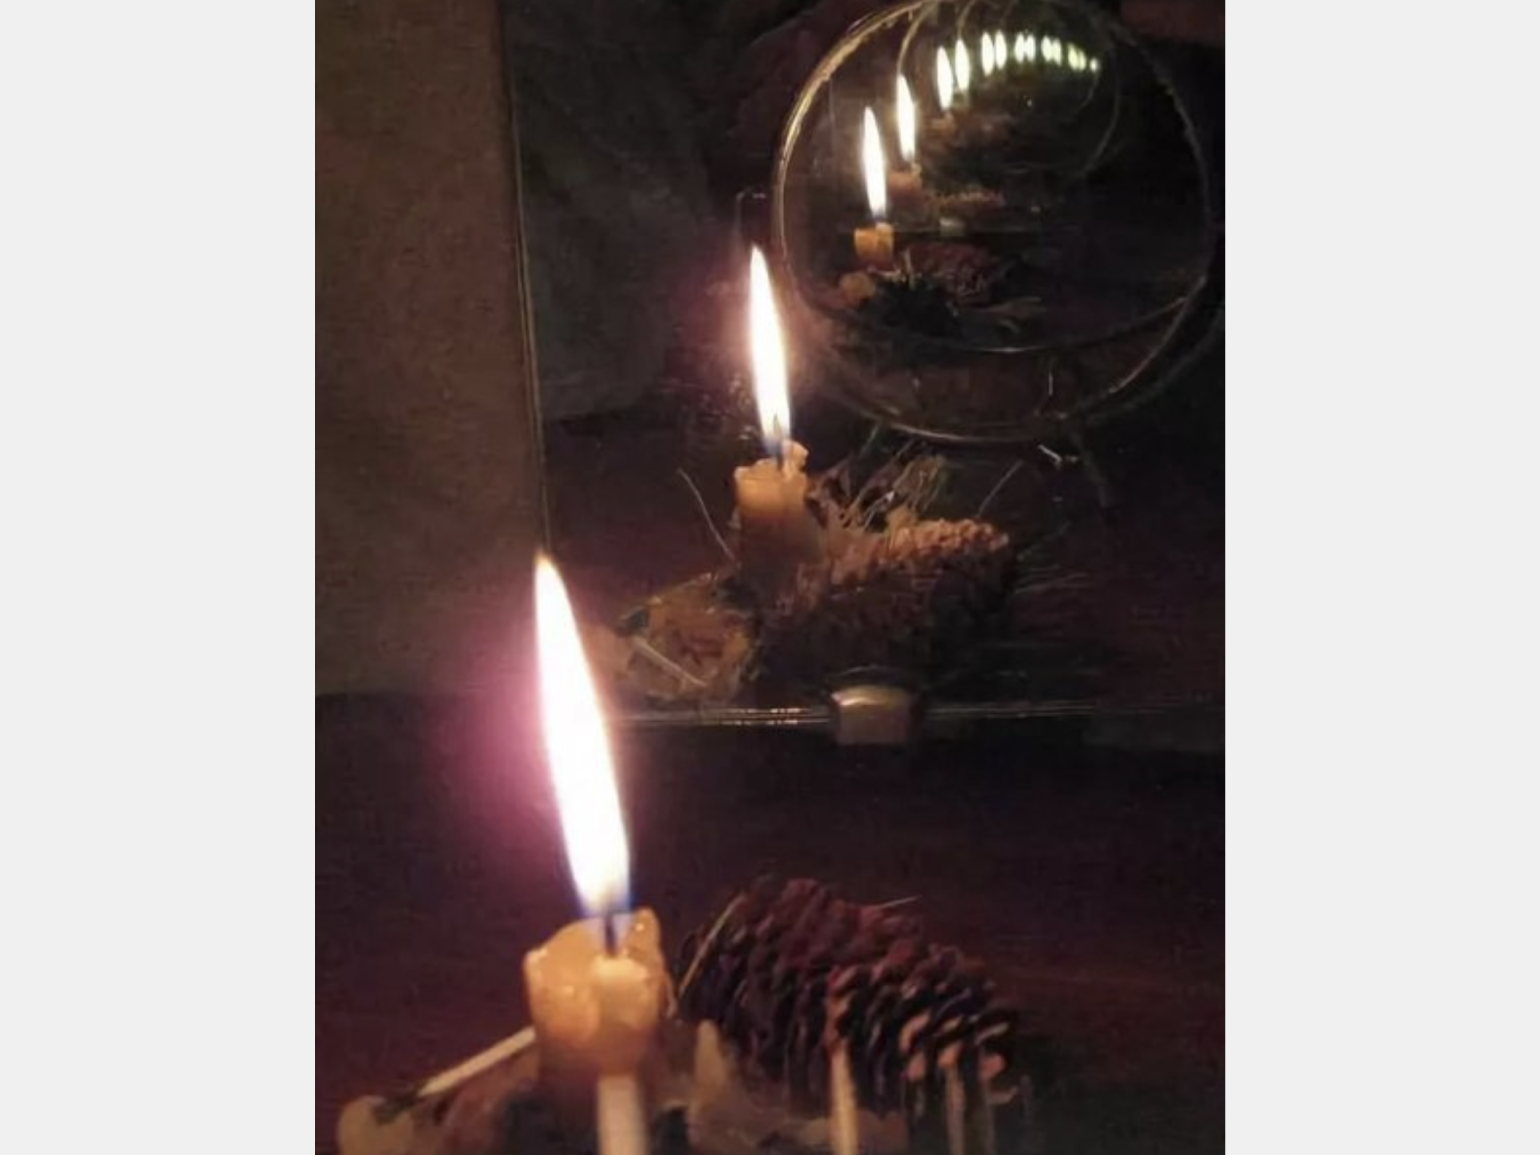
Выражаясь научным языком, рекурсия — это определение или изображение объекта или процесса внутри самого этого объекта или процесса.
Что такое рекурсия функции
Из вышеприведённого определения становится понятно, что рекурсивная функция — это такая функция, которая в процессе выполнения вызывает саму себя. Это свойство бывает полезно при выполнении некоторых задач в программировании.
Например, мы хотим написать функцию summa(n), которая считает сумму чисел от 1 до n. Если n = 2, то результат будет 1 + 2 = 3. Если n = 5, то получится 1 + 2 + 3 + 4 + 5 = 15. Реализовать такой алгоритм можно двумя способами: итерационным и рекурсивным.
Итерационный, или пошаговый, способ. Напишем цикл от 1 до n, в котором на каждом следующем шаге будем прибавлять к x номер шага. На языке Python это выглядит так:
Рекурсивный способ. Во втором варианте нужно решить задачу, используя её же саму.
summa(5) — то же самое, что 5 + summa(4)
summa(4) — то же самое, что 4 + summa(3)
summa(3) — то же самое, что 3 + summa(2)
summa(2) — то же самое, что 2 + summa(1)
Получается, что мы решаем задачу, используя ответ на эту же задачу, но с меньшей величиной входных данных:
Схематично работу функции можно обозначить так:
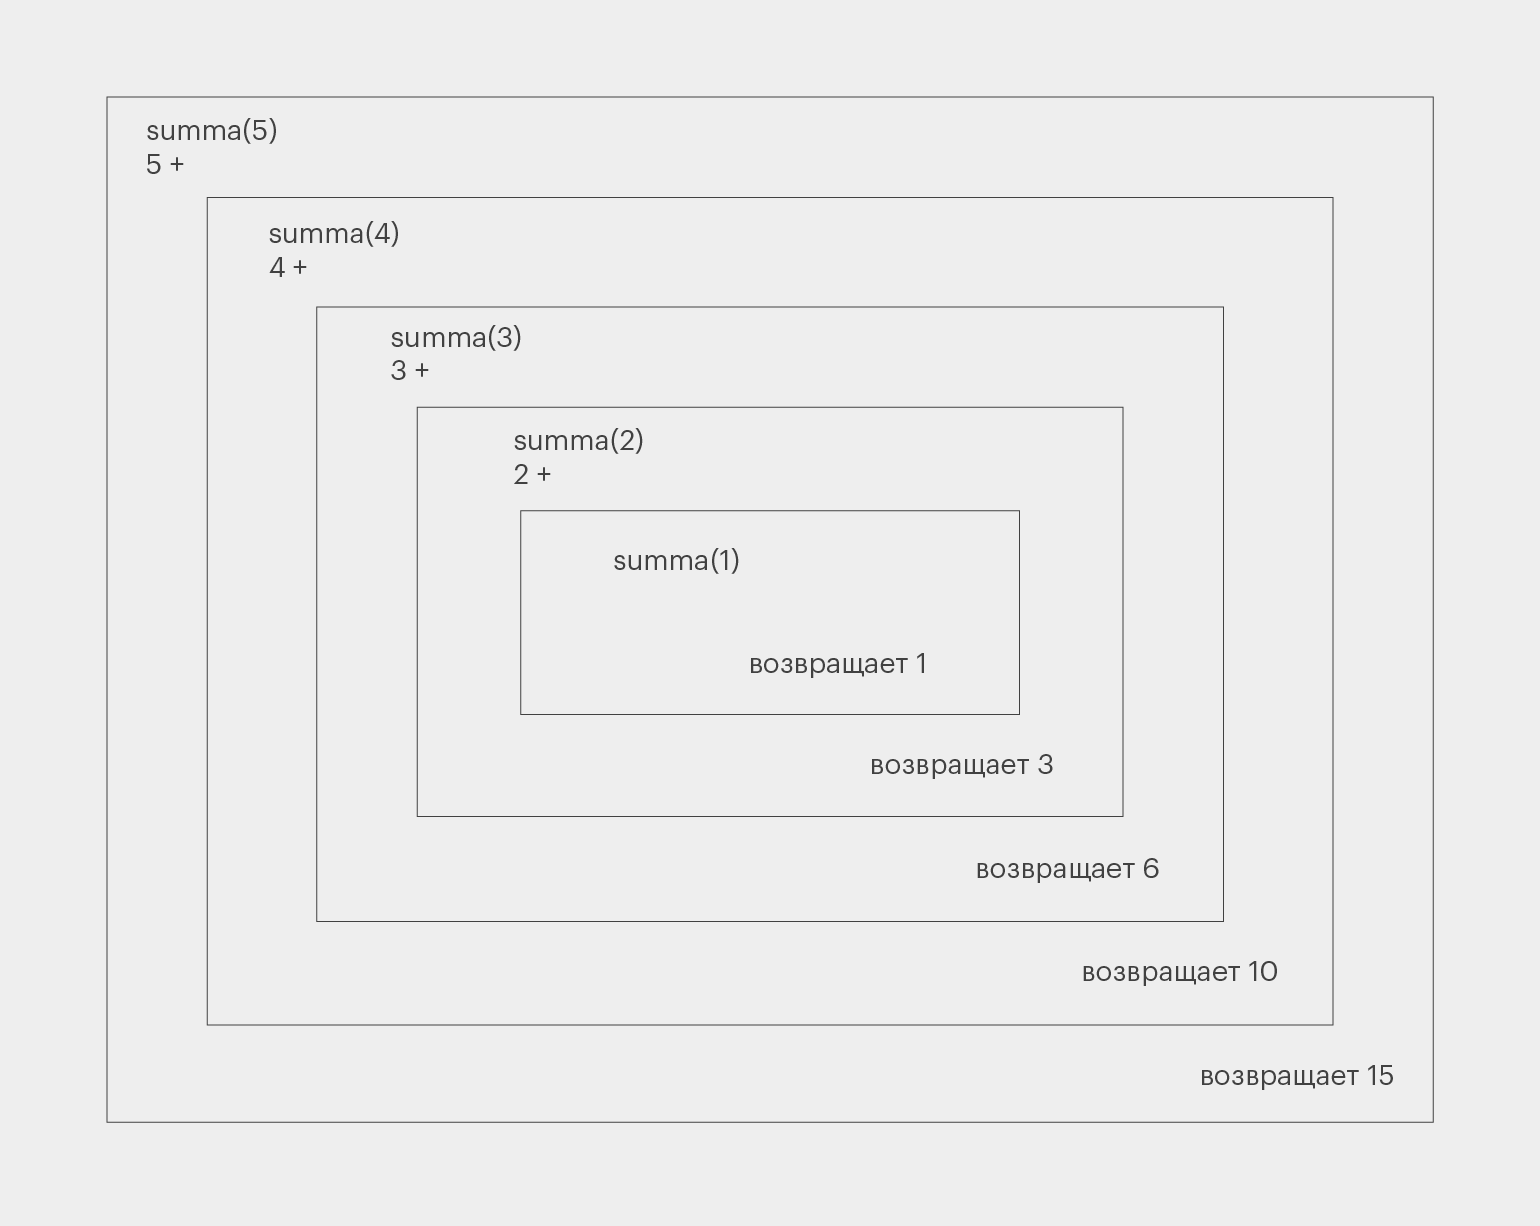
Из команд summa(n) и возвращает x можно составить лестницу. Это буквально шаги работы рекурсивного алгоритма. Сначала он постепенно уходит вглубь рекурсии — а потом идёт в обратную сторону, возвращаясь к первоначальной функции.
На самом деле в большинстве случаев рекурсивную функцию можно заменить циклами: зачастую они работают быстрее и потребляют меньше памяти.
Но при более сложных задачах лучше написать рекурсивное решение: так оперативнее, проще и понятнее, а ещё его легче поддерживать. Нередко это становится более важным и ценным, чем эффективность выполнения кода.
Условия рекурсивных алгоритмов
Вернёмся к нашему примеру с summa(n). Чтобы алгоритм работал, программа должна соответствовать двум требованиям.
Базовый случай
Помимо рекурсивного случая, когда функция вызывает сама себя ещё раз, должно быть определённое стоп-условие, чтобы этот процесс не продолжался бесконечно и функция могла завершить работу самостоятельно. В программировании это называется базовым случаем.
У нас он произойдёт, когда n станет равным 1. Мы упростили задачу настолько, что больше нет смысла считать, — и можем просто дать ответ.
Чтобы добраться до базового случая, рекурсивной функции приходится вызывать себя определённое количество раз. Такое число самовызовов плюс первоначальный вызов функции называется глубиной рекурсии. В случае summa(5) она равна 5.
Рекурсия
Чтобы прийти к базовому случаю, мы должны передавать каждой новой функции изменённые данные. Другими словами, нужно изменять аргумент функции.
В нашем коде при первом вызове n была равна 5, при втором — 4. И так до тех пор, пока n не стала равна 1. Не сделай мы этого, рекурсия никогда бы не завершилась и бесконечно порождала бы новые функции.
Как работают рекурсивные алгоритмы
В момент, когда функция вызывает сама себя, действие «материнской» функции приостанавливается — и начинается выполнение «дочерней».
Но так как рано или поздно программа должна вернуться к «материнской» функции, нужно сохранить данные о её работе. Для этого существует стек вызовов.
Разберём это на примере вызова summa(5). Представим, что компьютер хранит данные о функции в виде блока. В нём содержится значение переменной n и кусок кода, который сейчас выполняется. Пусть он выглядит так:
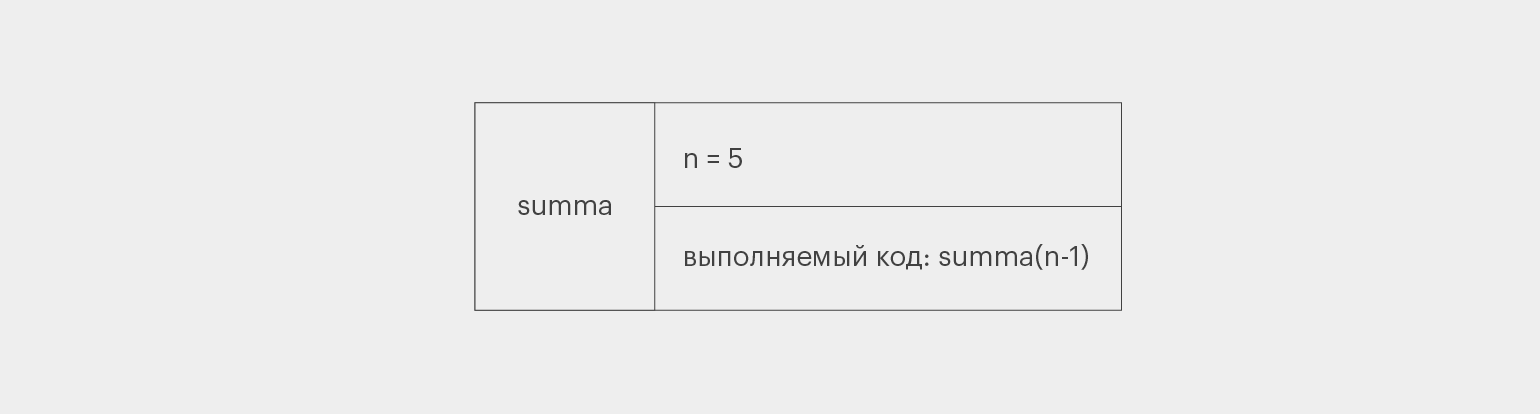
В момент, когда summa(5) вызывает summa(4), создаётся новый блок и кладётся поверх предыдущего:
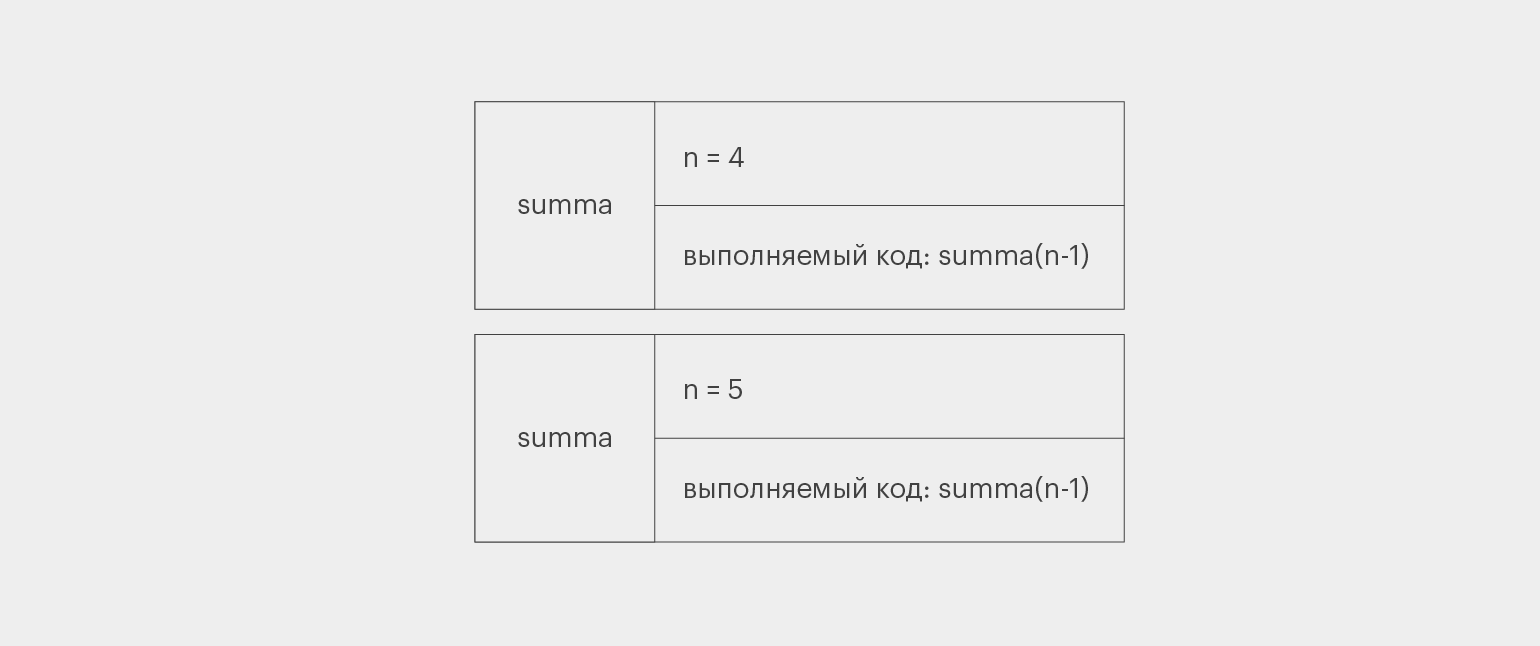
При каждом новом вызове функции на вершине стека оказывается новый блок. Он начинает работать, остальные же в это время ничего не делают и просто хранят данные. Так происходит, пока рекурсия не доходит до базового случая:
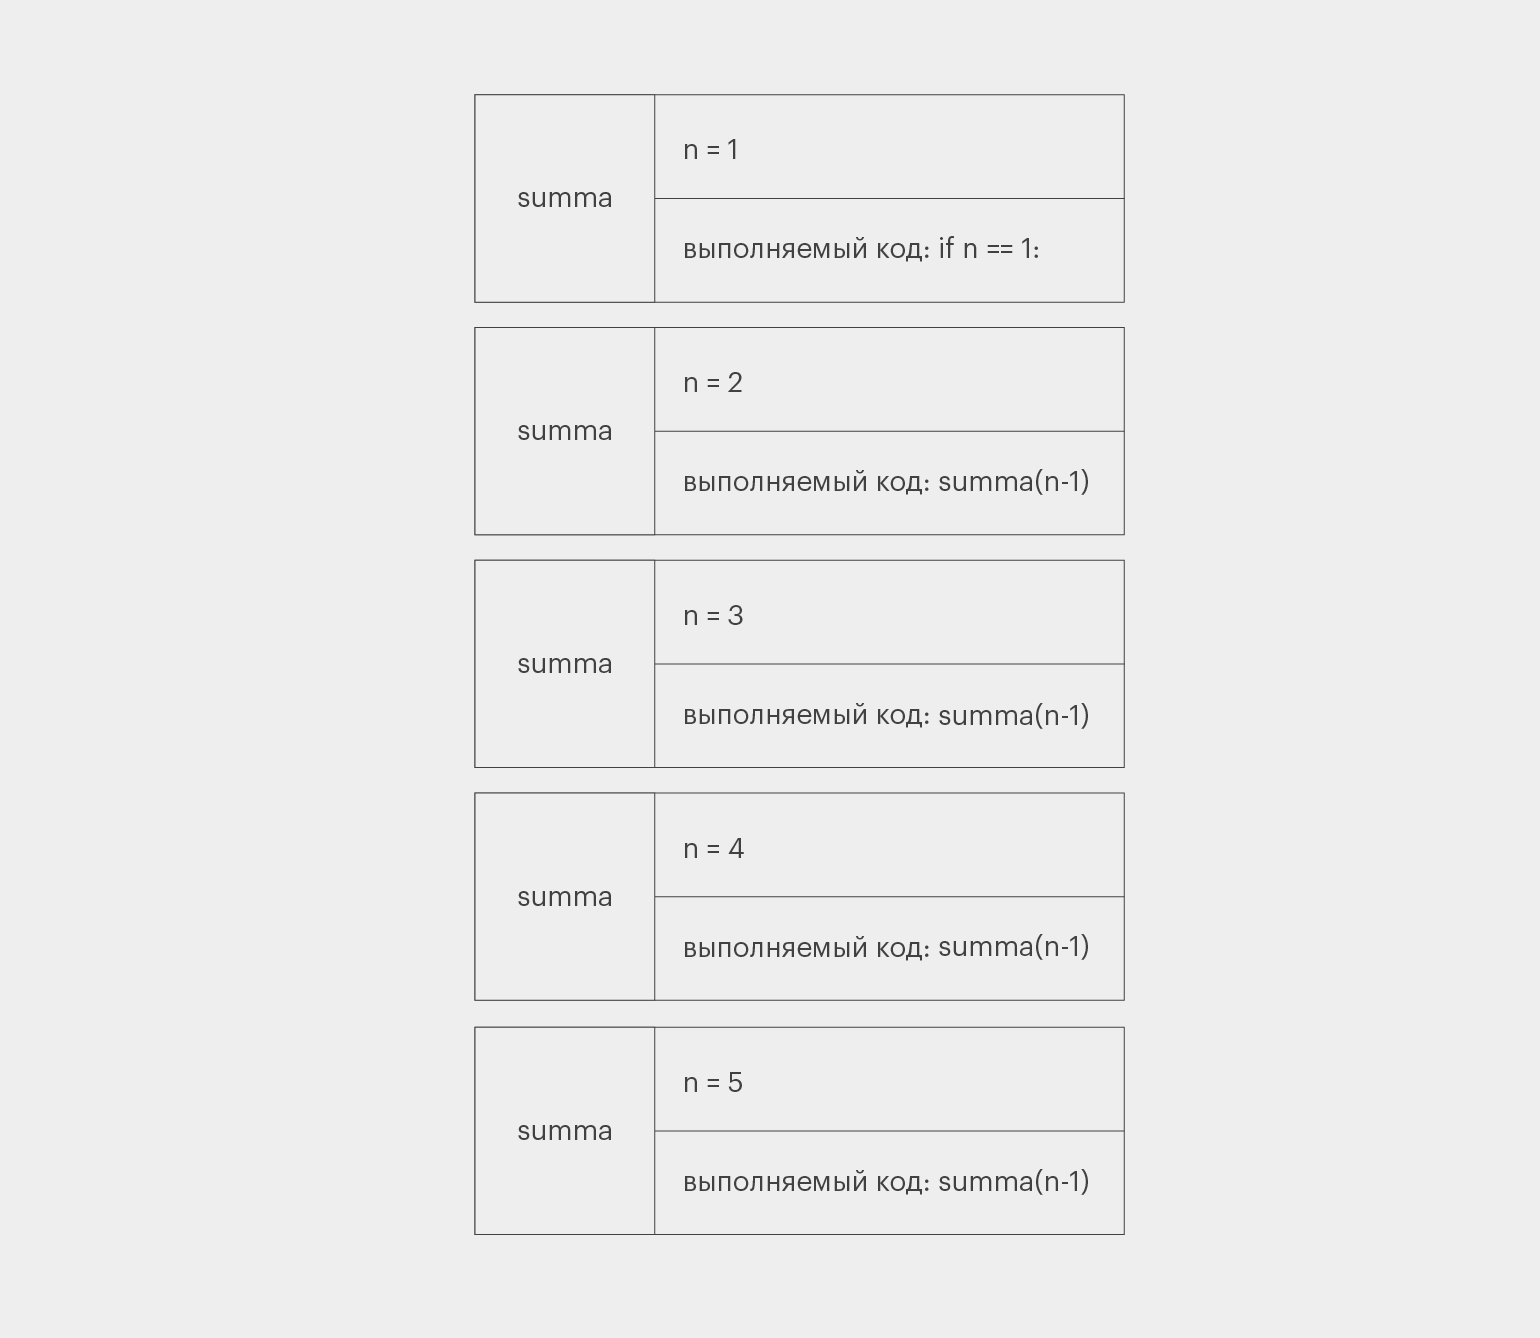
summa(1) возвращает единицу, завершает работу и покидает стек. Теперь наверху находится summa(2):
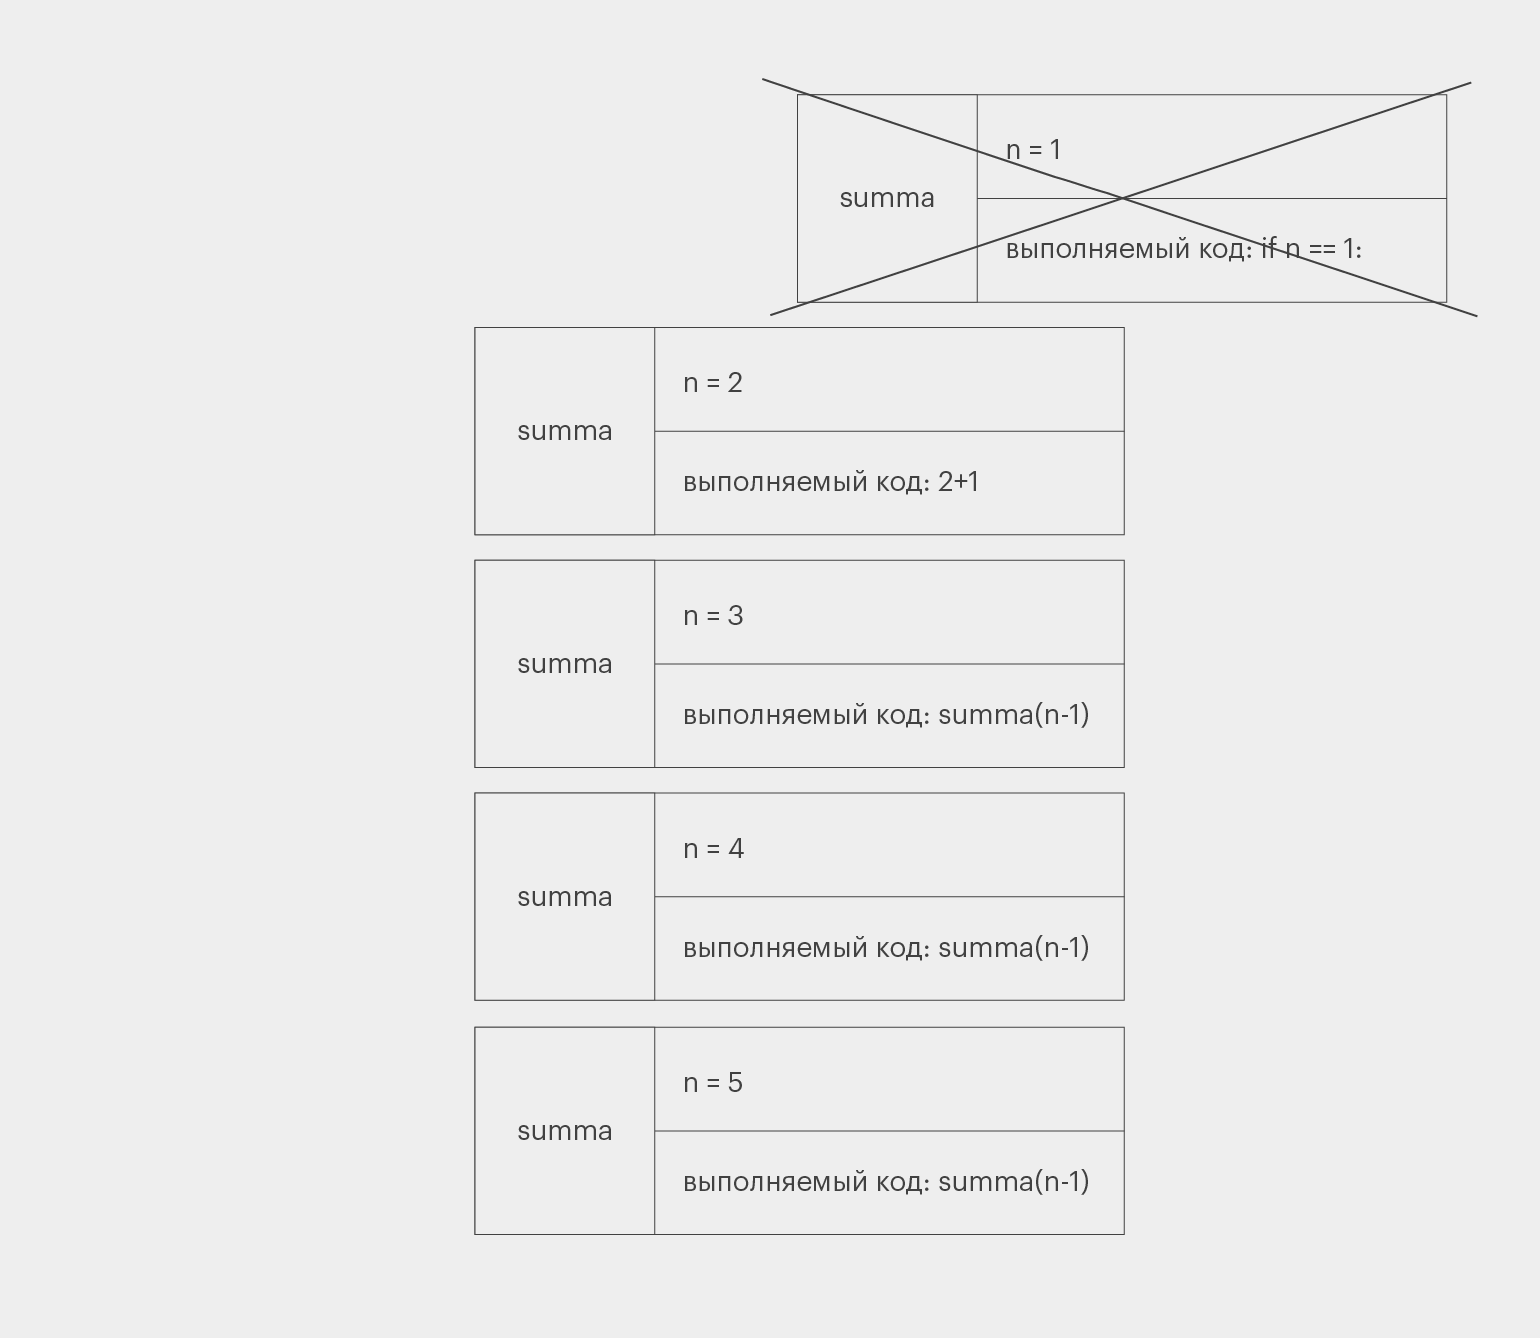
summa(2) продолжает свою работу с момента, на котором остановилась. Она заканчивает выполнять свою программу и тоже покидает стек. Теперь наверху summa(3). И так происходит с каждой функцией, пока стек не закончится.
При прочих равных программы с рекурсивными функциями обычно потребляют больше памяти, чем итерационные. Так происходит потому, что они хранят внутри стека данные обо всех незавершённых функциях.
Память и мощность любой техники ограничены, поэтому у стека всегда есть максимально допустимый размер. Например, в Python он равен 1000 вызовов. Если максимум достигнут, а мы пытаемся положить в стек ещё одну функцию, происходит ошибка «Переполнение стека».
Кстати, именно в честь этой ошибки назван популярный сайт для вопросов и ответов о программировании Stack Overflow.
Итоги
Рекурсивная функция — это функция, которая вызывает сама себя.
Для правильной работы она должна содержать базовый случай и передавать новому уровню рекурсии изменённые данные.
Информация обо всех незавершённых функциях хранится в стеке. При этом в каждый момент времени работает только та функция, которая находится наверху стека.
Рекурсивные алгоритмы обычно медленнее итерационных, но зачастую их проще писать и поддерживать.
# Recursion
Recursion occurs when a function call causes that same function to be called again before the original function call terminates. For example, consider the well-known mathematical expression x! (i.e. the factorial operation). The factorial operation is defined for all nonnegative integers as follows:
- If the number is 0, then the answer is 1.
- Otherwise, the answer is that number times the factorial of one less than that number.
In Python, a naïve implementation of the factorial operation can be defined as a function as follows:
Recursion functions can be difficult to grasp sometimes, so let’s walk through this step-by-step. Consider the expression factorial(3) . This and all function calls create a new environment. An environment is basically just a table that maps identifiers (e.g. n , factorial , print , etc.) to their corresponding values. At any point in time, you can access the current environment using locals() . In the first function call, the only local variable that gets defined is n = 3 . Therefore, printing locals() would show <'n': 3>. Since n == 3 , the return value becomes n * factorial(n — 1) .
At this next step is where things might get a little confusing. Looking at our new expression, we already know what n is. However, we don’t yet know what factorial(n — 1) is. First, n — 1 evaluates to 2 . Then, 2 is passed to factorial as the value for n . Since this is a new function call, a second environment is created to store this new n . Let A be the first environment and B be the second environment. A still exists and equals <'n': 3>, however, B (which equals <'n': 2>) is the current environment. Looking at the function body, the return value is, again, n * factorial(n — 1) . Without evaluating this expression, let’s substitute it into the original return expression. By doing this, we’re mentally discarding B, so remember to substitute n accordingly (i.e. references to B‘s n are replaced with n — 1 which uses A‘s n ). Now, the original return expression becomes n * ((n — 1) * factorial((n — 1) — 1)) . Take a second to ensure that you understand why this is so.
Now, let’s evaluate the factorial((n — 1) — 1)) portion of that. Since A‘s n == 3 , we’re passing 1 into factorial . Therefore, we are creating a new environment C which equals <'n': 1>. Again, the return value is n * factorial(n — 1) . So let’s replace factorial((n — 1) — 1)) of the “original” return expression similarly to how we adjusted the original return expression earlier. The “original” expression is now n * ((n — 1) * ((n — 2) * factorial((n — 2) — 1))) .
Almost done. Now, we need to evaluate factorial((n — 2) — 1) . This time, we’re passing in 0 . Therefore, this evaluates to 1 . Now, let’s perform our last substitution. The “original” return expression is now n * ((n — 1) * ((n — 2) * 1)) . Recalling that the original return expression is evaluated under A, the expression becomes 3 * ((3 — 1) * ((3 — 2) * 1)) . This, of course, evaluates to 6. To confirm that this is the correct answer, recall that 3! == 3 * 2 * 1 == 6 . Before reading any further, be sure that you fully understand the concept of environments and how they apply to recursion.
The statement if n == 0: return 1 is called a base case. This is because, it exhibits no recursion. A base case is absolutely required. Without one, you’ll run into infinite recursion. With that said, as long as you have at least one base case, you can have as many cases as you want. For example, we could have equivalently written factorial as follows:
You may also have multiple recursion cases, but we won’t get into that since it’s relatively uncommon and is often difficult to mentally process.
You can also have “parallel” recursive function calls. For example, consider the Fibonacci sequence
(opens new window) which is defined as follows:
- If the number is 0, then the answer is 0.
- If the number is 1, then the answer is 1.
- Otherwise, the answer is the sum of the previous two Fibonacci numbers.
We can define this is as follows:
I won’t walk through this function as thoroughly as I did with factorial(3) , but the final return value of fib(5) is equivalent to the following (syntactically invalid) expression:
This becomes (1 + (0 + 1)) + ((0 + 1) + (1 + (0 + 1))) which of course evaluates to 5 .
Now, let’s cover a few more vocabulary terms:
Tail call optimization is helpful for a number of reasons:
-
The interpreter can minimize the amount of memory occupied by environments. Since no computer has unlimited memory, excessive recursive function calls would lead to a stack overflow
Python has no form of TCO implemented for a number of a reasons
(opens new window) . Therefore, other techniques are required to skirt this limitation. The method of choice depends on the use case. With some intuition, the definitions of factorial and fib can relatively easily be converted to iterative code as follows:
This is usually the most efficient way to manually eliminate recursion, but it can become rather difficult for more complex functions.
Another useful tool is Python’s lru_cache
(opens new window) decorator which can be used to reduce the number of redundant calculations.
You now have an idea as to how to avoid recursion in Python, but when should you use recursion? The answer is “not often”. All recursive functions can be implemented iteratively. It’s simply a matter of figuring out how to do so. However, there are rare cases in which recursion is okay. Recursion is common in Python when the expected inputs wouldn’t cause a significant number of a recursive function calls.
If recursion is a topic that interests you, I implore you to study functional languages such as Scheme or Haskell. In such languages, recursion is much more useful.
Please note that the above example for the Fibonacci sequence, although good at showing how to apply the definition in python and later use of the lru cache, has an inefficient running time since it makes 2 recursive calls for each non base case. The number of calls to the function grows exponentially to n .
Rather non-intuitively a more efficient implementation would use linear recursion:
But that one has the issue of returning a pair of numbers. This emphasizes that some functions really do not gain much from recursion.
# Sum of numbers from 1 to n
If I wanted to find out the sum of numbers from 1 to n where n is a natural number, I can do 1 + 2 + 3 + 4 + . + (several hours later) + n . Alternatively, I could write a for loop:
Or I could use a technique known as recursion:
Recursion has advantages over the above two methods. Recursion takes less time than writing out 1 + 2 + 3 for a sum from 1 to 3. For recursion(4) , recursion can be used to work backwards:
Function calls: ( 4 -> 4 + 3 -> 4 + 3 + 2 -> 4 + 3 + 2 + 1 -> 10 )
Whereas the for loop is working strictly forwards: ( 1 -> 1 + 2 -> 1 + 2 + 3 -> 1 + 2 + 3 + 4 -> 10 ). Sometimes the recursive solution is simpler than the iterative solution. This is evident when implementing a reversal of a linked list.
# Tree exploration with recursion
Say we have the following tree:
Now, if we wish to list all the names of the elements, we could do this with a simple for-loop. We assume there is a function get_name() to return a string of the name of a node, a function get_children() to return a list of all the sub-nodes of a given node in the tree, and a function get_root() to get the root node.
This works well and fast, but what if the sub-nodes, got sub-nodes of its own? And those sub-nodes might have more sub-nodes. What if you don’t know beforehand how many there will be? A method to solve this is the use of recursion.
Perhaps you wish to not print, but return a flat list of all node names. This can be done by passing a rolling list as a parameter.
# Increasing the Maximum Recursion Depth
There is a limit to the depth of possible recursion, which depends on the Python implementation. When the limit is reached, a RuntimeError exception is raised:
Here’s a sample of a program that would cause this error:
It is possible to change the recursion depth limit by using
You can check what the current parameters of the limit are by running:
Running the same method above with our new limit we get
From Python 3.5, the exception is a RecursionError, which is derived from RuntimeError.
# Tail Recursion — Bad Practice
When the only thing returned from a function is a recursive call, it is refered to as tail recursion.
Here’s an example countdown written using tail recursion:
Any computation that can be made using iteration can also be made using recursion. Here is a version of find_max written using tail recursion:
Tail recursion is considered a bad practice in Python, since the Python compiler does not handle optimization for tail recursive calls. The recursive solution in cases like this use more system resources than the equivalent iterative solution.
# Tail Recursion Optimization Through Stack Introspection
By default Python’s recursion stack cannot exceed 1000 frames. This can be changed by setting the sys.setrecursionlimit(15000) which is faster however, this method consumes more memory. Instead, we can also solve the Tail Recursion problem using stack introspection.
To optimize the recursive functions, we can use the @tail_call_optimized decorator to call our function. Here’s a few of the common recursion examples using the decorator described above:
# Remarks
Recursion needs a stop condition stopCondition in order to exit the recursion.
The original variable must be passed on to the recursive function so it becomes stored.
Как работает рекурсия функции: на примере Python
Итак, сегодня у нас не самая простая, но очень важная тема для тех, кто выбрал программирование как сферу деятельности. И в частности планирует или уже работает с языком программирования Python.
Речь идет о рекурсии функции!
Мы постараемся объяснить ее максимально простыми и понятными словами, чтобы даже новички могли на базовом уровне понять, что это, как работает и зачем используется.
Настоятельно рекомендуем статью к ознакомлению тем, кто выбрал для себя курс Wezom Академии «Основы Python с нуля до функционального проекта» и хочет глубже погрузиться в тему. Поэтому давайте без лишних предисловий приступим к рассмотрению.
Что такое рекурсия: быстрое напоминание
В программировании рекурсивной функцией называют ту функцию, которая способна вызывать себя из себя же , но с иными значениями параметров. Пока, возможно, сложно для понимания, поэтому давайте попытаемся рассмотреть эту тему на более простых и «бытовых» примерах.
Для начала предлагаем вам взглянуть на лист папоротника:
Есть одна большая ветка. По всей ее длине выходят такие же ветки, но меньшего размера. А из каждой такой ветки — еще меньшие ветки с очень похожей структурой. То есть, если представить большую ветку как функцию, мы увидим, что из нее выходят другие похожие функции, но с иными параметрами. В нашем случае — меньшего размера.
Еще один похожий пример — капуста романеско:
Вообще в природе таких примеров огромное множество. Даже ветки деревьев в некотором смысле можно сравнить с рекурсией функции. Также рекурсия нередко встречается в архитектуре, живописи, музыке и в других направлениях искусства. Рекурсия — это порядок и хаос одновременно.
Но как вообще листья папоротника или капуста романеско вяжется с программированием? Давайте разбираться!
Что такое рекурсия функции
Как мы и сказали, рекурсивная функция — это функция, которая вызывает саму себя.
Посмотрим на более «житейском» примере, как это может работать в программировании.
Представьте, что вам нужно попасть в гардеробную, которая закрыта на ключ. Рядом с гардеробной стоит коробка, на которой написано, что ключ внутри. Вы открываете коробку, а внутри лежат еще коробки. А в них — еще. Как вам действовать, чтобы максимально быстро найти нужную коробку с ключом?
По большому счету есть два алгоритма действий:
В первом случае применяется цикл while. То есть, вы берете коробку, открываете ее, затем следующую и так до того самого момента, пока не найдете нужную вам коробку с ключом. Это так называемый итерационный (пошаговый) метод. В Python он может выглядеть следующим образом:
Так как у нас стоит задача с повторяющимися действиями, но меняющимися параметрами, мы можем использовать рекурсивный метод. То есть, решить задачу, используя ее же саму:
В этом примере summa(1) — это 1, summa(2) — это 2 + summa(1) и так далее. Данный алгоритм проще будет понять на следующей схеме:
И тут необходимо указать важную деталь. По большому счету оба алгоритма выполняют одну и ту же задачу — ищут «коробку с ключом». Более того, в данном случае у рекурсивного метода не будет особенного преимущества над итерационным. Однако рекурсия функции гораздо лучше подходит для решения сложных многоуровневых задач. Это будет быстрее, проще и понятнее. Но что еще важнее — рекурсивные решения проще поддерживать.
Условия рекурсивных алгоритмов
Продолжим рассматривать наш пример с summa(n). Есть два важнейших требования, без соблюдения которых алгоритм не будет работать:
- Базовый случай
Обязательно необходимо задать четкое стоп-условие, которое остановит процесс и не даст ему выполняться бесконечно. То есть, такое стоп-условие помогает функции завершить работу. Это и называется базовым случаем в программировании. В нашем случае функция будет вызывать себя до тех пор, пока не найдет «коробку с ключом». Чем больше функция сделает при этом вызовов, тем больше глубина рекурсии.
- Рекурсия
Чтобы базовый случай в принципе состоялся, требуется передача измененных данных каждой новой вызванной функции. В нашем примере первый вызов n = 5, второй — 4 и так далее. И только когда n становится равным 1, рекурсия завершается.
Как работают рекурсивные алгоритмы
Что ж, теперь предлагаем немного отойти от наших бытовых примеров и переключиться непосредственно на программирование с Python.
Итак, есть «материнская» функция и «дочерняя». В тот момент, когда функция вызывает сама себя, действие «материнской» останавливается, а вместо нее начинается выполнение «дочерней».
Рассмотрим рекурсивную функцию на примере summa(5). В компьютере хранятся данные о функции в виде блока, в котором в свою очередь установлено значение переменной n и код, который выполняется. Наглядно это выглядит следующим образом:
При выполнении функции summa(5) начинает вызывать summa(4). В это же время формируется новый блок и размещается над предыдущим:
Так продолжается до тех пор, пока работает рекурсия функции. При этом как только начинает работать новый блок, остальные никак не задействуются и просто хранят имеющиеся данные. И так продолжается до того момента, когда рекурсия достигает базового случая:
Далее summa(1) возвращает единицу, завершает работу и выходит из стека. В верхней части остается summa(2):
Теперь уже summa(2) продолжает выполнение с того момента, на котором остановилась. За ней — summa(3) и так далее до самого завершения стека.
Вот тут, к слову, и кроется один важный недостаток (или скорее особенность) рекурсии функции в программировании. Дело в том, что пока рекурсивные функции выполняются, они хранят данные всех незавершенных функций, вследствие чего потребление памяти повышается.
И здесь важно вспомнить об особенности Python — ограничение стека в 1 000 вызовов. Если количество вызовов окажется больше, а вы попытаетесь добавить еще одну функцию, то получите соответствующую ошибку — «Переполнение стека». Об этом ограничении очень важно помнить, если вы работаете с Python в целом и с рекурсией функции в частности.
Зачем рекурсия нужна
Вот тут у вас может возникнуть логичный вопрос: «А нужно ли вообще использовать рекурсию функции в Python, если по сути того же результата можно достичь и итеративными алгоритмами?» . Вопрос абсолютно резонный!
В некоторых ситуациях циклы действительно оказываются проще и даже эффективнее рекурсии. При этом они тоже вполне могут работать с рекурсивными структурами данных. Более того, часто рекурсивные функции требуют больше места и памяти, нежели итеративные, ведь они постоянно добавляют новые слои в стек памяти. Однако есть нюанс — производительность рекурсивных функций на порядок выше.
На освоение рекурсивных функций требуется время и определенные усилия. И далеко не всегда удается их правильно реализовать. А некорректная реализация часто делает рекурсию довольно медленной по причине того, что вычисления производятся чаще, чем это на самом деле необходимо. Поэтому очень важно начинать практиковаться в реализации рекурсивных функций с максимально простых и даже примитивных задач, постепенно повышая сложность и вложенность.
С другой стороны, написание итеративных функций — это в большинстве случаев более громоздкий и сложный код. Взгляните, как выглядит итеративная функция для вычисления факториала (числа, умноженного на предыдущее число):