Виртуализация памяти. Классы виртуальной памяти
Виртуализация оперативной памяти осуществляется совокупностью аппаратных средств процессора и программных средств ОС и включает решение следующих задач:
· размещение данных (образов процессов или их частей) в запоминающих устройствах разного типа: частично — в оперативной памяти, частично — на диске;
· выбор образов процессов или их частей для перемещения из оперативной памяти на диск и обратно;
· перемещение данных между памятью и диском;
· преобразование виртуальных адресов в физические.
Решение этих задач осуществляется автоматически, без участия программиста, и не отображаются в логике работы приложений.
Виртуализация памяти может быть осуществлена на основе двух подходов — свопинга и механизма виртуальной памяти.
Свопинг (swapping). Между оперативной памятью и диском перемещаются образы процессов Более простой в реализации способ, чем виртуальная память. Однако обладает избыточностью при подкачке или выгрузке: часто для активизации процесса или освобождения памяти не требуется перемещение всего образа процесса. Избыточность приводит к замедлению работы системы и неэффективному использованию памяти. Кроме того, невозможно загрузить для выполнения процесс, виртуальное адресное пространство которого превышает имеющуюся в наличии свободную память.
Как основной механизм управления памятью в современных ОС почти не используется. В некоторых ОС, например, версиях Unix, основанных на коде SVR4, свопинг применяется как дополнительный к виртуальной памяти, включающийся только при серьезных перегрузках системы.
Виртуальная память (virtual memory). Между оперативной памятью и диском перемещаются части (сегменты, страницы — см. ниже) образов процессов.
В зависимости от способа структуризации виртуального адресного пространства, определяющего преобразование виртуальных адресов в физические, выделяется три класса виртуальной памяти.
· Страничное распределение. Единицей перемещения между памятью и диском является страница — часть виртуального адресного пространства фиксированного и небольшого объема.
· Сегментное распределение. Единицей перемещения между памятью и диском является сегмент — часть виртуального адресного пространства произвольного объема, содержащая осмысленную с некоторой точки зрения совокупность данных (подпрограмму, массив и т.д.).
· Сегментно-страничное распределение. Объединяет элементы предыдущих классов. Виртуальное адресное пространство структурируется иерархически: делится на сегменты, а затем сегменты делятся на страниц. Единицей перемещения между памятью и диском является страница.
Для временного хранения вытесненных на диск сегментов и страниц отводится либо специальная область, либо специальный файл, обычно называемые страничным файлом (page file, paging file) или, по традиции, файлом свопинга.
Текущий размер страничного файла влияет на возможности работы ОС следующим образом: чем больше файл, тем больше одновременно работающих приложений, но тем медленнее их работа из-за многократной перекачки перемещаемых элементов на диск и обратно.
Размер страничного файла в современных ОС является настраиваемым параметром, который выбирается администратором системы для достижения компромисса между числом одновременно выполняемых приложений и быстродействием системы. Этот размер устанавливается в панели управления, пункт «система», вкладка «дополнительно» — «параметры быстродействия».
Виртуализация памяти. Классы виртуальной памяти
средств процессора и программных средств ОС и включает решение следующих задач:
· размещение данных (образов процессов или их частей) в запоминающих устрой-
ствах разного типа: частично – в оперативной памяти, частично – на диске;
· выбор образов процессов или их частей для перемещения из оперативной памя-
ти на диск и обратно;
· перемещение данных между памятью и диском;
· преобразование виртуальных адресов в физические.
Решение этих задач осуществляется автоматически, без участия программиста, и
не отображаются в логике работы приложений.
· Виртуализация памяти может быть осуществлена на основе двух подходов –
свопинга и механизма виртуальной памяти.
Свопинг (swapping). Между оперативной памятью и диском перемещаются образы
процессов Более простой в реализации способ, чем виртуальная память. Однако обла-
дает избыточностью при подкачке или выгрузке: часто для активизации процесса или
освобождения памяти не требуется перемещение всего образа процесса. Избыточность
приводит к замедлению работы системы и неэффективному использованию памяти.
Кроме того, невозможно загрузить для выполнения процесс, виртуальное адресное про-
странство которого превышает имеющуюся в наличии свободную память.
Как основной механизм управления памятью в современных ОС почти не использует-
ся. В некоторых ОС, например, версиях Unix, основанных на коде SVR4, свопинг приме-
няется как дополнительный к виртуальной памяти, включающийся только при серьезных
Виртуальная память (virtual memory). Между оперативной памятью и диском пе-
ремещаются части (сегменты, страницы – см. ниже) образов процессов.
В зависимости от способа структуризации виртуального адресного пространства, опре-
деляющего преобразование виртуальных адресов в физические, выделяется три класса
· Страничное распределение. Единицей перемещения между памятью и диском
является страница – часть виртуального адресного пространства фиксированного и
· Сегментное распределение. Единицей перемещения между памятью и диском
является сегмент – часть виртуального адресного пространства произвольного объе-
ма, содержащая осмысленную с некоторой точки зрения совокупность данных (под-
программу, массив и т.д.).
· Сегментно-страничное распределение. Объединяет элементы предыдущих клас-
сов. Виртуальное адресное пространство структурируется иерархически: делится на сег-
менты, а затем сегменты делятся на страницы. Единицей перемещения между памятью
и диском является страница.
Для временного хранения вытесненных на диск сегментов и страниц отводится
либо специальная область, либо специальный файл, обычно называемые странич-
ным файлом (page file, paging file) или, по традиции, файлом свопинга.
Текущий размер страничного файла влияет на возможности работы ОС следую-
щим образом: чем больше файл, тем больше одновременно работающих приложе-
ний, но тем медленнее их работа из-за многократной перекачки перемещаемых эле-
ментов на диск и обратно.
Размер страничного файла в современных ОС является настраиваемым парамет-
ром, который выбирается администратором системы для достижения компромисса
между числом одновременно выполняемых приложений и быстродействием системы.
Этот размер устанавливается в панели управления, пункт «система», вкладка «до-
полнительно» – «параметры быстродействия».
Виртуальное адресное пространство каждого процесса делится на части одинако-
вого, фиксированного для данной системы размера, называемые виртуальными стра-
ницами (virtual pages). В общем случае размер виртуального адресного пространства
не является кратным размеру страницы, поэтому последняя страница каждого про-
цесса дополняется фиктивной областью.
Вся оперативная память машины также делится на части такого же размера, на-
зываемые физическими страницами (блоками, кадрами).
Для каждого процесса ОС создает таблицу страниц – информационную структу-
ру, содержащую записи обо всех виртуальных страницах процесса.
Схема страничного распределения памяти приведена на рис. 3.3.
При создании процесса его виртуальные страницы загружаются в оперативную па-
мять; в случае нехватки последней часть виртуальных страниц может быть вытесне-
на на диск. Смежные виртуальные страницы не обязательно располагаются в смежных
Кэширование данных
· Память вычислительной машины, представленная совокупностью запоминающих
устройств (ЗУ) различных видов, может быть иерархизирована по следующим основ-
· время доступа к данным;
· стоимость хранения данных в расчете на один бит.
Конкретные значения этих характеристик изменяются очень быстро, поэтому в
данном случае важны не столько их абсолютные значения, сколько соотношение для
разных типов запоминающих устройств. Иерархия ЗУ приведена на рис. 3.9.
Закономерность такова: чем больше быстродействие, тем больше стоимость хра-
нения данных в расчете на один бит и меньше объем устройства. Кэш-память пред-
ставляет некоторое компромиссное решение этой проблемы.
· Кэш-память (cache) – это способ организации совместного функционирования
двух типов запоминающих устройств, отличающихся временем доступа и стоимос-
тью хранения данных, который позволяет уменьшить среднее время доступа к дан-
ным за счет динамического копирования в “быстрое” ЗУ наиболее часто используе-
мой информации из “медленного” ЗУ.
Механизм кэш-памяти прозрачен для пользователя: все перемещения данных де-
лаются автоматически системными средствами.
Кэш-памятью часто называют не только способ организации работы двух типов
запоминающих устройств, но и одно из устройств – “быстрое” ЗУ. Оно стоит дороже
и, как правило, имеет сравнительно небольшой объем. Медленное ЗУ из этой пары
назовем основной памятью, быстрое представлено кэш-памятью.
· Кэширование – универсальный метод, пригодный для ускорения доступа к опе-
ративной памяти, к диску и другим видам ЗУ. Так, в качестве составляющих пары
«основная память – кэш-память» могут выступать: оперативная память – быстро-
действующая статическая память; система ввода-вывода – буферы в оперативной
памяти (или специальная кэш-память).
Рассмотрим одну из возможных схем кэширования.
Содержимое кэш-памяти представляет собой совокупность записей обо всех заг-
руженных в нее элементах данных из основной памяти. Каждая запись об элемен-
те данных включает в себя:
— значение элемента данных;
— адрес, который этот элемент данных имеет в основной памяти;
— управляющую информацию для реализации алгоритма замещения, обычно – признак
модификации и признак обращения к данным за некоторый последний период времени.
При каждом обращении к основной памяти по физическому адресу просматрива-
ется содержимое кэш-памяти с целью определения, не находятся ли там нужные дан-
ные. Поиск нужных данных осуществляется по содержимому – взятому из запроса
значению поля адреса в оперативной памяти. Далее возможно одно из двух:
· произошло кэш-попадание – данные обнаружены в кэш-памяти; они считываются
из кэш-памяти и результат передается источнику запроса;
· произошел кэш-промах (cache-miss) – нужных данных нет; они считываются из ос-
новной памяти, передаются источнику запроса и одновременно копируются в кэш-память.
Покажем, что среднее время доступа к данным зависит от вероятности попада-
Пусть имеется основное запоминающие устройство со средним временем доступа
к данным t1 и кэш-память, имеющая время доступа t2 (t2<t1). Обозначим через t сред-
нее время доступа к данным в системе с кэш-памятью, а через p -вероятность попа-
дания в кэш. По формуле полной вероятности имеем:
Видно, что среднее время доступа изменяется от среднего времени доступа в основ-
ное ЗУ (при р=0) до среднего времени доступа непосредственно в кэш-память (при р=1).
Таким образом, использование кэш-памяти имеет смысл только при высокой веро-
ятности кэш-попадания. Эта вероятность, в свою очередь, зависит от многих раз-
личных факторов. Тем не менее в реальных системах вероятность попадания в кэш
очень высока и составляет более 0.9. Такое высокое значение вероятности нахож-
дения данных в кэш-памяти связано с наличием у данных объективных свойств: про-
странственной и временной локальности.
Пространственная локальность. Если произошло обращение по некоторому ад-
ресу, то с высокой степенью вероятности в ближайшее время произойдет обращение к
Временная локальность. Если произошло обращение по некоторому адресу, то сле-
дующее обращение по этому же адресу с большой вероятностью произойдет в бли-
На практике в кэш-память считывается не один элемент данных, к которому про-
изошло обращение, а целый блок данных, что увеличивает вероятность попадания в
кэш при последующих обращениях.
· Вытеснение данных их кэша в основную память
В процессе работы содержимое кэш-памяти постоянно обновляется, а значит, пе-
риодически данные должны из нее вытесняться. Вытеснение предполагает объявле-
ние соответствующей области кэша свободной (сброс бита действительности) и, если
вытесняемые данные за время нахождения в кэше были изменены, копирование дан-
ных в основную память.
Методы выбора данных для вытеснения зависят от способа отображения основной
памяти на кэш и базируются на предположениях о свойствах данных. Реально как пра-
вило учитывается интенсивность обращения к данным. В некоторых алгоритмах заме-
щения предусматривается первоочередная выгрузка модифицированных данных.
Из-за непредсказуемости вычислительного процесса ни один алгоритм замещения
данных не может быть максимально быстрым и одновременно гарантировать макси-
мально возможную вероятность кэш-попаданий. Поэтому разработчики ограничивают-
ся рациональными решениями, по крайней мере, не сильно замедляющими работу кэша.
· Согласование данных кэша и основной памяти при записи в последнюю Проблема заключается в том, что при записи данных в основную память их копия в
КЭШе (если она там есть) становится недостоверной. Для решения этой проблемы типич-
Сквозная запись (write through). Если данные по запрашиваемому адресу отсут-
ствуют в кэше, то запись выполняется только в основную память, в противном слу-
чае – одновременно в кэш и основную память.
Обратная запись (write back). Если данные по запрашиваемому адресу отсут-
ствуют в кэше, то запись выполняется только в основную память, в противном слу-
чае – только в кэш-память. Во втором случае устанавливается признак модифика-
ции, указывающий на необходимость записи данных в основную память при вытес-
32. Понятие виртуальной памяти Виртуализация памяти
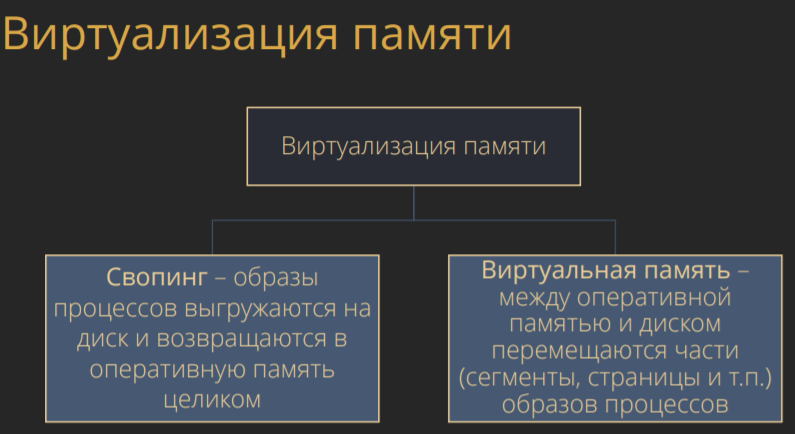
Виртуализация памяти может быть осуществлена на основе двух различных подходов:
свопинг (swapping) — образы процессов выгружаются на диск и возвращаются в оперативную память целиком;
виртуальная память (virtual memory) — между оперативной памятью и диском перемещаются части (сегменты, страницы и т. п.) образов процессов.
Свопинг представляет собой частный случай виртуальной памяти и, следовательно, более простой в реализации способ совместного использования оперативной памяти и диска. Однако подкачке свойственна избыточность. Перемещение избыточной информации замедляет работу системы, а также приводит к неэффективному использованию памяти. Кроме того, системы, поддерживающие свопинг, имеют еще один очень существенный недостаток: они не способны загрузить для выполнения процесс, виртуальное адресное пространство которого превышает имеющуюся в наличии свободную память. Именно из-за указанных недостатков свопинг как основной механизм управления памятью почти не используется в современных ОС.
На смену ему пришел более совершенный механизм виртуальной памяти, который заключается в том, что при нехватке места в оперативной памяти на диск выгружаются только части образов процессов. Ключевой проблемой виртуальной памяти, возникающей в результате многократного изменения местоположения в оперативной памяти образов процессов или их частей, является преобразование виртуальных адресов в физические. Решение этой проблемы, в свою очередь, зависит от того, какой способ структуризации виртуального адресного пространства принят в данной системе управления памятью.
Аппаратная поддержка очень важна (ниже)

Виртуальная память — это некоторый механизм совместного функционирования оперативной(основной) памяти и внешней памяти. Механизм виртуальной памяти достаточно громоздкий => за такими алгоритмами всегда стоят задержки и снижение производительности. Однако взамен мы можем отвязаться от реалий физической памяти (процессы работают с “иллюзией” использования физической памяти).
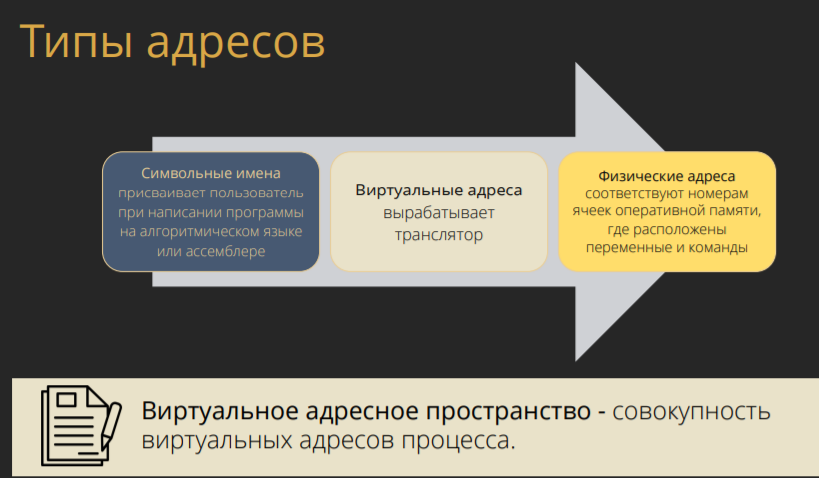
Виртуальное адресное пространство — совокупность виртуальных адресов процесса. И эта совокупность может превышать объем физической памяти.
. В конечном итоге обращение происходит по физическим адресам, и данные (инструкции) хранятся в физ. памяти.

Разные виртуальные адресные пространства отображаются на разные участки физической памяти и поэтому никакой путаницы не происходит.
Структура виртуального адресного пространства
1 подход: плоское виртуальное адресное пространство
весь набор вирт адресов линейны => чтобы добраться до нужного байта, надо знать только одно число. Т.Е. пронумеровали все байты, к байту обращаемся по его номеру и соответственно виртуальным адресом является одно число, символизирующее смещение от начала ВАП (виртуальное адресное пространство) до байта, к которому происходит обращение
2 подход: сегментированное ВАП: придумали следующую конструкцию, что адрес (тогда еще физический) будет храниться в двух компонентах адреса (сегмент и смещение). Сегментированное ВАП это совокупность (набор) сегментов, сегменты — это участки памяти (внутри сегментов байты пронумерованы последовательно. Здесь виртуальным адресом является пара чисел (сегмент и смещение внутри сегмента)
3 подход: гибрид плоского и сегментированного ВАП когда мы имеем в основе плоское ВАП (то есть у каждого байта в пределах ВАП есть свой линейный (последовательный) номер, а на это пространство (плоское) накладывают сегментацию. Появляется возможность один и тот же байт адресовать двумя способами: линейно или сегментировано
Есть два выбора, когда преобразовать виртуальные адреса в физические(ниже рисунок)

Кажется, что лучше использовать перемещающий загрузчик (чтобы экономить время), однако образ процесса может изменять свое местоположение и тогда такой подход не годится.
Организация виртуальной памяти
 Привет, Хабрахабр!
В предыдущей статье я рассказал про vfork() и пообещал рассказать о реализации вызова fork() как с поддержкой MMU, так и без неё (последняя, само собой, со значительными ограничениями). Но прежде, чем перейти к подробностям, будет логичнее начать с устройства виртуальной памяти.
Конечно, многие слышали про MMU, страничные таблицы и TLB. К сожалению, материалы на эту тему обычно рассматривают аппаратную сторону этого механизма, упоминая механизмы ОС только в общих чертах. Я же хочу разобрать конкретную программную реализацию в проекте Embox. Это лишь один из возможных подходов, и он достаточно лёгок для понимания. Кроме того, это не музейный экспонат, и при желании можно залезть “под капот” ОС и попробовать что-нибудь поменять.
Введение
Любая программная система имеет логическую модель памяти. Самая простая из них — совпадающая с физической, когда все программы имеют прямой доступ ко всему адресному пространству.
При таком подходе программы имеют доступ ко всему адресному пространству, не только могут “мешать” друг другу, но и способны привести к сбою работы всей системы — для этого достаточно, например, затереть кусок памяти, в котором располагается код ОС. Кроме того, иногда физической памяти может просто не хватить для того, чтобы все нужные процессы могли работать одновременно. Виртуальная память — один из механизмов, позволяющих решить эти проблемы. В данной статье рассматривается работа с этим механизмом со стороны операционной системы на примере ОС Embox. Все функции и типы данных, упомянутые в статье, вы можете найти в исходном коде нашего проекта.
Будет приведён ряд листингов, и некоторые из них слишком громоздки для размещения в статье в оригинальном виде, поэтому по возможности они будут сокращены и адаптированы. Также в тексте будут возникать отсылки к функциям и структурам, не имеющим прямого отношения к тематике статьи. Для них будет дано краткое описание, а более полную информацию о реализации можно найти на вики проекта.
Общие идеи
- Расширение реального адресного пространства. Часть виртуальной памяти может быть вытеснена на жёсткий диск, и это позволяет программам использовать больше оперативной памяти, чем есть на самом деле.
- Создание изолированных адресных пространств для различных процессов, что повышает безопасность системы, а также решает проблему привязанности программы к определённым адресам памяти.
- Задание различных свойств для разных участков участков памяти. Например, может существовать неизменяемый участок памяти, видный нескольким процессам.
Аппаратная поддержка
Обращение к памяти хорошо описанно в этой хабростатье. Происходит оно следующим образом:
Таким образом, при обращении программы к тому или иному участку памяти трансляция адресов производится аппаратно. Программная часть работы с MMU — формирование таблиц страниц и работа с ними, распределение участков памяти, установка тех или иных флагов для страниц, а также обработка page fault, ошибки, которая происходит при отсутствии страницы в отображении.
В тексте статьи в основном будет рассматриваться трёхуровневая модель памяти, но это не является принципиальным ограничением: для получения модели с бóльшим количеством уровней можно действовать аналогичным образом, а особенности работы с меньшим количеством уровней (как, например, в архитектуре x86 — там всего два уровня) будут рассмотрены отдельно.
Программная поддержка
- Выделение физических страниц из некоторого зарезервированного участка памяти
- Внесение соответствующих изменений в таблицы виртуальной памяти
- Сопоставление участков виртуальной памяти с процессами, выделившими их
- Проецирование региона физической памяти на виртуальный адрес
Виртуальный адрес
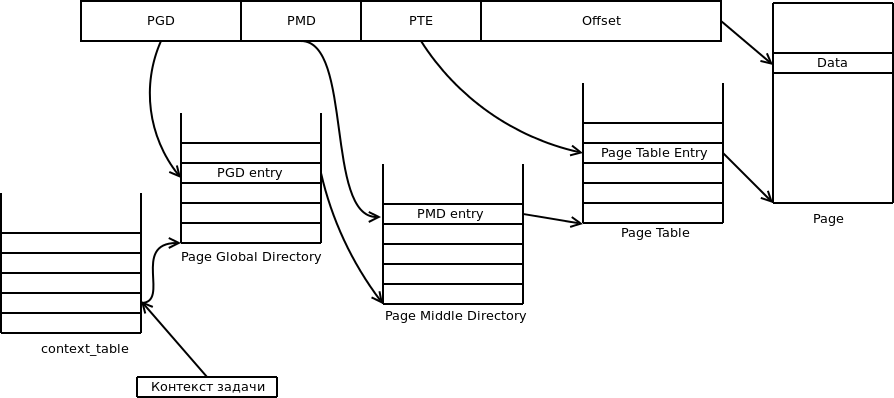
Page Global Directory (далее — PGD) — таблица (здесь и далее — то же самое, что директория) самого высокого уровня, каждая запись в ней — ссылка на Page Middle Directory (PMD), записи которой, в свою очередь, ссылаются на таблицу Page Table Entry (PTE). Записи в PTE ссылаются на реальные физические адреса, а также хранят флаги состояния страницы.
То есть, при трёхуровневой иерархии памяти виртуальный адрес будет выглядеть так: 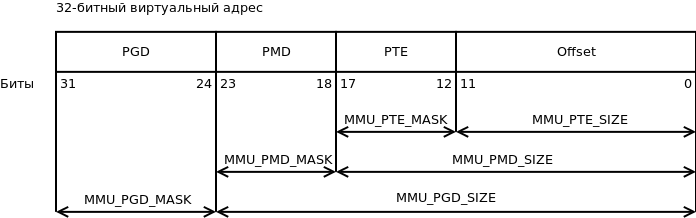
Значения полей PGD, PMD и PTE — это индексы в соответствующих таблицах (то есть сдвиги от начала этих таблиц), а offset — это смещение адреса от начала страницы.
В зависимости от архитектуры и режима страничной адресации, количество битов, выделяемых для каждого из полей, может отличаться. Кроме того, сама страничная иерархия может иметь число уровней, отличное от трёх: например, на x86 нет PMD.
Для обеспечения переносимости мы задали границы этих полей с помощью констант: MMU_PGD_SHIFT, MMU_PMD_SHIFT, MMU_PTE_SHIFT, которые в приведённой выше схеме равны 24, 18 и 12 соответственно их определение дано в заголовочном файле src/include/hal/mmu.h. В дальнейшем будет рассматриваться именно этот пример.
На основании сдвигов PGD, PMD и PTE вычисляются соответствующие маски адресов.
Эти макросы даны в том же заголовочном файле.
Для работы с виртуальной таблицами виртуальной памяти в некоторой области памяти хранятся указатели на все PGD. При этом каждая задача хранит в себе контекст struct mmu_context, который, по сути, является индексом в этой таблице. Таким образом, к каждой задаче относится одна таблица PGD, которую можно определить с помощью mmu_get_root(ctx).
Страницы и работа с ними
Размер страницы
В реальных (то есть не в учебных) системах используются страницы от 512 байт до 64 килобайт. Чаще всего размер страницы определяется архитектурой и является фиксированным для всей системы, например — 4 KiB.
С одной стороны, при меньшем размере страницы память меньше фрагментируется. Ведь наименьшая единица виртуальной памяти, которая может быть выделена процессу — это одна страница, а программам очень редко требуется целое число страниц. А значит, в последней странице, которую запросил процесс, скорее всего останется неиспользуемая память, которая, тем не менее, будет выделена, а значит — использована неэффективно.
С другой стороны, чем меньше размер страницы, тем больше размер страничных таблиц. Более того, при отгрузке на HDD и при чтении страниц с HDD быстрее получится записать несколько больших страниц, чем много маленьких такого же суммарного размера.
Отдельного внимания заслуживают так называемые большие страницы: huge pages и large pages [вики] .
| Платформа | Размер обычной страницы | Размер страницы максимально возможного размера |
| x86 | 4KB | 4MB |
| x86_64 | 4KB | 1GB |
| IA-64 | 4KB | 256MB |
| PPC | 4KB | 16GB |
| SPARC | 8KB | 2GB |
| ARMv7 | 4KB | 16MB |
Действительно, при использовании таких страниц накладные расходы памяти повышаются. Тем не менее, прирост производительности программ в некоторых случаях может доходить до 10% [ссылка] , что объясняется меньшим размером страничных директорий и более эффективной работой TLB.
В дальнейшем речь пойдёт о страницах обычного размера.
Устройство Page Table Entry
В реализации проекта Embox тип mmu_pte_t — это указатель.
Каждая запись PTE должна ссылаться на некоторую физическую страницу, а каждая физическая страница должна быть адресована какой-то записью PTE. Таким образом, в mmu_pte_t незанятыми остаются MMU_PTE_SHIFT бит, которые можно использовать для сохранения состояния страницы. Конкретный адрес бита, отвечающего за тот или иной флаг, как и набор флагов в целом, зависит от архитектуры.
- MMU_PAGE_WRITABLE — Можно ли менять страницу
- MMU_PAGE_SUPERVISOR — Пространство супер-пользователя/пользователя
- MMU_PAGE_CACHEABLE — Нужно ли кэшировать
- MMU_PAGE_PRESENT — Используется ли данная запись директории
Можно установить сразу несколько флагов:
Здесь vmem_page_flags_t — 32-битное значение, и соответствующие флаги берутся из первых MMU_PTE_SHIFT бит.
Трансляция виртуального адреса в физический
Как уже писалось выше, при обращении к памяти трансляция адресов производится аппаратно, однако, явный доступ к физическим адресам может быть полезен в ряде случаев. Принцип поиска нужного участка памяти, конечно, такой же, как и в MMU.
Для того, чтобы получить из виртуального адреса физический, необходимо пройти по цепочке таблиц PGD, PMD и PTE. Функция vmem_translate() и производит эти шаги.
Сначала проверяется, есть ли в PGD указатель на директорию PMD. Если это так, то вычисляется адрес PMD, а затем аналогичным образом находится PTE. После выделения физического адреса страницы из PTE необходимо добавить смещение, и после этого будет получен искомый физический адрес.
Пояснения к коду функции.
mmu_paddr_t — это физический адрес страницы, назначение mmu_ctx_t уже обсуждалось выше в разделе “Виртуальный адрес”.
С помощью функции vmem_get_idx_from_vaddr() находятся сдвиги в таблицах PGD, PMD и PTE.
Работа с Page Table Entry
Для работы с записей в таблице страниц, а так же с самими таблицами, есть ряд функций:
Эти функции возвращают 1, если у соответствующей структуры установлен бит MMU_PAGE_PRESENT
Page Fault
Page fault — это исключение, возникающее при обращении к странице, которая не загружена в физическую память — или потому, что она была вытеснена, или потому, что не была выделена.
В операционных системах общего назначения при обработке этого исключения происходит поиск нужной странице на внешнем носителе (жёстком диске, к примеру).
В нашей системе все страницы, к которым процесс имеет доступ, считаются присутствующими в оперативной памяти. Так, например, соответствующие сегменты .text, .data, .bss; куча; и так далее отображаются в таблицы при инициализации процесса. Данные, связанные с потоками (например, стэк), отображаются в таблицы процесса при создании потоков.
Выталкивание страниц во внешнюю память и их чтение в случае page fault не реализовано. С одной стороны, это лишает возможности использовать больше физической памяти, чем имеется на самом деле, а с другой — не является актуальной проблемой для встраиваемых систем. Нет никаких ограничений, делающих невозможной реализацию данного механизма, и при желании читатель может попробовать себя в этом деле 🙂
Выделение памяти
Для виртуальных страниц и для физических страниц, которые могут быть использованы при работе с виртуальной памятью, статически резервируется некоторое место в оперативной памяти. Тогда при выделении новых страниц и директорий они будут браться именно из этого места.
Исключением является набор указателей на PGD для каждого процесса (MMU-контексты процессов): этот массив хранится отдельно и используется при создании и разрушении процесса.
Выделение страниц
Итак, выделить физическую страницу можно с помощью vmem_alloc_page
Функция page_alloc() ищет участок памяти из N незанятых страниц и возвращает физический адрес начала этого участка, помечая его как занятый. В приведённом коде virt_page_allocator ссылается на участок памяти, резервированной для выделения физических страниц, а 1 — количество необходимых страниц.
Выделение таблиц
Тип таблицы (PGD, PMD, PTE) не имеет значения при аллокации. Более того, выделение таблиц производится также с помощью функции page_alloc(), только с другим аллокатором (virt_table_allocator).
Участки памяти (Memory Area)
После добавления страниц в соответствующие таблицы нужно уметь сопоставлять участки памяти с процессами, к которым они относятся. У нас в системе процесс представлен структурой task, содержащей всю необходимую информацию для работы ОС с процессом. Все физически доступные участки адресного пространства процесса записываются в специальный репозиторий: task_mmap. Он представляет из себя список дескрипторов этих участков (регионов), которые могут быть отображены на виртуальную память, если включена соответствующая поддержка.
brk — это самый большой из всех физических адресов репозитория, данное значение необходимо для ряда системных вызовов, которые не будут рассматриваться в данной статье.
ctx — это контекст задачи, использование которого обсуждалось в разделе “Виртуальный адрес”.
struct dlist_head — это указатель на начало двусвязного списка, организация которого аналогична организации Linux Linked List.
За каждый выделенный участок памяти отвечает структура marea
Поля данной структуры имеют говорящие имена: адреса начала и конца данного участка памяти, флаги региона памяти. Поле mmap_link нужно для поддержания двусвязного списка, о котором говорилось выше.
Отображение виртуальных участков памяти на физические (Mapping)
Ранее уже рассказывалось о том, как происходит выделение физических страниц, какие данные о виртуальной памяти относятся к задаче, и теперь всё готово для того, чтобы говорить о непосредственном отображении виртуальных участков памяти на физические.
Отображение виртуальных участков памяти на физическую память подразумевает внесение соответствующих изменений в иерархию страничных директорий.
Подразумевается, что некоторый участок физической памяти уже выделен. Для того, чтобы выделить соответствующие виртуальные страницы и привязать их к физическим, используется функция vmem_map_region()
В качестве параметров передаётся контекст задачи, адрес начала физического участка памяти, а также адрес начала виртуального участка. Переменная flags содержит флаги, которые будут установлены у соответствующих записей в PTE.
Основную работу на себя берёт do_map_region(). Она возвращает 0 при удачном выполнении и код ошибки — в ином случае. Если во время маппирования произошла ошибка, то часть страниц, которые успели выделиться, нужно откатить сделанные изменения с помощью функции vmem_unmap_region(), которая будет рассмотрена позднее.
Рассмотрим функцию do_map_region() подробнее.
Макросы GET_PTE и GET_PMD нужны для лучшей читаемости кода. Они делают следующее: если в таблице памяти нужный нам указатель не ссылается на существующую запись, нужно выделить её, если нет — то просто перейти по указателю к следующей записи.
В самом начале необходимо проверить, выровнены ли под размер страницы размер региона, физический и виртуальный адреса. После этого определяется PGD, соответствующая указанному контексту, и извлекаются сдвиги из виртуального адреса (более подробно это уже обсуждалось выше).
Затем последовательно перебираются виртуальные адреса, и в соответствующих записях PTE к ним привязывается нужный физический адрес. Если в таблицах отсутствуют какие-то записи, то они будут автоматически сгенерированы при вызове вышеупомянутых макросов GET_PTE и GET_PMD.
Освобождение виртуального участка памяти (Unmapping)
После того, как участок виртуальной памяти был отображён на физическую, рано или поздно её придётся освободить: либо в случае ошибки, либо в случае завершения работы процесса.
Изменения, которые при этом необходимо внести в структуру страничной иерархии памяти, производятся с помощью функции vmem_unmap_region().
Все параметры функции, кроме последнего, должны быть уже знакомы. free_pages отвечает за то, должны ли быть удалены страничные записи из таблиц.
try_free_pte, try_free_pmd, try_free_pgd — это вспомогательные функции. При удалении очередной страницы может выясниться, что директория, её содержащая, могла стать пустой, а значит, её нужно удалить из памяти.
нужны как раз для случая двухуровневой иерархии памяти.
Заключение
Конечно, данной статьи не достаточно, чтобы с нуля организовать работу с MMU, но, я надеюсь, она хоть немного поможет погрузиться в OSDev тем, кому он кажется слишком сложным.