Какая частота дискретизации звука лучше:
как выбрать нужные ГЦ?
 5.0 Оценок: 3 (Ваша: )
Выбор эксперта: топ виртуальных
генераторов звуковых частот
-
| Звуковой редактор с тонгенератором.
Частота дискретизации — одна из основных характеристик цифрового звука. Разобраться, что означает этот параметр, важно аудиофилам и начинающим музыкантам. Мы расскажем, какая частота дискретизации лучше, и объясним, на что она влияет.
Какие бывают звуковые частоты?
Каждый звук характеризуется частотой — количеством колебаний волны за 1 секунду. Именно это значение определяет, слышим мы комариный писк, утробный гул или более сложные сочетания, которые, например, характерны для вокала и музыкальных инструментов.
В идеальной ситуации человеческое ухо воспринимает (слышит) звуки в диапазоне от 16 Гц до 20 кГц. В реальности диапазон более узкий. К тому же он может меняться с возрастом, после перенесенных болезней и даже в зависимости от самочувствия в определенный момент.
В музыкальном производстве и в аудиоаппаратуре указанный диапазон разделяется на 3 поддиапазона частот:
- Низкие (НЧ) — до 200 Гц.
- Средние (СЧ) — от 200 Гц до 5 кГц.
- Высокие (ВЧ) — от 5 кГц.
Встречается и более подробное деление, например на низкие басы и верхние басы низкие средние, средние средние и верхние средние, низкие высокие и верхние высокие.
На что влияет амплитудно-частотная характеристика?
Частота определяет тональность, тогда как за громкость отвечает амплитуда волны, которая исчисляется в децибелах (дБ). В действительности у всех звуков бесконечно широкий частотный спектр. Это происходит даже в тех случаях, когда они создаются генератором звуковых частот. Дополнительные значения выше и ниже по спектру возникают при воспроизведении.
Взаимосвязь амплитуды и частоты называется амплитудно-частотной характеристикой (АЧХ). Обычно ее изображают в виде графика.

Пример графика амплитудно-частотной характеристики
На графике видно, что звуки сохраняются даже за границами слышимого диапазона (обозначен красным). То есть мы можем просто не воспринимать звук, но по факту он еще звучит. Амплитуда — относительная характеристика, полного затухания не происходит. Колебания волн можно выявить лабораторным оборудованием.
Когда говорят об АЧХ, подразумевают диапазон, в котором звук более выражен. Например для большого барабана это 100-250 Гц, для скрипки — 180-3500 Гц, баритона — 110-392 Гц, сопрано — 262-1046 Гц. Их звучание можно подчеркнуть правильной настройкой эквалайзера.
Большое значение имеет АЧХ звуковой карты (аудиоинтерфейса), микрофона, колонок (мониторов), наушников и других устройств, которые сами по себе не генерируют звук. Они должны охватывать весь полезный спектр. В противном случае часть звуков не будет записываться (воспроизводиться).
График АЧХ звукозаписывающего и звуковоспроизводящего оборудования должен быть относительно ровным (идеальная линия возможна не всегда). Иначе сами устройства будут добавлять искажения. Чтобы улучшить АЧХ, рабочий диапазон расширяют, например от 10 Гц до 40 кГц (подобные значения можно увидеть в характеристиках устройств). Благодаря этому в слышимом спектре график — более ровный, а звучание — более качественное.
Чем отличается аналоговый сигнал от цифрового?
Звуковые волны относительно легко сохраняются и преобразуются в аналоговой аппаратуре. Конкретные частоты определяются глубиной канавки на пластинке или интенсивностью магнитного поля ленты (в кассетах и бобинах). Механические колебания и магнитное излучение преобразуются в электрические импульсы, которые усиливаются и передаются на диффузор (мембрану) динамиков или наушников. Колебания диффузора в свою очередь создают звуковые волны.
Принципиально иная ситуация с цифровой аппаратурой. Она хранит информацию в виде последовательности нулей и единиц, где 1 — это наличие электрического напряжения, а 0 — его отсутствие. Чтобы преобразовать песню или голос в поток данных, нужен специальный алгоритм. Он определенным образом разложит весь частотный спектр на единицы и нули, а также выделит блоки данных, которые будут отвечать за амплитуду.
Теорема Котельникова: зачем ее знать при работе со звуком?
Принцип, по которому звуковые колебания можно представить в цифровом виде, был предложен В.А. Котельниковым. В основе этого принципа лежит математическая модель. В зарубежных источниках используются названия «теорема отсчетов» и «теорема Найквиста-Шеннона».
По Котельникову, частота дискретизации должна минимум в 2 раза превышать наивысшую частоту полезного сигнала. В противном случае будет происходить потеря информации и наложение звуков. На слух это воспринимается как различного рода искажения (артефакты).
Как уже говорилось, все звуки фактически имеют бесконечный спектр. К тому же при расчетах неизбежно происходит округление значений. Поэтому при текущем уровне технологий идеальная оцифровка звука невозможна. Чтобы компенсировать потерю и искажение данных, частота дискретизации должна иметь некоторый запас. Например, по стандарту, для звуковых компакт-дисков (Audio CD) параметр составляет 44100 Гц. Максимальная частота для восприятия человеческим ухом — 20000 Гц. 44100 : 2 — 20000 = 2050 Гц (запас значений).
Сэмплы и битрейты
Частота дискретизации также называется сэмплрейтом (Sample Rate) и указывает на периодичность выборки данных в течение 1 секунды. За объем информации (количество бит), который можно передать за 1 секунду отвечает битрейт. Параметры влияют на точность кодирования, но не зависят друг от друга.
Чем точнее кодирование (лучше качество), тем выше объем пересылаемых данных. Лимит, устанавливаемый битрейтом, заставляет кодек не оцифровывать определенные части сигнала. Чем ниже битрейт, тем хуже качество.
Возможно 3 варианта битрейта:
- Постоянный — не меняется на протяжении всей аудиозаписи. Можно точно определить конечный размер файла, но выделяемые ресурсы не всегда расходуются оптимально.
- Переменный — алгоритм повышает или понижает параметр, исходя из определенных условий. Например устанавливает низкий для фрагментов с более ровной АЧХ и высокий — для динамичных эпизодов. Ресурсы расходуются более оптимально, но предсказать размер файла невозможно.
- Усредненный — может меняться в заданных пределах. Частично компенсирует недостатки других разновидностей — можно рассчитать примерный размер файла и более рационально распределять ресурсы.
Максимальные и минимальные значения битрейта и сэмплрейта зависят от возможностей оборудования, а также ограничиваются требованиями конкретного аудиоформата. Например для MP3 допустим битрейт 8-320 кбит/с, а сэмплрейт — 8000-48000 Гц.
Какую частоту дискретизации используют в музыке?
Вопрос, какая частота дискретизация считается стандартной для музыки, не имеет однозначного ответа. Нижняя граница устанавливается в 44100 Гц, что соответствует CD-качеству. При этом большинство не заметит искажений.
Некоторые потоковые сервисы переходят на 48000 Гц. Это стандарт для DVD и DAT (профессиональный формат цифровой записи на магнитную ленту, сейчас используется редко). Однако даже на качественной аппаратуре не все пользователи смогут услышать разницу.
В профессиональной среде могут использоваться сэмплрейты 96000 и 192000 Гц. С такими параметрами сохраняются оригинальные студийные записи. В дальнейшем они конвертируются под требования конкретных носителей и форматов. Эти же значения поддерживаются DVD-аудио и Blu-ray.
В чем отличие частоты дискретизации в музыке и видео?
Дискретизация в видео может быть больше, чем в музыке. В звуке в кино допускается много деталей — фоновая мелодия, голос, щелчки, пение птиц и так далее. Всё это должно звучать воедино. В музыке всё проще: есть голос и музыка, без особенных дополнений и сложного фона (бэк-вокал, например, — тоже голос). Поэтому частота дискретизации в музыке ниже, чем при кодировании видеоданных. Для оцифровки видео применяются другие алгоритмы, а сэмплрейт учитывают преимущественно при разработке и настройке оборудования.
Почему высокие частоты дискретизации — это плохо?
Определяясь с тем, какую частоту дискретизации выбрать для музыки, стоит учитывать возможности оборудования (своего и потенциального слушателя), требования носителя и платформы, а также цели, для которых создается трек. Сэмплрейт от 96 КГц и выше оправдан для записи сложных инструментальных и вокальных компазиций (оперы или симфонии) в DAW-программах. Однако после параметр все равно будет снижен до 48 или 44,1 КГц.
- Сэмплрейт влияет на размер файла.
- Обработка данных требует вычислительных мощностей. Чем выше сэмплрейт, тем сильнее нагружается компьютер или смартфон. Воспроизведение файлов с 44,1 и 48 КГц не вызывает проблем. При более высоком параметре устройство может зависнуть.
- Сэмплрейт должен поддерживаться аудиочипом. 44,1 КГц предусматриваются всегда. Некоторые устройства из нижнего ценового сегмента также могут обрабатывать 48 КГц. Если значение не поддерживается, параллельно с воспроизведением аудиоданные кодируются с оптимальными (для конкретного устройства) характеристиками, что сильнее нагружает систему и может приводить к ошибкам.
- Конвертация не повышает качество. Если взять файл с 44,1 КГц и преобразовать его в аудиозапись с 96 КГц, звучание не меняется.
- Многие слушатели используют дешевое оборудование, которое их полностью устраивает. Гарнитура смартфона не всегда способна продемонстрировать разницу между низким и высоким битрейтом и ошибки в мастеринге. Даже люди с идеальным слухом на качественном оборудовании иногда не могут оценить преимущества сэмплрейта больше 48 КГц.
Как изменить частоты дискретизации в песне?
После того как вы определились, какая лучше частота дискретизации звука для музыки, может потребоваться конвертация файл с новыми значениями. Для этого пригодится звуковой редактор, например АудиоМАСТЕР.
АудиоМАСТЕР
Приложение поддерживает сэмплрейт от 8000 до 192000 Гц. Однако допустимые параметры определяются конкретным форматом. Например, для WAV это 8000-96000 Гц, а для AAC — 16000-64000 Гц.
Запустите редактор и импортируйте в него нужный файл. Можно воспользоваться кнопкой «Открыть файл» или перетащить аудиозапись в окно программы.
В меню «Файл» выберите «Сохранить как…».
Укажите формат, битрейт, дискретизацию, разрядность (графа «Четкость») и другие нужные характеристики. Нажмите «Сохранить», чтобы применить изменения. Затем введите имя файла и выберите папку для экспорта.
Итоги
Мы рассказали, что такое сэмплрейт и на что он влияет. Теперь вы знаете, какая лучше частота дискретизации звука для наушников смартфона и насколько целесообразны высокие характеристики.
Наиболее распространенными значениями являются 44100 и 48000 Гц. Они поддерживаются популярными кодеками и современными аудиочипами в компьютерах и гаджетах. Более высокие параметры (от 96 КГц) используются в крупных студиях, например при записи симфонической музыки. Однако в дальнейшем сэмплрейт все равно снижается при производстве CD и подготовке аудиофайлов для потоковых сервисов.
Часто задаваемые вопросы:
Это объем информации (количество бит), которое выделяется на хранение каждого сэмпла. Наиболее распространенное значение — 16.
Это одно и то же. В англоязычных материалах вместо «дискретизации» используется термин «sampling», что и переводится как «сэмплирование».
Специальная программа или микросхема для преобразования аналогового сигнала в поток данных и наоборот — аналого-цифрового (АЦП) и цифро-аналогового (ЦАП) преобразования.
Что такое Дискретизация

Всем привет! С вами снова я и сегодня мы поговорим о частоте дискретизации, что же это такое? Для начала хотелось бы сказать, что такое звук. Звук представляет собой непрерывный сигнал — звуковую волну с меняющейся амплитудой и частотой. Чем больше амплитуда сигнала, тем он громче для человека (смотрите рисунок 1). Чем больше частота сигнала, тем выше тон. Частота звуковой волны выражается числом колебаний в секунду и измеряется в герцах (Гц, Hz). Человеческое ухо способно воспринимать звуки в диапазоне от 20 Гц до 20 кГц, который называют звуковым. (Рис.1)
Глубина кодирования звука — количество бит, отводимое на один звуковой сигнал. Частота звуковой волны выражается числом колебаний в секунду и измеряется в герцах (Гц, Hz). Человеческое ухо способно воспринимать звуки в диапазоне от 20 Гц до 20 кГц, который называют звуковым. Глубина кодирования звука — количество бит, отводимое на один звуковой сигнал (Современные звуковые карты обеспечивают 16 -, 32 — или 64 -битную глубину кодирования звука). При кодировании звуковой информации непрерывный сигнал заменяется дискретным, то есть превращается в последовательность электрических импульсов (двоичных нулей и единиц). Дискретизация (Оцифровка) — процесс перевода звуковых сигналов от непрерывной формы представления к дискретной, цифровой форме, то есть перевод вашей записи, записанной в живую, на цифровой носитель. Важной характеристикой при кодировании звука является Частота Дискретизации — количество измерений уровней сигнала за 1 секунду: — 1 (одно) измерение в секунду соответствует частоте 1 Гц; — 1000 измерений в секунду соответствует частоте 1 кГц. Частота дискретизации звука — это количество измерений громкости звука за одну секунду. Количество измерений может лежать в диапазоне от 8 кГц до 48 кГц (от частоты радиотрансляции до частоты, соответствующей качеству звучания музыкальных носителей). (Рис.2)
— На вертикальной линии(это Y) находится глубина битности, а на горизонтальной линии (это X) частота дискритизации. Чем больше частота и глубина дискретизации звука, тем более качественным будет звучание оцифрованного звука (смотрите рисунок 3). Самое низкое качество оцифрованного звука, соответствующее качеству телефонной связи, получается при частоте дискретизации 8000 раз в секунду, глубине дискретизации 8 битов и записи одной звуковой дорожки (режим «моно»). Самое высокое качество оцифрованного звука, соответствующее качеству аудио-CD, достигается при частоте дискретизации 48000 раз в секунду, глубине дискретизации 16 битов и записи двух звуковых дорожек (режим «стерео»). Необходимо помнить, что чем выше качество цифрового звука, тем больше информационный объем звукового файла. Оценить информационный объём моноаудиофайла ( V ) можно следующим образом: V = N⋅f⋅k , где N — общая длительность звучания (секунд), f — частота дискретизации (Гц), k — глубина кодирования (бит). (Рис.3)
Например, при длительности звучания 1 минуту и среднем качестве звука ( 16 бит, 24 кГц): V = 60⋅24000⋅16 бит = 23040000 бит = 2880000 байт = 2812,5 Кбайт = 2,75 Мбайт. При кодировании стереозвука процесс дискретизации производится отдельно и независимо для левого и правого каналов, что, соответственно, увеличивает объём звукового файла в два раза по сравнению с монозвуком. Например, оценим информационный объём цифрового стереозвукового файла длительностью звучания 1 секунда при среднем качестве звука ( 16 битов, 24000 измерений в секунду). Для этого глубину кодирования необходимо умножить на количество измерений в 1 секунду и умножить на 2 (стереозвук): V=16 бит ⋅24000⋅2 = 768000 бит = 96000 байт = 93,75 Кбайт. Существуют различные методы кодирования звуковой информации двоичным кодом, среди которых можно выделить два основных направления: метод FM и метод Wave-Table. Метод FM (Frequency Modulation) основан на том, что теоретически любой сложный звук можно разложить на последовательность простейших гармонических сигналов разных частот, каждый из которых представляет собой правильную синусоиду, и, следовательно, может быть описан кодом. Разложение звуковых сигналов в гармонические ряды и представление в виде дискретных цифровых сигналов выполняют специальные устройства — аналогово-цифровые преобразователи (АЦП). (Рис.4)
Преобразование звукового сигнала в дискретный сигнал: а — звуковой сигнал на входе АЦП; б — дискретный сигнал на выходе АЦП. Обратное преобразование для воспроизведения звука, закодированного числовым кодом, выполняют цифро-аналоговые преобразователи (ЦАП). Процесс преобразования звука представлен на рисунке 5. Данный метод кодирования не даёт хорошего качества звучания, но обеспечивает компактный код. (Рис.5)
Преобразование дискретного сигнала в звуковой сигнал: а — дискретный сигнал на входе ЦАП; б — звуковой сигнал на выходе ЦАП. Таблично-волновой метод (Wave-Table) основан на том, что в заранее подготовленных таблицах хранятся образцы звуков окружающего мира, музыкальных инструментов и т. д. Числовые коды выражают высоту тона, продолжительность и интенсивность звука и прочие параметры, характеризующие особенности звука. Поскольку в качестве образцов используются «реальные» звуки, качество звука, полученного в результате синтеза, получается очень высоким и приближается к качеству звучания реальных музыкальных инструментов. Звуковые файлы имеют несколько форматов. Наиболее популярные из них MIDI, WAV, МРЗ: — Формат MIDI (Musical Instrument Digital Interface) изначально был предназначен для управления музыкальными инструментами. В настоящее время используется в области электронных музыкальных инструментов и компьютерных модулей синтеза. — Формат аудиофайла WAV (waveform) представляет произвольный звук в виде цифрового представления исходного звукового колебания или звуковой волны (то есть максимальное качество исходного звука). Все стандартные звуки Windows имеют расширение WAV. — Формат МРЗ (MPEG-1 Audio Layer 3) — один из цифровых форматов хранения звуковой информации. Он обеспечивает более высокое качество кодирования. Таким образом, можно спокойно писать музыку с частотой дискретизации 48 кГц, так как это формат качество для CD дисков, нет особой надобности писать музыку в форматах больше 48 кГц, хотя при сохранении всего материала в конечном итоге, частота десритизации может повлиять на конечное качество звука. Поэтому важно смотреть свой проект как в 41 кГц, так и других, больше этого значения для выявления лучшего варианта.
Цифровое представление аналогового аудиосигнала. Краткий ликбез
Дорогие читатели, меня зовут Феликс Арутюнян. Я студент, профессиональный скрипач. В этой статье хочу поделиться с Вами отрывком из моей презентации, которую я представил в университете музыки и театра Граца по предмету прикладная акустика.
Рассмотрим теоретические аспекты преобразования аналогового (аудио) сигнала в цифровой.
Статья не будет всеохватывающей, но в тексте будут гиперссылки для дальнейшего изучения темы.
Чем отличается цифровой аудиосигнал от аналогового?
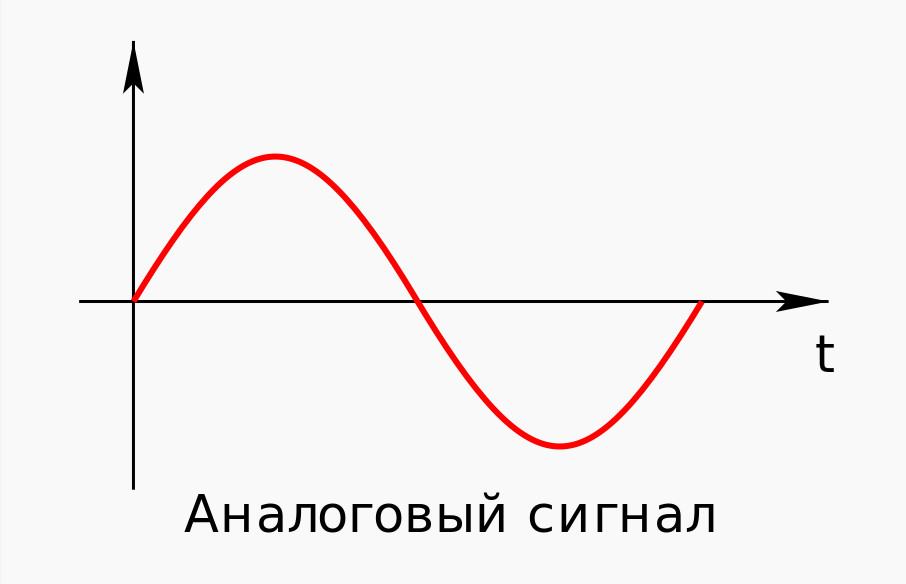
Аналоговый (или континуальный) сигнал описывается непрерывной функцией времени, т.е. имеет непрерывную линию с непрерывным множеством возможных значений (рис. 1).
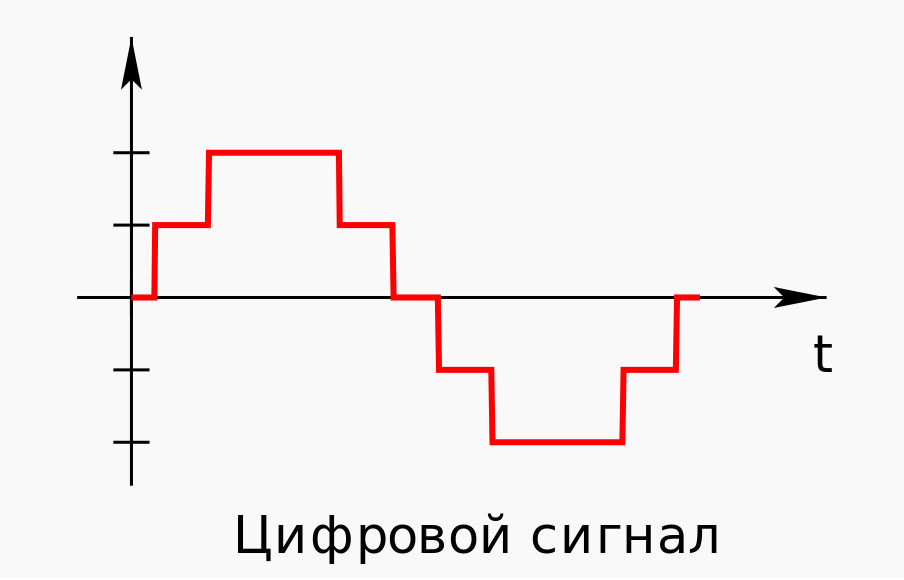
Цифровой сигнал — это сигнал, который можно представить как последовательность определенных цифровых значений. В любой момент времени он может принимать только одно определенное конечное значение (рис. 2).
Аналоговый сигнал в динамическом диапазоне может принимать любые значения. Аналоговый сигнал преобразуется в цифровой с помощью двух процессов — дискретизация и квантование. Очередь процессов не важна.
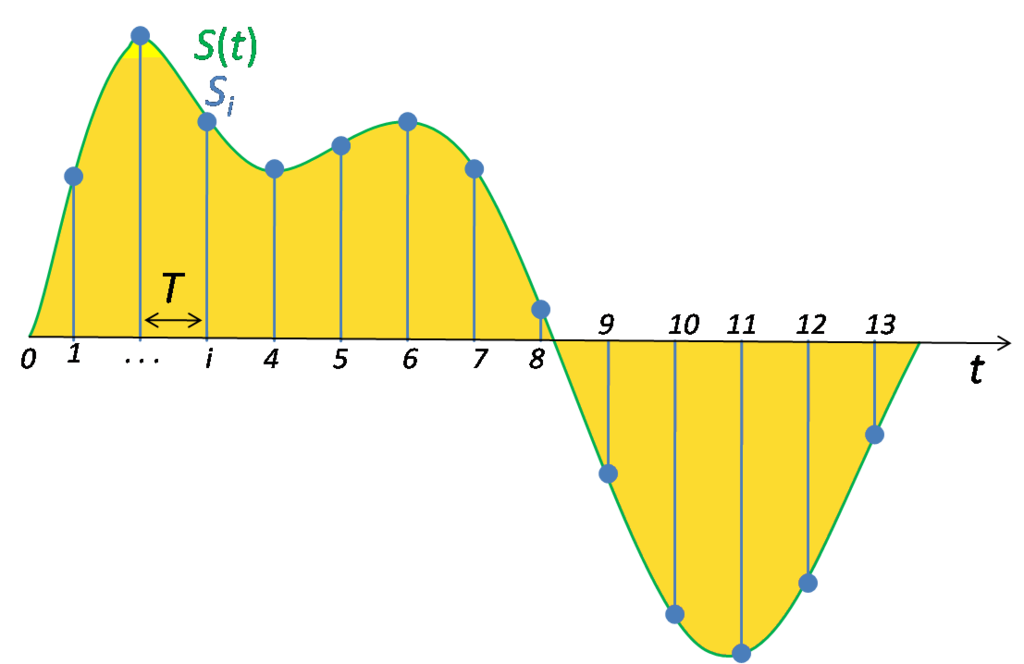
Дискретизацией называется процесс регистрации (измерения) значения сигнала через определенные промежутки (обычно равные) времени (рис. 3).
Квантование — это процесс разбиения диапазона амплитуды сигнала на определенное количество уровней и округление значений, измеренных во время дискретизации, до ближайшего уровня (рис. 4).
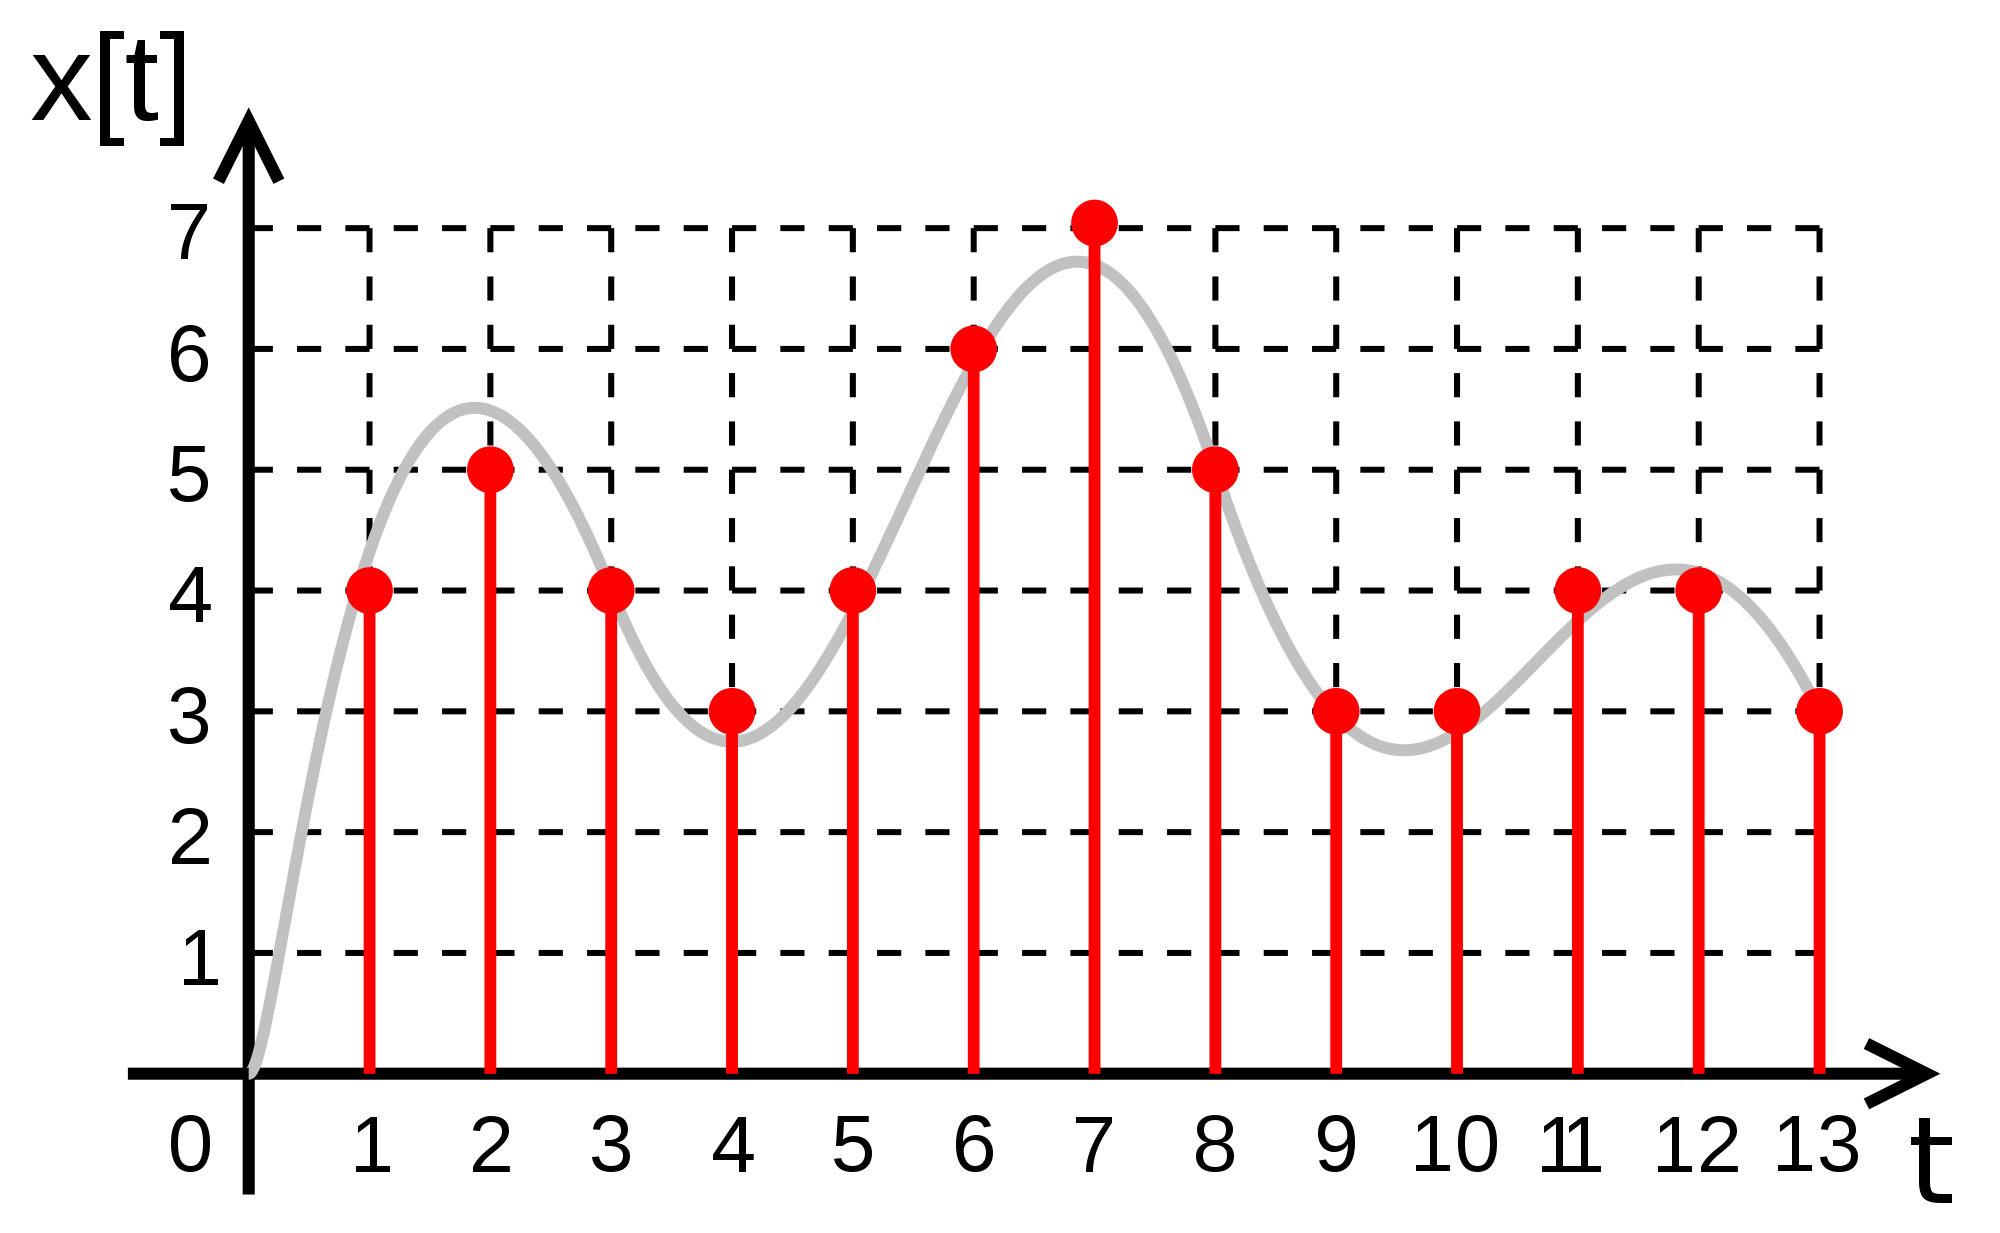
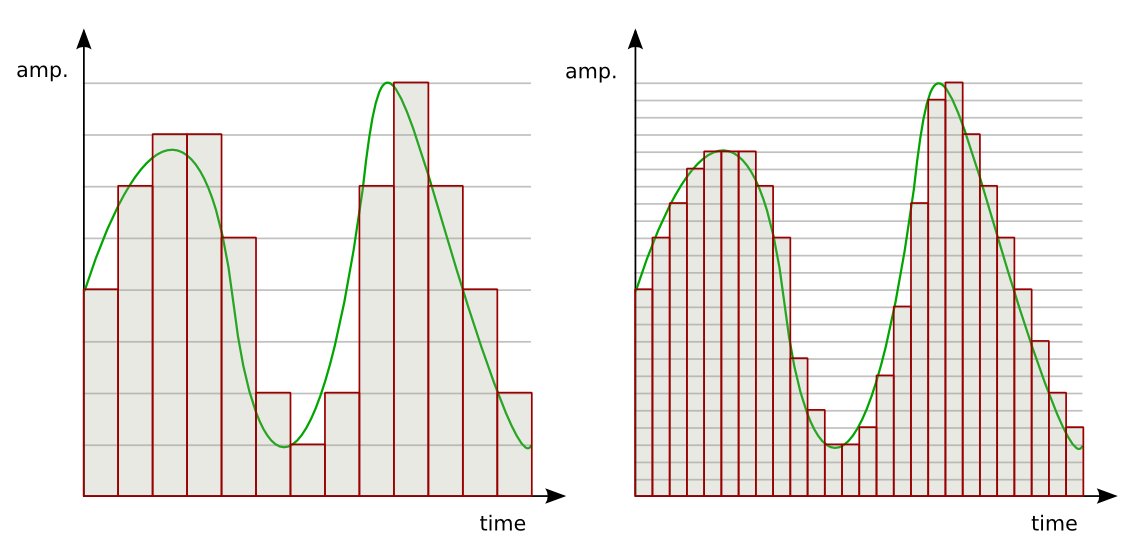
Дискретизация разбивает сигнал по временной составляющей (по вертикали, рис. 5, слева).
Квантование приводит сигнал к заданным значениям, то есть округляет сигнал до ближайших к нему уровней (по горизонтали, рис. 5, справа).
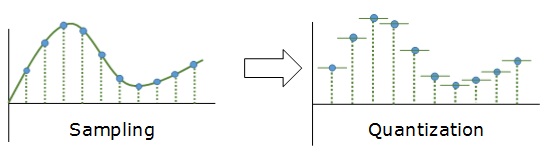
Эти два процесса создают как бы координатную систему, которая позволяет описывать аудиосигнал определенным значением в любой момент времени.
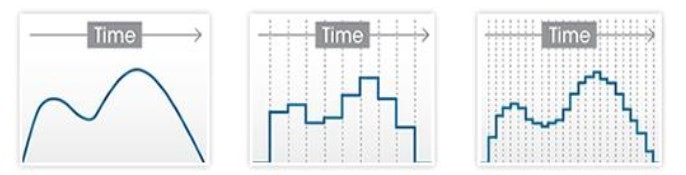
Цифровым называется сигнал, к которому применены дискретизация и квантование. Оцифровка происходит в аналого-цифровом преобразователе (АЦП). Чем больше число уровней квантования и чем выше частота дискретизации, тем точнее цифровой сигнал соответствует аналоговому (рис. 6).
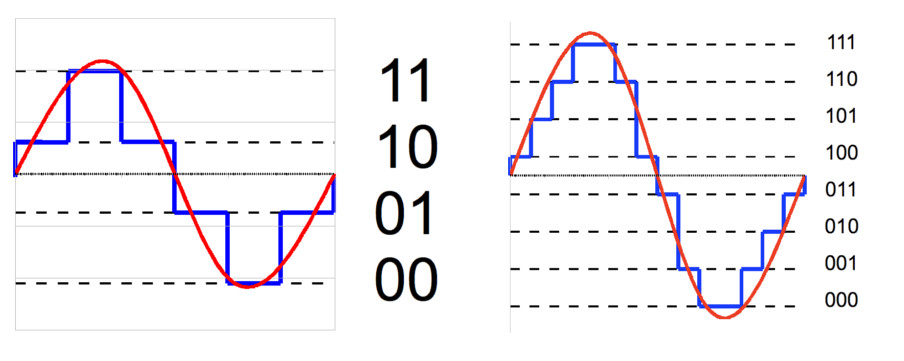
Уровни квантования нумеруются и каждому уровню присваивается двоичный код. (рис. 7)
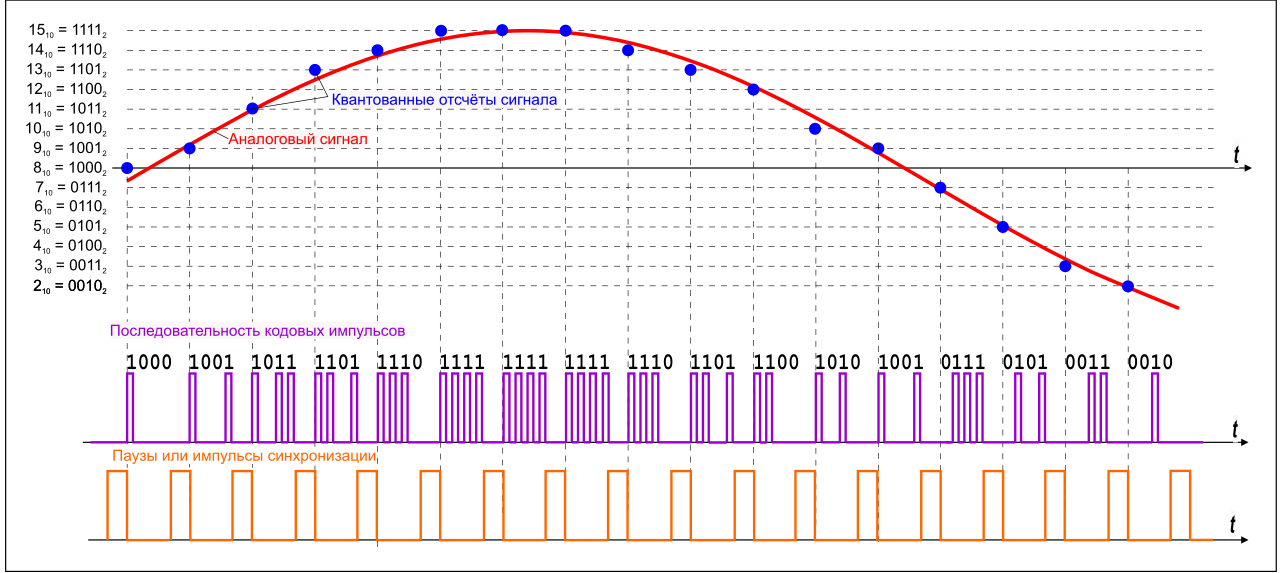
Количество битов, которые присваиваются каждому уровню квантования называют разрядностью или глубиной квантования (eng. bit depth). Чем выше разрядность, тем больше уровней можно представить двоичным кодом (рис. 8).
Данная формула позволяет вычислить количество уровней квантования:
Если N — количество уровней квантования,
n — разрядность, то
Обычно используют разрядности в 8, 12, 16 и 24 бит. Несложно вычислить, что при n=24 количество уровней N = 16,777,216.
При n = 1 аудиосигнал превратится в азбуку Морзе: либо есть «стук», либо нету. Существует также разрядность 32 бит с плавающей запятой. Обычный компактный Аудио-CD имеет разрядность 16 бит. Чем ниже разрядность, тем больше округляются значения и тем больше ошибка квантования.
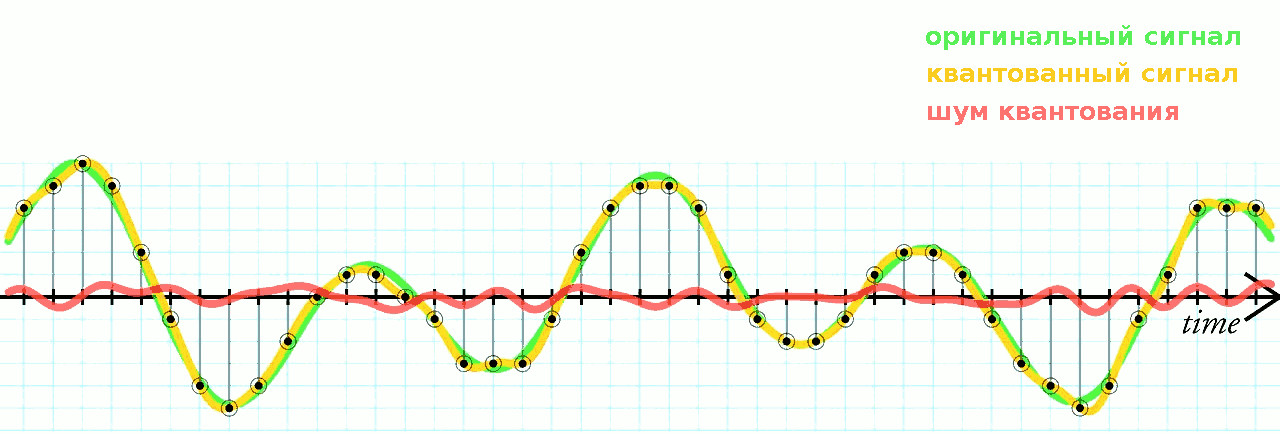
Ошибкой квантований называют отклонение квантованного сигнала от аналогового, т.е. разница между входным значением и квантованным значением ()
Большие ошибки квантования приводят к сильным искажениям аудиосигнала (шум квантования).
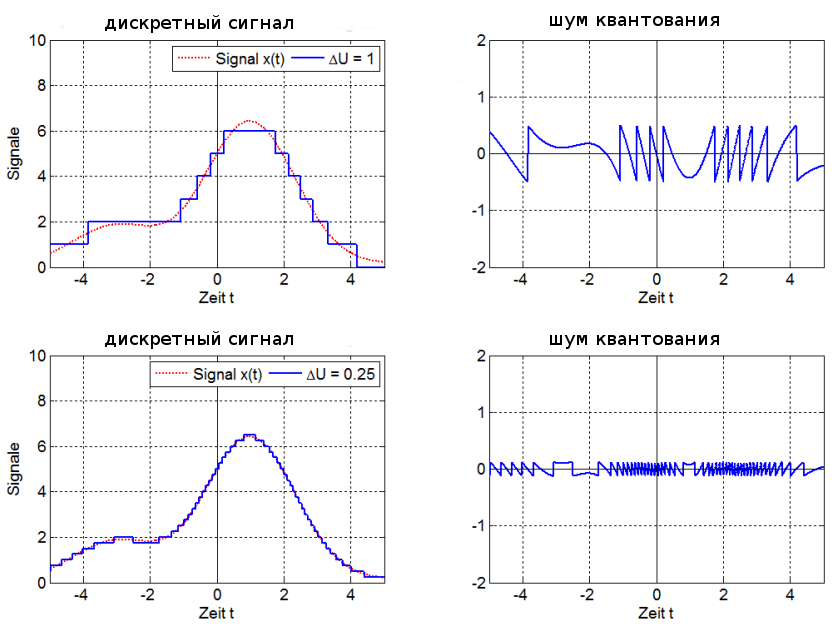
Чем выше разрядность, тем незначительнее ошибки квантования и тем лучше отношение сигнал/шум (Signal-to-noise ratio, SNR), и наоборот: при низкой разрядности вырастает шум (рис. 9).
Разрядность также определяет динамический диапазон сигнала, то есть соотношение максимального и минимального значений. С каждым битом динамический диапазон вырастает примерно на 6dB (Децибел) (6dB это в 2 раза; то есть координатная сетка становиться плотнее, возрастает градация).
Ошибки квантования (округления) из-за недостаточного количество уровней не могут быть исправлены.
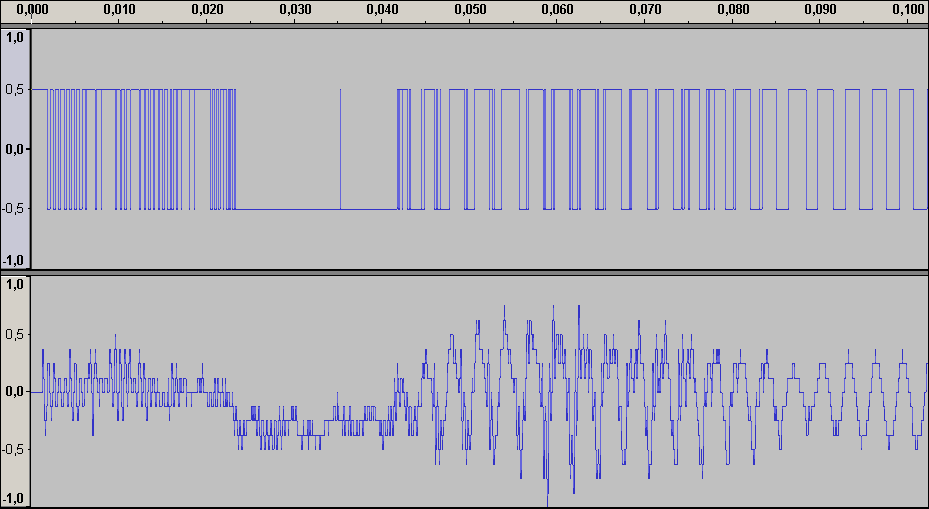
50dB SNR
примечание: если аудиофайлы не воспроизводятся онлайн, пожалуйста, скачивайте их.
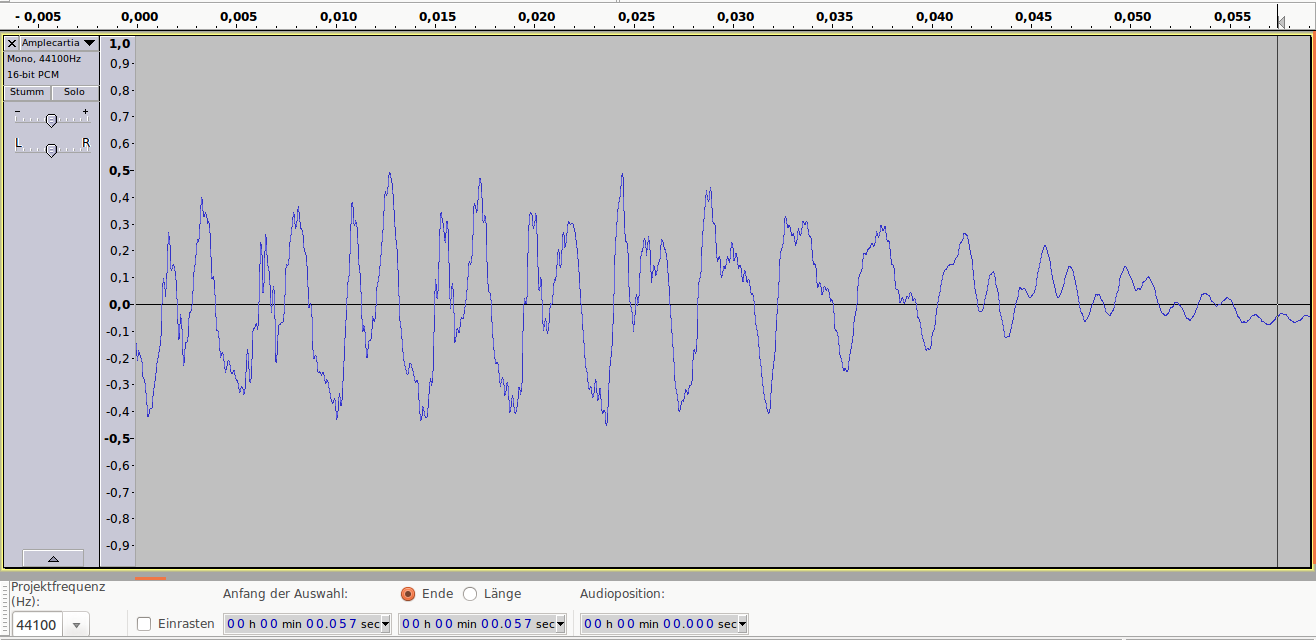
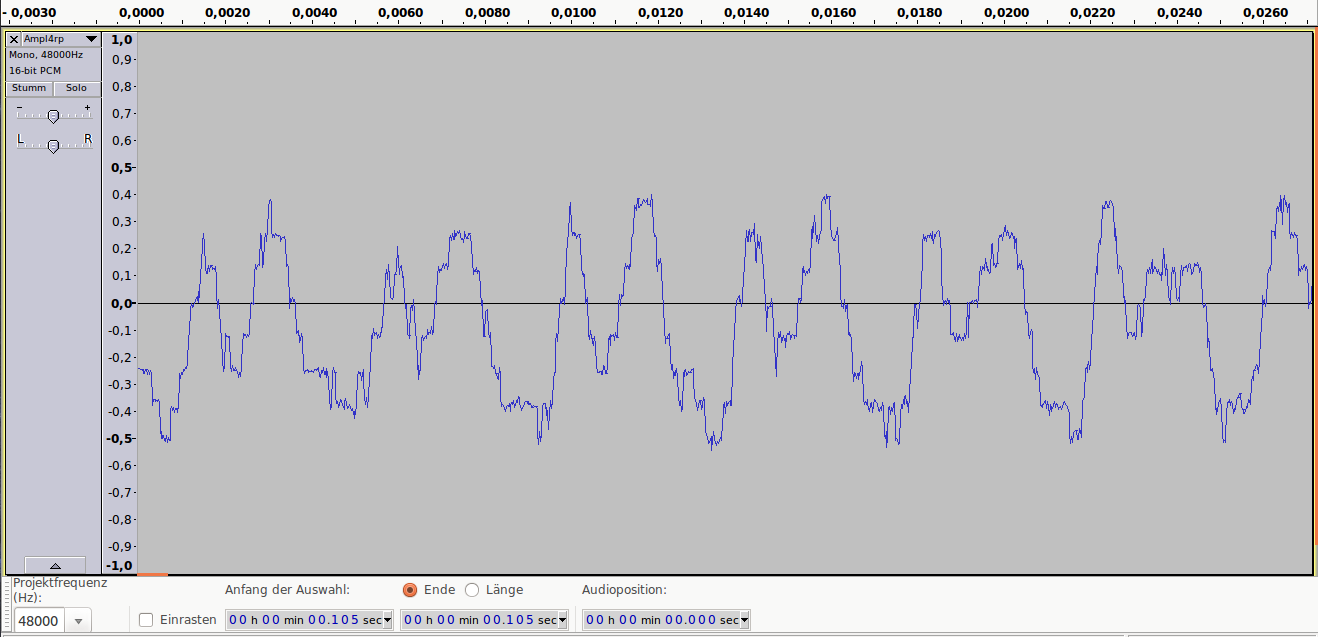
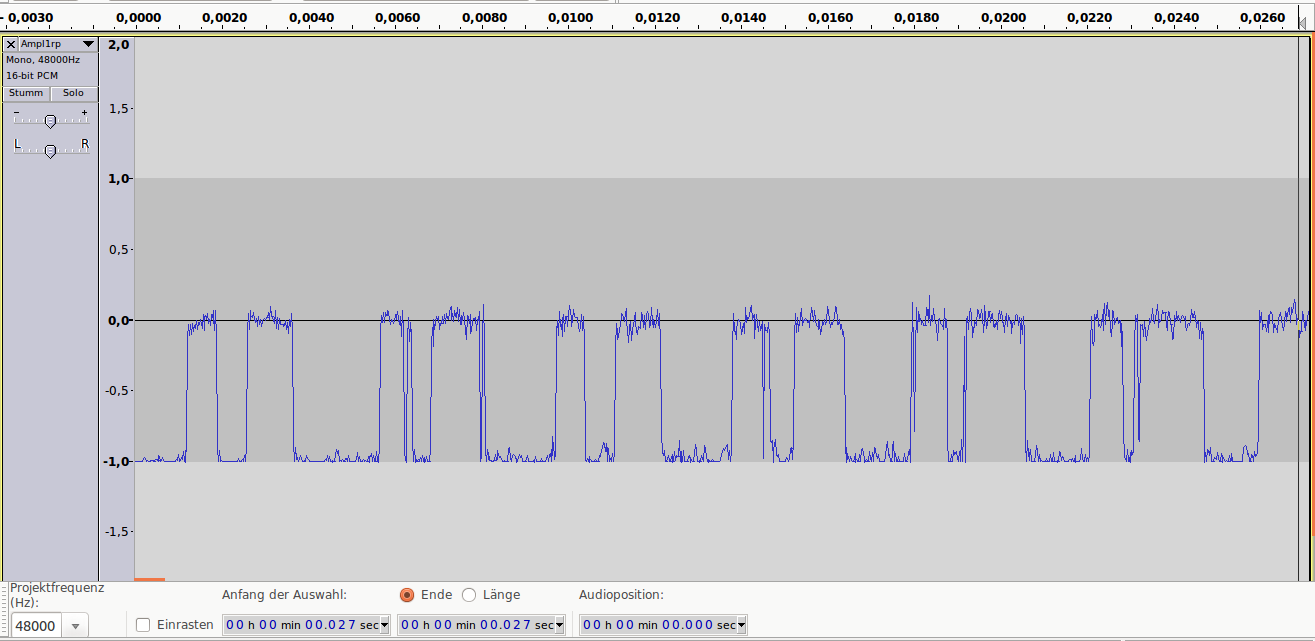
Теперь о дискретизации.
Как уже говорили ранее, это разбиение сигнала по вертикали и измерение величины значения через определенный промежуток времени. Этот промежуток называется периодом дискретизации или интервалом выборок. Частотой выборок, или частотой дискретизации (всеми известный sample rate) называется величина, обратная периоду дискретизации и измеряется в герцах. Если
T — период дискретизации,
F — частота дискретизации, то
Чтобы аналоговый сигнал можно было преобразовать обратно из цифрового сигнала (точно реконструировать непрерывную и плавную функцию из дискретных, «точечных» значении), нужно следовать теореме Котельникова (теорема Найквиста — Шеннона).
Теорема Котельникова гласит:
Вам знакомо число 44.1kHz? Это один из стандартов частоты дискретизации, и это число выбрали именно потому, что человеческое ухо слышит только сигналы до 20kHz. Число 44.1 более чем в два раза больше чем 20, поэтому все частоты в цифровом сигнале, доступные человеческому уху, могут быть преобразованы в аналоговом виде без искажении.
Но ведь 20*2=40, почему 44.1? Все дело в совместимости с стандартами PAL и NTSC. Но сегодня не будем рассматривать этот момент. Что будет, если не следовать теореме Котельникова?
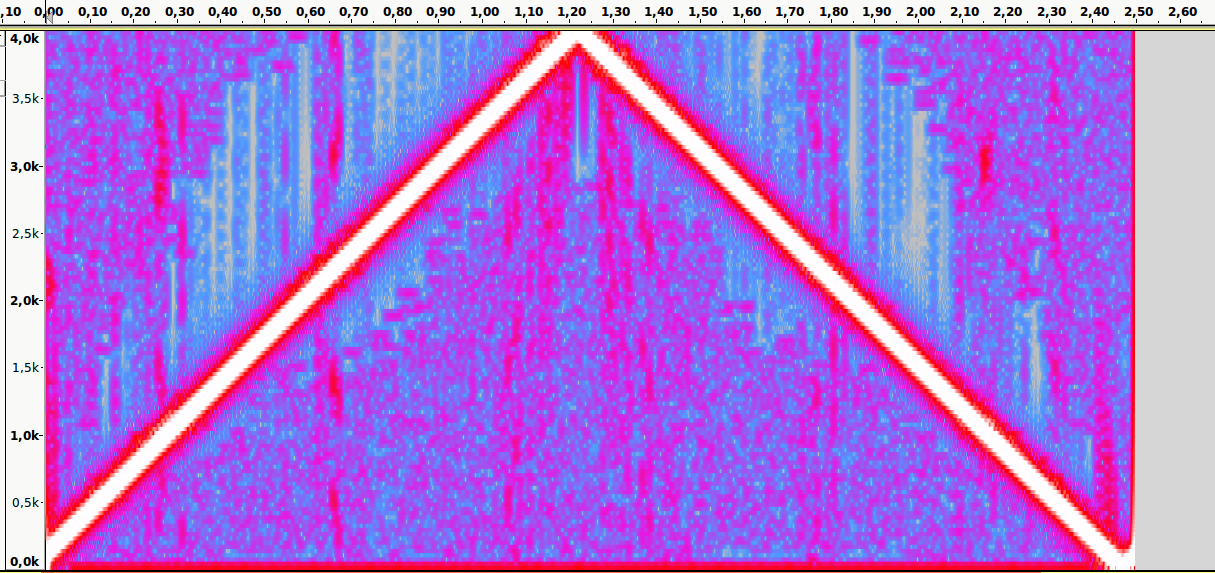
Когда в аудиосигнале встречается частота, которая выше чем 1/2 частоты дискретизации, тогда возникает алиасинг — эффект, приводящий к наложению, неразличимости различных непрерывных сигналов при их дискретизации.
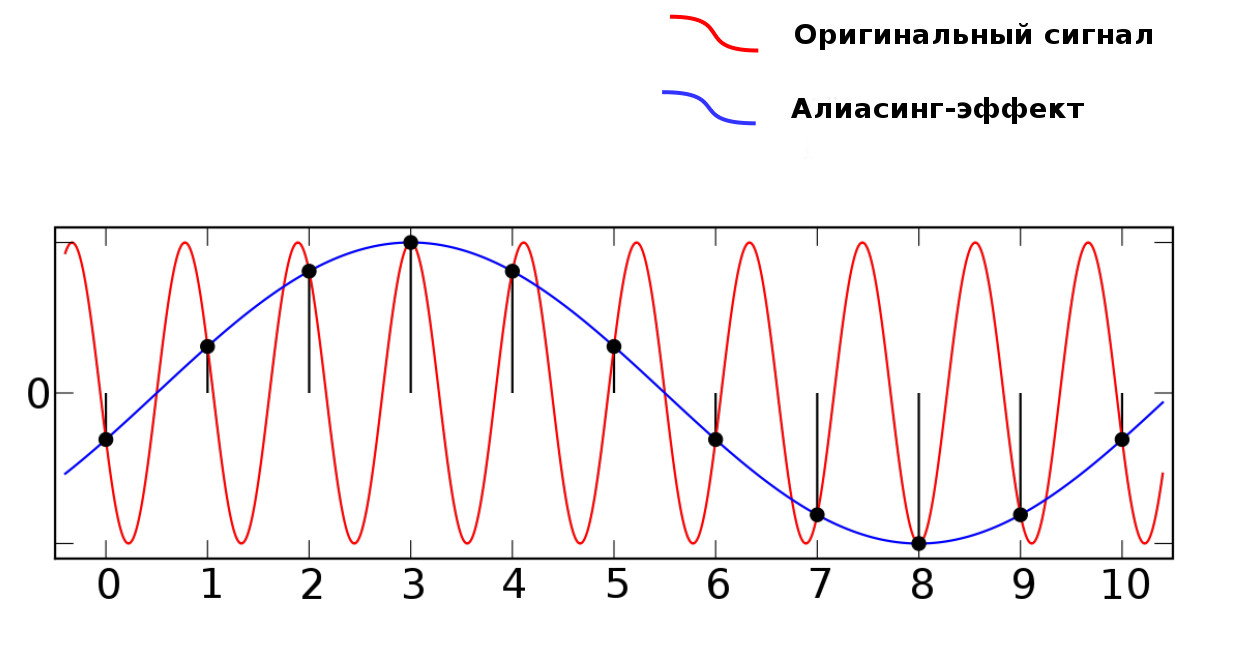
Как видно из предыдущей картинки, точки дискретизации расположены так далеко друг от друга, что при интерполировании (т.е. преобразовании дискретных точек обратно в аналоговый сигнал) по ошибке восстанавливается совершенно другая частота.
Аудиопример 4: Линейно возрастающая частота от
100 до 8000Hz. Частота дискретизации — 16000Hz. Нет алиасинга.
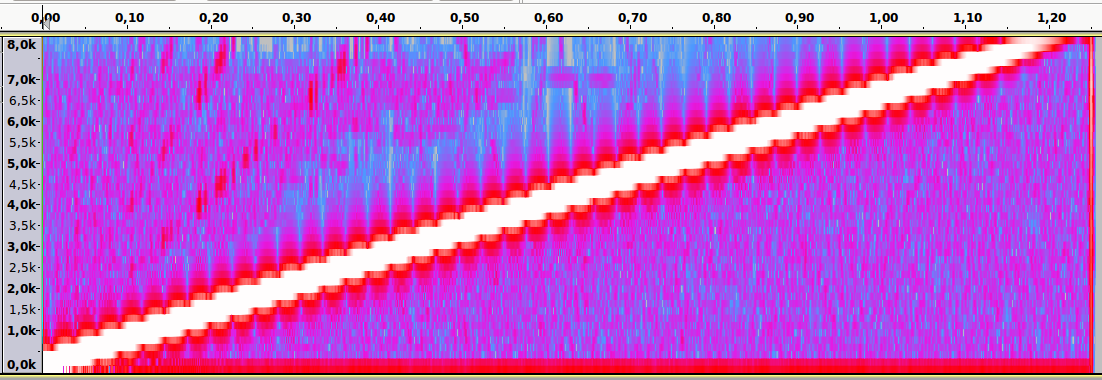
Аудиопример 5: Тот же файл. Частота дискретизации — 8000Hz. Присутствует алиасинг
Пример:
Имеется аудиоматериал, где пиковая частота — 2500Hz. Значит, частоту дискретизации нужно выбрать как минимум 5000Hz.
Следующая характеристика цифрового аудио это битрейт. Битрейт (bitrate) — это объем данных, передаваемых в единицу времени. Битрейт обычно измеряют в битах в секунду (Bit/s или bps). Битрейт может быть переменным, постоянным или усреднённым.
Следующая формула позволяет вычислить битрейт (действительна только для несжатых потоков данных):
Битрейт = Частота дискретизации * Разрядность * Количество каналов
Например, битрейт Audio-CD можно рассчитать так:
44100 (частота дискретизации) * 16 (разрядность) * 2 (количество каналов, stereo)= 1411200 bps = 1411.2 kbit/s
При постоянном битрейте (constant bitrate, CBR) передача объема потока данных в единицу времени не изменяется на протяжении всей передачи. Главное преимущество — возможность довольно точно предсказать размер конечного файла. Из минусов — не оптимальное соотношение размер/качество, так как «плотность» аудиоматериала в течении музыкального произведения динамично изменяется.
При кодировании переменным битрейтом (VBR), кодек выбирает битрейт исходя из задаваемого желаемого качества. Как видно из названия, битрейт варьируется в течение кодируемого аудиофайла. Данный метод даёт наилучшее соотношение качество/размер выходного файла. Из минусов: точный размер конечного файла очень плохо предсказуем.
Усреднённый битрейт (ABR) является частным случаем VBR и занимает промежуточное место между постоянным и переменным битрейтом. Конкретный битрейт задаётся пользователем. Программа все же варьирует его в определенном диапазоне, но не выходит за заданную среднюю величину.
При заданном битрейте качество VBR обычно выше чем ABR. Качество ABR в свою очередь выше чем CBR: VBR > ABR > CBR.
ABR подходит для пользователей, которым нужны преимущества кодирования VBR, но с относительно предсказуемым размером файла. Для ABR обычно требуется кодирование в 2 прохода, так как на первом проходе кодек не знает какие части аудиоматериала должны кодироваться с максимальным битрейтом.
Существуют 3 метода хранения цифрового аудиоматериала:
- Несжатые («сырые») данные
- Данные, сжатые без потерь
- Данные, сжатые с потерями
Несжатый (RAW) формат данных
содержит просто последовательность бинарных значений.
Именно в таком формате хранится аудиоматериал в Аудио-CD. Несжатый аудиофайл можно открыть, например, в программе Audacity. Они имеют расширение .raw, .pcm, .sam, или же вообще не имеют расширения. RAW не содержит заголовка файла (метаданных).
Другой формат хранения несжатого аудиопотока это WAV. В отличие от RAW, WAV содержит заголовок файла.
Аудиоформаты с сжатием без потерь
Принцип сжатия схож с архиваторами (Winrar, Winzip и т.д.). Данные могут быть сжаты и снова распакованы любое количество раз без потери информации.
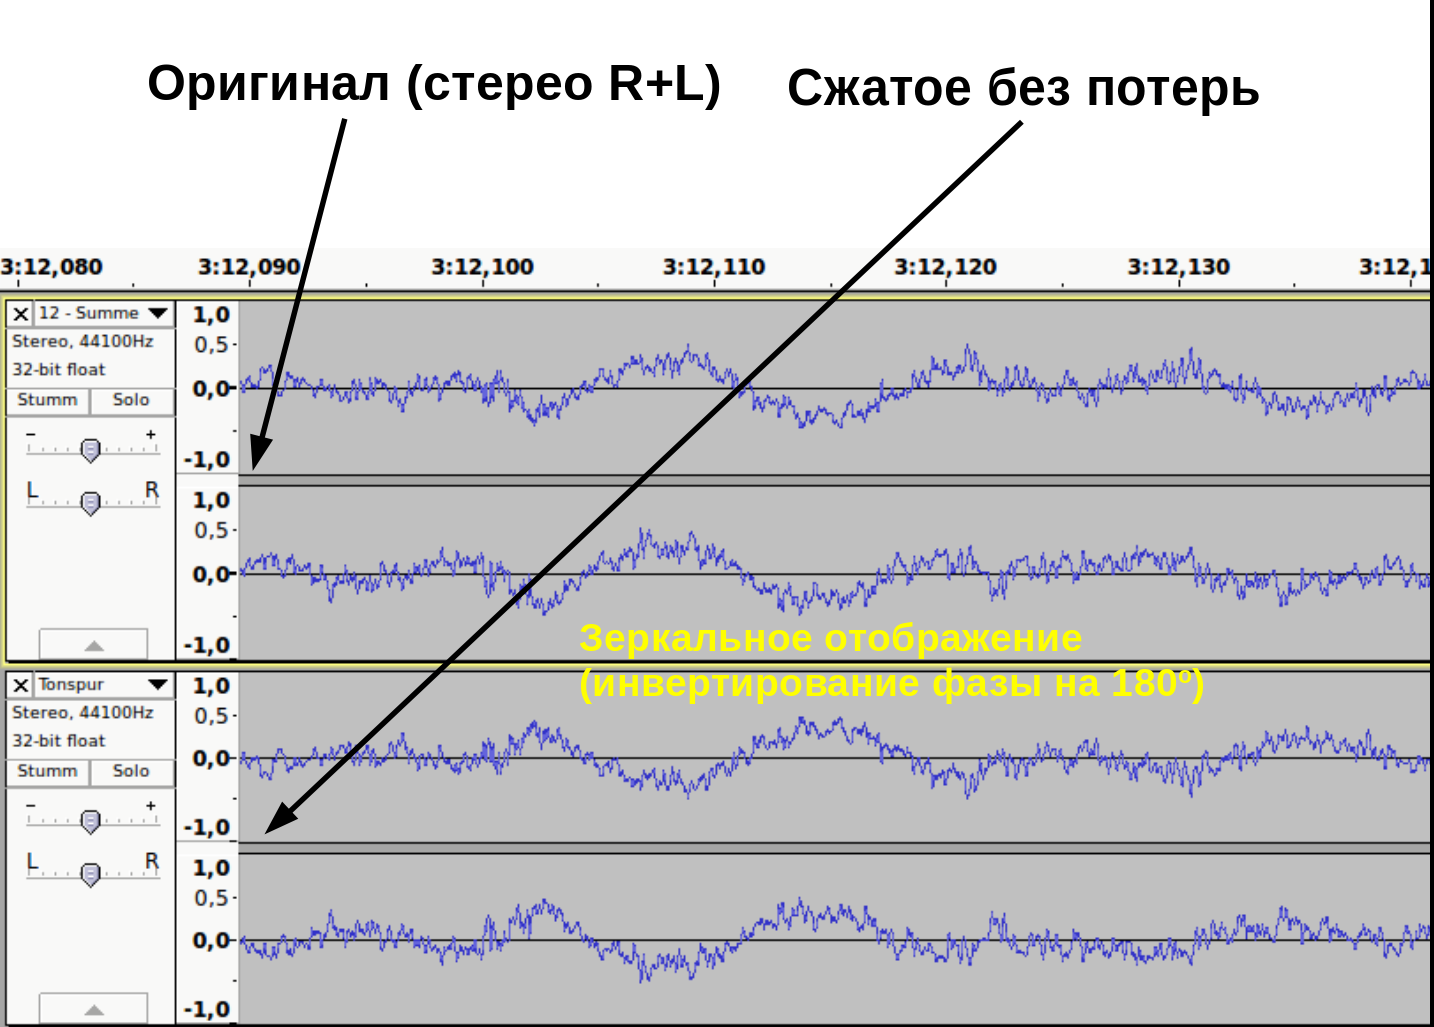
Как доказать, что при сжатии без потерь, информация действительно остаётся не тронутой? Это можно доказать методом деструктивной интерференции. Берем две аудиодорожки. В первой дорожке импортируем оригинальный, несжатый wav файл. Во второй дорожке импортируем тот же аудиофайл, сжатый без потерь. Инвертируем фазу одного из дорожек (зеркальное отображение). При проигрывании одновременно обеих дорожек выходной сигнал будет тишиной.
Это доказывает, что оба файла содержат абсолютно идентичные информации (рис. 11).
Кодеки сжатия без потерь: flac, WavPack, Monkey’s Audio…
При сжатии с потерями
акцент делается не на избежание потерь информации, а на спекуляцию с субъективными восприятиями (Психоакустика). Например, ухо взрослого человек обычно не воспринимает частоты выше 16kHz. Используя этот факт, кодек сжатия с потерями может просто жестко срезать все частоты выше 16kHz, так как «все равно никто не услышит разницу».
Другой пример — эффект маскировки. Слабые амплитуды, которые перекрываются сильными амплитудами, могут быть воспроизведены с меньшим качеством. При громких низких частотах тихие средние частоты не улавливаются ухом. Например, если присутствует звук в 1kHz с уровнем громкости в 80dB, то 2kHz-звук с громкостью 40dB больше не слышим.
Не пустой звук. Разбираемся, как устроено цифровое кодирование звука
Как известно, в цифровом звуке практически любой формат, за редким исключением, записывается импульсно-кодовым потоком, или потоком PCM — pulse code modulation. FLAC, MP3, WAV, Audio CD, DVD-Audio и другие форматы — это лишь способы упаковки, «консервации» потока PCM.
С чего все начиналось
Теоретические основы цифровой передачи звука были разработаны еще на заре двадцатого века, когда ученые попытались передать звуковой сигнал на большое расстояние, но не по телефону, а довольно странным для того времени способом.
Разделив звуковую волну на небольшие части, ее можно было отправлять получателю в некоем математическом представлении. Получатель, в свою очередь, мог восстановить исходную волну и прослушать запись. Также перед учеными стояла задача увеличить пропускную способность «эфира».
В 1933 году увидела свет теорема В. А. Котельникова. В западных источниках ее называют теоремой Найквиста — Шеннона. Да, Гарри Найквист был первым, кто затронул эту тему: в 1927 году он рассчитал минимальную частоту дискретизации для передачи формы волны, впоследствии названную в его честь «частотой Найквиста», — но теорема Котельникова была издана на 16 лет раньше.
Суть теоремы проста: непрерывный сигнал можно представить в виде интерполяционного ряда, состоящего из дискретных отчетов, по которым можно заново восстановить сигнал. Чтобы была возможность восстановить приблизительно исходное состояние сигнала, частота дискретизации должна равняться как минимум удвоенной верхней граничной частоте этого сигнала.

Много лет теорема не была востребована — вплоть до прихода цифровой эпохи. Тут-то ей и нашлось применение. В частности, теорема пригодилась при разработке формата CDDA (Compact Disc Digital Audio), в простонародье его называют Audio CD или Red Book. Формат был выпущен инженерами Philips и Sony в 1980 году и стал стандартом для аудио-компакт-дисков.
- частота дискретизации — 44,1 кГц;
- разрядность квантования — 16 бит.
- Частота дискретизации — количество отсчетов сигнала, «взятых» при его дискретизации. Измеряется в герцах.
- Разрядность квантования — количество двоичных разрядов, выражающих амплитуду сигнала. Измеряется в битах.
Частота дискретизации 44,1 кГц была рассчитана из теоремы Котельникова. Считается, что слух среднестатистического человека не способен уловить звук за пределами 19–22 кГц. Вероятно, частота 22 кГц и была выбрана в качестве верхней граничной.
22 000 × 2 = 44 000 + 100 = 44 100 Герц
Откуда взялось 100 Герц? Есть версия, что это небольшой запас на случай ошибок или передискретизации. На самом деле такую частоту в Sony выбрали из соображений совместимости со стандартом телевещания PAL.
Разрядность формата CDDA — 16 бит, или 65 536 отсчетов, что равняется динамическому диапазону примерно в 96 дБ. Такое большое число отсчетов выбрано не случайно. Во-первых, из-за сильного влияния шумов квантования, во-вторых, чтобы обеспечить формальный динамический диапазон выше, чем у главных тогда конкурентов — кассетных записей и виниловых пластинок. Я расскажу об этом подробнее в разделе про цифроаналоговые преобразователи.
Дальнейшее развитие PCM так и продолжилось по принципу умножения на два. Появились другие частоты дискретизации: сначала добавилась частота дискретизации 48 кГц, а в дальнейшем основанные на ней частоты 96, 192 и 384 кГц. Частота 44,1 кГц также удваивалась до 88,2, 176,4 и 352,8 кГц. Разрядность же увеличилась с 16 до 24, а позднее и до 32 бит.
Следующим после CDDA в 1987 году появился формат DAT — Digital Audio Tape. Частота дискретизации в нем составила 48 кГц, разрядность квантования не изменилась. И хотя формат провалился, частота дискретизации 48 кГц прижилась на студиях звукозаписи, как пишут, из-за удобства цифровой обработки.
В 1999 году вышел формат DVD-Audio, который позволял записать на один диск шесть стереодорожек с частотой дискретизации 96 кГц и разрядностью 24 бит или две стереодорожки с частотой 192 кГц, 24 бит.
В том же году был представлен формат SACD — Super Audio CD, но диски для него стали производить только спустя три года. Подробнее об этом формате я расскажу в разделе про DSD.
Это основные форматы, которые считаются стандартом для цифровых звукозаписей на носителях. Теперь рассмотрим, как передаются данные в цифровом звуковом тракте.
Структура цифрового звукового тракта
При проигрывании музыки происходит примерно следующее: плеер при помощи кодека, выполненного в виде устройства или программы, распаковывает файл в заданном формате (FLAC, MP3 и другие) или считывает данные с CD, DVD-Audio или SACD-диска, получая стандартный поток данных PCM. Затем этот поток передается через USB, LAN, S/PDIF, PCI и так далее в I2S-конвертер. В свою очередь, конвертер преобразует полученные данные в так называемые кадры интерфейса передачи данных I2S (не путать с I2С!).

I2S — это последовательная шина передачи цифрового аудиопотока. Сейчас I2S — стандарт для подключения источника сигнала (компьютер, проигрыватель) к цифроаналоговому преобразователю. Именно через нее подключается напрямую или опосредованно подавляющее большинство ЦАП. Существуют и другие стандарты передачи цифрового аудиопотока, но они используются гораздо реже.

Выход (вход) I2S на печатных платах
Другие статьи в выпуске: 
Xakep #256. Боевой Linux
Шина I2S может состоять из трех, четырех и даже пяти контактов:
- continuous serial clock (SCK) — тактовый сигнал битовой синхронизации (может называться BCK или BCLK);
- word select (WS) — тактовый сигнал кадровой синхронизации (может называться LRCK или FSYNC);
- serial data (SD) — сигнал передаваемых данных (может называться DATA, SDOUT или SDATA). Как правило, данные передаются от передатчика к приемнику, но бывают устройства, которые могут выступать и приемником, и передатчиком одновременно. В таком случае может присутствовать еще один контакт;
- serial data in (SDIN) — по этому контакту данные движутся в направлении приема, а не передачи.
SD или SDOUT служит для подключения цифроаналогового преобразователя, а SDIN используется для подключения аналого-цифрового преобразователя к шине I2S.
В большинстве случаев присутствует еще один контакт, Master Clock (MCLK или MCK), он используется для синхронизации приемника и передатчика от одного генератора тактовых импульсов, чтобы снизить коэффициент ошибок передачи данных. Для внешней синхронизации MCLK служат два генератора тактовых импульсов: с частотой 22 579 кГц и 24 576 кГц. Первый, 22 579 кГц, — для частот, кратных 44,1 кГц (88,2, 176,4, 352,8 кГц), а второй, 24 576 кГц, — для частот, кратных 48 кГц (96, 192, 384 кГц). Также могут встречаться генераторы на 45 158,4 кГц и 49 152 кГц — наверняка ты уже заметил, как в мире цифрового звука всё любят умножать на два.

Frame, или кадр I2S
В I2S обязательно используются три контакта: SCK, WS, SD — остальные контакты опциональны.
По каналу SCK передаются синхроимпульсы, под которые синхронизированы кадры.
По каналу WS передается длина «слова», при этом используются и логические состояния. Если на контакте WS логическая единица, значит, передаются данные правого канала, если ноль — данные левого канала.
По SD передаются биты данных — значения амплитуды звукового сигнала при квантовании, те самые 16, 24 или 32 бита. Никаких контрольных сумм и служебных каналов на шине I2S не предусмотрено. Если данные при передаче потеряются, возможности восстановить их не существует.
На дорогих ЦАП часто бывают внешние разъемы для подключения к I2S. Использование таких разъемов и кабелей может плохо отразиться на звуке, вплоть до появления «артефактов» и заиканий, все будет зависеть от качества и длины провода. Все же I2S это внутрисхемный разъем, и длина проводников от передатчика до приемника должна стремиться к нулю.
Рассмотрим, как передается поток данных PCM по шине I2S. Например, при передаче PCM 44,1 кГц с разрядностью 16 бит длина слова на канале SD будет соответствовать этим шестнадцати битам, а длина кадра будет 32 бита (правый канал + левый). Но чаще всего передающие устройства используют длину слова 24 бита.

При воспроизведении PCM 44,1 × 16 старшие биты либо попросту игнорируются, так как заполнены нулями, либо, в случае со старыми мультибитными ЦАП, они могут перейти на следующий кадр. Длина «слова» (WS) может также зависеть от плеера, через который воспроизводится музыка, а также от драйвера устройства воспроизведения.
Альтернативой PCM и I2S может быть запись звукового сигнала в DSD. Этот формат развивался параллельно с PCM, хотя и тут теорема Котельникова оказала некоторое влияние. Для улучшения качества звучания по сравнению с CDDA упор был сделан не на повышение разрядности квантования, как в формате DVD Audio, а на увеличение частоты дискретизации.
DSD расшифровывается как Direct Stream Digital. Он берет свое начало в лабораториях фирм Sony и Philips — впрочем, как и другие форматы, рассматриваемые в этой статье.
Впервые DSD увидел свет на дисках Super Audio CD в далеком 2002 году.

На тот момент SACD казался шедевром инженерной мысли, в нем был применен совершенно новый способ записи и воспроизведения, очень близкий к аналоговым устройствам. Реализация одновременно была простой и изящной.
Носитель даже оснастили защитой от копирования, хотя и без этого никакие пираты были не страшны. Под марками Sony и Philips стали выпускать «закрытые» устройства исключительно для воспроизведения, без какой-либо возможности копировать диски. Производители продавали студиям оборудование для записи, но при этом оставили за собой контроль за выпуском SACD-дисков.
Как знать, возможно, формат SACD мог бы обрести популярность, сравнимую с Audio CD, если бы не стоимость устройств воспроизведения. Безосновательно накручивая цены на проигрыватели, руководители Sony и Philips сами мешали популярности своего формата. А следующая ошибка и вовсе поставила крест на продажах специализированных устройств. Для продвижения игровой приставки Sony PlayStation инженеры Sony добавили возможность слушать на ней SACD. Хакеры тут же взломали приставку и стали копировать диски SACD в ISO-образы, которые можно записать на обычную болванку DVD и воспроизводить на любом плеере фирм-конкурентов; другие просто извлекали дорожки для воспроизведения на компьютере.
Звукозаписывающие компании тоже хороши: вопреки ожиданиям меломанов, они не пользовались всеми возможностями нового формата высокого разрешения. На студиях не записывали в DSD музыку с мастер-ленты, а брали цифровую запись в PCM, пересводили и обрабатывали всем подряд: лимитерами, компрессорами, дитерингом с нойз-шейпингом и различными цифровыми фильтрами. В итоге на выходе получался такой стерильный и сухой звук, что даже CD Audio мог бы звучать гораздо лучше. Таким образом было подорвано доверие слушателей к SACD, а заодно и к новым форматам вообще.
Увы, с виниловыми пластинками эта порочная практика применяется и по сей день: студии печатают винил с цифровой записи, даже если у них есть запись на мастер-ленте. Так что на современном виниле запросто может оказаться 44,1 × 16.
Что же представляет собой DSD? Это однобитный поток с очень высокой, по сравнению с PCM, частотой дискретизации. Также в DSD используется иной вид модуляции, PDM (Pulse Density Modulation) — плотностно-импульсная модуляция. Запись звука в таком формате производится однобитным аналого-цифровым преобразователем, сейчас такие АЦП на основе сигма-дельта-модуляции используются повсеместно. Процесс записи выглядит примерно так: пока амплитуда волны возрастает, на выходе АЦП логическая единица, когда амплитуда падает, на выходе логический ноль, среднего значения быть не может. Сравнивается с предыдущим значением амплитуды волны.

DSD позволяет достичь важных преимуществ по сравнению с PCM:
- точнее прорисовка волны;
- выше помехоустойчивость;
- более простой способ коммутации и передачи цифрового потока;
- теоретически есть возможность уменьшить стоимость, упростив схему ЦАП, но из-за обратной совместимости со старыми форматами производители вряд ли пойдут на это.
Изначально на SACD-дисках использовался формат DSD x64 c частотой дискретизации 2822,4 кГц. За основу взяли частоту дискретизации Audio CD 44,1 кГц, увеличенную в 64 раза, отсюда название x64. Сегодня реально используются следующие DSD:
- x64 = 2822,4 кГц;
- x128 = 5644,8 кГц;
- x256 = 11 289,6 кГц;
- x512 = 22 579,2 кГц;
- заявлен DSD x1024.
Существует некий промежуточный формат между PCM и DSD под названием DXD — Digital eXtreme Definition. Это, по сути, PCM высокого разрешения — 352,8 кГц или 384 кГц с разрядностью квантования 24 или 32 бита. Он применяется в студиях для обработки и последующего сведения материалов.
Но такой подход ущербен: во-первых, он не позволяет задействовать все преимущества DSD, во-вторых, размер файлов получается больше, чем в DSD. На текущий момент флагманские ЦАП на входе I2S принимают поток данных PCM с частотой дискретизации до 768 кГц и разрядностью до 32 бит. Страшно даже считать, какой объем на жестком диске будет занимать один альбом в таком разрешении.
DSD практически отделился от SACD. Теперь формат DSD чаще можно встретить упакованным в файлы с расширением DSF и DFF. Выпущено множество проигрывателей с возможностью записи в DSF и DFF, любители хорошего звука все чаще и чаще оцифровывают виниловые пластинки именно в формате DSD. А вот на звукозаписывающих студиях никто не хочет вкладываться в малопопулярные форматы, так что там продолжают клепать звук на минималках: 44,1 × 16.
Коммутация DSD и передача данных
Для передачи цифрового потока в DSD используется трехконтактная схема подключения:
- DSD Clock Pin (DCLK) — синхронизация;
- DSD Lch Data Input Pin (DSDL) — данные левого канала;
- DSD Rch Data Input Pin (DSDR) — данные правого канала.
В отличие от I2S, передача данных DSD предельно упрощена. DCLK задает тактовую частоту битовой синхронизации, а по контактам DSDL и DSDR последовательно передаются сами данные левого и правого канала соответственно. Никаких ухищрений тут нет, запись и воспроизведение в DSD делается побитно. Такой подход дает максимальное приближение к аналоговому сигналу, а за счет высокой частоты уменьшаются шумы квантования и на порядок повышается точность воспроизведения.
DoP часто применяется для передачи потока данных DSD, поэтому упомянуть о нем стоит. DoP — это открытый стандарт передачи данных DSD через кадры PCM (DSD over PCM). Стандарт создан для того, чтобы передавать поток через драйверы и устройства, не поддерживающие прямую передачу DSD (не DSD native).
Принцип работы такой: в 24-битном кадре PCM старшие 8 бит заполняются единицами — это значит, что в данный момент передаются данные DSD. Оставшиеся 16 бит заполняются последовательно битами данных DSD.

Для передачи DSD x64 с частотой однобитного потока 2822,4 кГц необходима частота дискретизации PCM, равная 176,4 кГц (176,4 × 16 = 2822,4 кГц). Для передачи DSD x128 с частотой 5644,8 кГц уже потребуется частота дискретизации PCM 352,8 кГц.
Подробности ты можешь найти в описании стандарта DoP (PDF).
Цифроаналоговые преобразователи
Перейдем к ЦАП — цифро-аналоговым преобразователям. Эта сложная тема всегда покрыта завесой тайны и присыпана аудиофильской мистикой. К тому же вокруг цифроаналоговых преобразователей очень много спекуляций противоборствующих лагерей: маркетологов, аудиофилов и скептиков. Давай разберемся, в чем тут дело.
Мультибитные ЦАП
Вначале, когда только появился формат Audio CD, PCM преобразовывали в аналоговый сигнал при помощи мультибитных ЦАП. Они были построены на основе резистивной матрицы постоянного импеданса, так называемой матрицы R-2R.

Упрощенная схема мультибитного ЦАП
Мультибитные ЦАП работают так: поток PCM разделяется на два канала, левый и правый, и переводится из последовательного представления сигнала в параллельное — например, при помощи сдвиговых регистров. В буфер одного регистра записываются данные правого канала, а в буфер другого — данные левого. Данные передаются одновременно по параллельным портам с заданной частотой дискретизации (чаще всего 44,1 кГц), как на изображении ниже, только параллельных выходов не восемь, а шестнадцать, потому что разрядность 16 бит. В зависимости от положения в кадре старшие и младшие биты будут встречать на пути следования электрического тока разное сопротивление, поскольку разным будет количество последовательно подключенных резисторов. Чем старше бит, тем больше должна быть его значимость.

Мультибитные ЦАП, или мультибиты, требуют очень качественных компонентов и точной подгонки резисторов, ведь любые неточности в номиналах компонентов суммируются. Это приводит к серьезным отклонениям от исходной волны и создает погрешность в несколько разрядов квантования.
В мультибитных ЦАП восьмидесятых годов нет никаких манипуляций с PCM. Мультибиты подключаются напрямую к шине I2S и проигрывают PCM как есть: пришли данные правого канала (16 бит), подождал данные второго канала (16 бит), выдал оба канала на резистивную матрицу — и так с частотой 44,1 кГц.
В восьмидесятые годы частота и разрядность определялись форматом СDDA, который стал практически эталонной реализацией теоремы Котельникова. С некоторыми оговорками так можно охарактеризовать и более поздний MP3. Только начиная с формата DVD Audio был пересмотрен подход к оцифровке и воспроизведению звука.
Так работали простейшие первые ЦАП, позднее стали использовать преобразователи с более сложным устройством. Схемы модернизировали, качество компонентов улучшалось, а еще в мультибитных ЦАП стали применять технологию oversampling. Oversampling — это передискретизация цифрового потока с повышением частоты дискретизации и разрядности квантования для уменьшения шума квантования.
Чтобы объяснить, зачем используется oversampling, необходимо рассказать о применении теоремы Котельникова на практике. Здесь все не так радужно, как представляется в мире математики, — ни о каком «с любой точностью», как написано в теореме, и речи не идет.
Теорема Котельникова
«Любую функцию F(t), состоящую из частот от 0 до f1, можно непрерывно передавать с любой точностью при помощи чисел, следующих друг за другом через 1/(2f1) секунд»
Следствия теоремы Котельникова:
- любой аналоговый сигнал может быть восстановлен с какой угодно точностью по своим дискретным отсчетам, взятым с частотой f > 2fc, где fc — максимальная частота, которая ограничена спектром реального сигнала;
- если максимальная частота в сигнале равна половине частоты дискретизации (наложение спектра) или превышает ее, то способа восстановить сигнал из дискретного в аналоговый без искажений не существует.
Если тебя интересуют подробности, можешь обратиться к первоисточнику — работе «О пропускной способности „эфира“ и проволоки в электросвязи» авторства В. А. Котельникова (PDF).
Сложности с теоремой Котельникова
Часто теорему Котельникова воспринимают слишком буквально и возводят в абсолют. Сколько я прочитал статей твердолобых скептиков о чудесных форматах MP3 и CDDA и о безумных аудиофилах, которые впаривают всем свои ненужные DVD-Audio и DSD! Конечно же, главным аргументом у них выступает теорема Котельникова.
Начнем с того, что частоты Найквиста на практике недостаточно для передачи точной формы волны. Из-за неидеальных условий неизбежно появляются шумы и искажения: шумы квантования при записи звукового сигнала, шумы округления при его обработке и воспроизведении и не только. Принято считать, что шумы квантования не могут быть меньше половины младшего разряда квантования. Это обусловлено тем, что при квантовании звукового сигнала делается округление до ближайшего разряда, в большую или меньшую сторону. Шумы округления также не могут быть меньше половины младшего разряда, или, как его еще называют, шага квантования. Есть еще собственные шумы АЦП и ЦАП, но для них сложно привести точную цифру, ведь на них влияет большое количество факторов: конкретная реализация, количество и качество компонентов и даже окружающая среда. Обычно собственные шумы составляют несколько разрядов квантования.
Из этого следует, что частота дискретизации должна быть значительно выше частоты Найквиста, чтобы компенсировать потери при оцифровке и последующем воспроизведении цифровой записи.

Приведу пример из конспекта лекций Э. И. Вологдина «Стандарты и системы цифровой звукозаписи»:
Как видно, пока пиковое значение входного сигнала не превышает 0,5 кванта, выходной сигнал квантователя равен нулю, то есть имеет место центральная отсечка. Это приводит к нелинейности преобразования и возникновению больших искажений при малых амплитудах ЗС. Пока значение A > 1,5, выходной сигнал демодулятора представляет собой последовательность прямоугольных импульсов, у которых с изменением уровня ЗС меняется длительность. Это обусловлено ошибками квантования, которые соизмеримы с амплитудой входного сигнала. Искажения начинают заметно уменьшаться только при A > 2.
За А взята амплитуда сигнала.
В приведенной цитате речь идет только о шуме квантования, причем взято минимально возможное значение — 1/2 шага квантования. Шумы округления оказывают примерно такое же влияние — минимум 1/2 шага квантования.
Кроме шумов, в цифровой записи могут появляться искажения, вызванные использованием ФНЧ — фильтра низких частот. По теореме Котельникова необходимо ограничить частоту звукового сигнала фильтром и принять ее за верхнюю граничную, из которой потом умножением на два вычисляют частоту Найквиста. Проблема в том, что в теореме рассматривается идеальный ФНЧ, которых в реальном мире не бывает. Приведу цитату из того же конспекта лекций Вологдина:
Для надежного подавления спектральных составляющих выше частоты Найквиста антиэлайзинговый ФНЧ должен иметь частоту среза несколько ниже частоты Найквиста и очень сильно (не меньше 90 дБ) подавлять составляющие спектра сигнала на этой частоте. Обычно это эллиптические фильтры 7. 9 порядков. Высокая крутизна среза ФНЧ приводит к специфическим искажениям в виде «звона». Это связано с тем, что отклик на импульсное воздействие такого фильтра описывается осциллирующей функцией вида sinс (v). Чем выше крутизна среза ФНЧ, тем медленнее происходит затухание звуковых колебаний. Единственным способом борьбы с этими искажениями является повышение частоты выборок. Это позволяет уменьшить крутизну спада антиэлайзингового ФНЧ без уменьшения эффективности подавления спектральных составляющих выше частоты Найквиста.
Рассмотрю еще один интересный момент. В теореме Котельникова приводится бесконечный по времени сигнал, что противоречит условиям записи на носитель или в файл.
Теорема Котельникова дает предельные соотношения для идеализированных условий, среди которых следует отметить ограниченность спектра по частоте и бесконечное время наблюдения. Все реальные сигналы конечны во времени и имеют неограниченный по частоте спектр. Использование модели с ограниченным спектром и конечное время наблюдения приводят к погрешности при восстановлении непрерывного сигнала. Расчеты показывают, что на практике частота FД существенно превышает частоту дискретизации по Котельникову» (здесь FД — это частота дискретизации).
Источник — И. П. Ястребов «Дискретизация непрерывных сигналов во времени. Теорема Котельникова» (PDF)
Чтобы обрисовать масштаб проблемы, приведу еще одну цитату.
Искажения, вызванные ошибками квантования, уверенно заметны на слух уже при восьмиразрядном кодировании, хотя при этом величина искажений не превышает 0,5%. Это значит, что при шестнадцатиразрядном кодировании, используемом при записи CD, реальный динамический диапазон цифрового звука не превышает 48 дБ, а не 96 дБ, как это пишется в рекламе».
Источник — Э. И. Вологдин «Цифровая звукозапись» (PDF)
Выводы
Теорема Котельникова математически верна, но для практического ее применения требуется существенная коррекция. И частоту Найквиста можно обозначить скорее как минимально допустимую для восстановления приблизительной формы волны, но никак не для восстановления сигнала «с любой точностью». Для компенсации потерь при оцифровке и воспроизведении частота дискретизации должна быть не в два, а как минимум в несколько раз выше верхней граничной частоты.
На этом оставим в покое теорему Котельникова и перейдем к изучению различных шумов при записи, сведении и воспроизведении звукового сигнала.
Существует множество видов шумов, влияющих на запись. Приведу основные: шум квантования, шум округления, дрожание апертуры, нелинейные искажения, аналоговый шум. Можешь познакомиться с описаниями четырех типов шумов и формулами, чтобы примерно понять, сколько искажений в оцифрованный сигнал вносит каждый вид.
Не стоит воспринимать термин «шум» как проявление именно знакомого всем «белого шума». Разные виды шумов воспринимаются по-разному, в данном контексте термин «шум» скорее нужно понимать как потерю части полезного сигнала.
Примерно рассчитать отдельный вид шума еще можно, но общий уровень шумов при оцифровке — едва ли. Это очень сложная математическая модель с множеством допущений. Попробуем пойти от обратного и проанализировать динамический диапазон записанного сигнала на АЦП (аналого-цифровом преобразователе) и сравнить его с теоретически возможным.
Уровень шума обычно рассчитывают по отношению к шагу квантования (один разряд) или к динамическому диапазону звукового сигнала. Динамический диапазон измеряется в децибелах, рассчитать его можно по формуле: DR = 20lg(2 N ), где N — разрядность квантования. Получается для 16 бит возможный динамический диапазон около 96 дБ, а для 24 бит около 144 дБ.
Возьму результаты тестирования АЦП «Lynx Studio Hilo TB», это студийный АЦП/ЦАП высшей ценовой категории. Он показал следующие результаты.
| Режим работы | 24 бит, 44 кГц | |
|---|---|---|
| Динамический диапазон, дБ (А) | 119,3 | Отлично |
А вот результаты без усиления.
| Режим работы | 24 бит, 44 кГц | |
|---|---|---|
| Динамический диапазон, дБ (А) | 112,6 | Отлично |
Забегая вперед, скажу, что в тестируемом АЦП используются технологии дитеринг (Dithering), нойз-шейпинг (Noise shaping), а также децимация, что позволяет расширить динамический диапазон и снизить уровень шума. Подробнее про эти технологии расскажу в следующем пункте.
А теперь прикинем: 24 бита равняются 144 дБ — это возможный динамический диапазон. От 144 дБ отнимем реальный динамический диапазон 119 дБ, потери от шумов составят лучшем случае 25 дБ, а в худшем 32 дБ. К сожалению, при 16 бит его не тестировали, но в соотношении результаты должны быть еще хуже, поскольку понижение разрядности неминуемо приводит к росту шумов. Получается, что примерно 1/5 часть сигнала просто теряется из-за шума.
Складывается далеко не радужная картина. А если копнуть глубже и учесть, как звук сводят на студии записи, становится не по себе. Как правило, готовое произведение сводят из семплов, в которых уже и так присутствуют указанные шумы, поскольку семплы записаны на подобном АЦП. Затем добавляют эффекты, которые как минимум приводят к передискретизации (resampling) и связанным с ней ошибкам округления.
Кроме того, плохие звукорежиссеры очень любят все пожать и выровнять, используя лимитеры и компрессоры, принцип работы которых основан на уменьшении динамического диапазона. Через все эти пытки проходит практически каждый семпл. Даже при использовании простого эквалайзера сигнал проходит через цифровой фильтр, который вносит шум округления как минимум в полшага квантования. При конечном сведении все семплы собираются в один поток, соответственно шумы каждого добавляются к шумам еще одной передискретизации. Но и это еще не все — при воспроизведении ЦАП добавляет собственные шумы и шум округления. Представляешь, что на самом деле остается от полезного сигнала?
Методы борьбы с шумами
Чтобы исправить это плачевное положение, были разработаны специальные технологии борьбы с шумами. Давай рассмотрим самые основные.
Oversampling
Технологию oversampling стали применять еще во времена мультибитных ЦАП для компенсации потерь, вызванных шумами. Принцип работы oversampling заключается в том, что к уже существующим дискретным отсчетам добавляются промежуточные, которые повторяют приблизительную форму волны. Промежуточные отсчеты либо рассчитываются с применением математической интерполяции, либо заполняются нулевыми значениями и передаются на цифровой фильтр. Обычно и тот и другой подход называют интерполяцией, а цифровой фильтр называют интерполирующим. Самым простым способом интерполяции является линейная интерполяция, а самым простым цифровым фильтром может выступать фильтр нижних частот.
Ниже — иллюстрация алгоритма интерполяции дискретного сигнала с коэффициентом 2. Красные точки обозначают исходные отсчеты сигнала, сплошные линии — непрерывный сигнал, представлением которого эти отсчеты являются. Сверху — исходный сигнал. В середине — этот же сигнал со вставленными нулевыми отсчетами (зеленые точки). Снизу — интерполированный сигнал (синие точки — интерполированные значения отсчетов).

Сначала стали применять только передискретизацию с повышением частоты, например с 44,1 до 176,4 кГц. Позднее применяли уже передискретизацию с повышением частоты дискретизации и увеличением разрядности квантования — этот процесс называется реквантование.
Хотя oversampling вносит шум округления, все же при его использовании благодаря расширению динамического диапазона сигнала снижается общая плотность шума, и последующая обработка сигнала окажет уже меньшее влияние. Каждое удвоение частоты дискретизации расширяет динамический диапазон примерно на один шаг квантования — 6 дБ — минус шум округления.
Как раз для возможности применить oversampling стали выпускать микросхемы мультибитных ЦАП, поддерживающие на входе цифровой поток до 192 × 24. Также появились аппаратные апсемплеры на основе DSP (digital signal processor).
Конечно, применение технологии oversampling давало улучшение характеристик звукового сигнала, но кардинально ситуацию не меняло: уровень шума все равно оставался высоким. Поэтому стали применяться и другие технологии.
Децимация
Для записи и сведения звукового сигнала начали использовать децимацию — это обратный процесс, передискретизация с понижением частоты дискретизации и разрядности квантования. Сигнал записывается с высокой частотой дискретизации и разрядностью квантования, например 176,4 или 192 кГц с разрядностью 24 бит, и при помощи удаления части отсчетов цифровым фильтром «сжимается» до стандарта CDDA — 44,1 кГц, 16 бит. Этот подход позволяет немного снизить уровень шума квантования.
Ниже — иллюстрация алгоритма децимации дискретного сигнала с коэффициентом 2. Красные точки обозначают отсчеты, сплошные линии — непрерывный сигнал, представлением которого эти отсчеты являются. Сверху — исходный сигнал. В середине — этот же сигнал после фильтрации в цифровом фильтре нижних частот. Снизу — децимированный сигнал.

Dithering
Dithering (дитеринг) — метод подмешивания псевдослучайного шума при оцифровке или воспроизведении звукового сигнала. Эта технология выполняет две задачи:
- линеаризация передаточной функции квантователя/реквантователя;
- декорреляция ошибок квантования.
Шумы квантования имеют корреляцию, то есть взаимосвязь с основным сигналом. Это создает паразитные гармоники, которые повторяют форму сигнала. Они влияют на восприятие, создавая ощущение «нечеткости» звучания. Корреляцию можно убрать, добавляя специально смоделированный шум в основной сигнал, — таким образом коррелированный шум квантования превращается в обычный белый шум. Это немного поднимает общий шумовой уровень, но хорошо сказывается на восприятии.

Дитеринг на примере обработки изображений: до и после
Noise shaping (нойз-шейпинг)
Технология noise shaping (NS) позволяет значительно уменьшить шум, вносимый при квантовании, реквантовании и дитеринге.
Нойз-шейпинг работает так: квантованный сигнал на входе сравнивается с сигналом на выходе реквантователя, формируется разница (ошибка), которая вычитается из основного сигнала. Тем самым компенсируются искажения, внесенные реквантователем и в процессе дитеринга. Образуется так называемая обратная связь, которая стремится компенсировать ошибку на входе и выходе реквантователя. Эта технология работает подобно отрицательной обратной связи на операционном усилителе, только все преобразования происходят в цифровом виде.

Здесь приведена схема реквантователя первого порядка, но, как правило, используются реквантователи вплоть до 9–12-го порядка
У этой технологии есть свои минусы. Применение NS вносит большое количество шумов в область высоких частот, поэтому необходимо применять фильтр низких частот, с частотой среза, близкой к верхней граничной частоте. На практике вместе с NS всегда применяют еще и дитеринг, результат их совместной работы намного лучше на слух.
Dynamic Element Matching
Dynamic Element Matching (DEM) — технология, которая формирует на выходе ЦАП несколько уровней сигнала. Она похожа на нечто среднее между однобитным и мультибитным ЦАП. DEM служит для снижения детерминированных ошибок при использовании сигма-дельта-модуляции (SDM). Эти ошибки, подобно шумам квантования, сильно коррелированы с сигналом на выходе однобитного модулятора, поэтому значительно влияют на восприятие звукового сигнала.
Также эта технология снижает требования к аналоговому фильтру, потому что форма сигнала еще до фильтрации приближается к форме воспроизводимой волны. DEM реализуется при помощи нескольких выводов, соединенных в общую шину, которые формируют выходной сигнал ЦАП.

Кроме рассмотренных, применяются и другие технологии, а также их сочетания и вариации. Особенно производители любят экспериментировать с цифровой фильтрацией и модуляторами, изобретая все новые и новые цифровые фильтры, влияющие на сигнал как в лучшую, так и в худшую сторону. Алгоритмы обработки цифрового сигнала современных ЦАП, как правило, сложны и включают все перечисленное, а также собственные наработки производителей. Разумеется, производители не публикуют алгоритмы фильтров и модуляторов, в лучшем случае приводят примерную блок-схему. Так что остается только предполагать, что на самом деле происходит со звуковым сигналом внутри того или иного цифроаналогового преобразователя.
Сигма-дельта-преобразователи
Сигма-дельта цифроаналоговые преобразователи развивались обособленно от мультибитных ЦАП. За основу была взята, как понятно из названия, сигма-дельта-модуляция, в литературе она обычно обозначается аббревиатурой SDM. В сигма-дельта-модуляции передается не абсолютное значение амплитуды сигнала за единицу времени, как в мультибитных ЦАП, а изменения сигнала относительно предыдущего значения. Так, если амплитуда возрастает, передается 1, а если падает — 0. Подобный принцип уже был описан в разделе про DSD.

Первые сигма-дельта-ЦАП были полностью однобитными, но за счет высокой частоты дискретизации обеспечивали динамический диапазон на уровне примерно 129 дБ. За основу взяли частоту дискретизации 44,1 кГц. Вероятно, выбранная частота позволяла экономить аппаратные ресурсы благодаря упрощению вычислений при интерполяции.
Сначала использовали частоту 2,8 МГц, это 44,1 кГц, увеличенная в 64 раза. Сейчас частота может быть разной, она определяется внутренней архитектурой самого ЦАП. Обычно она основана на частотных сетках, кратных 44,1 кГц и 48 кГц, с множителем 64, 128, 256, 512, 1024.
Со временем дельта-сигма-ЦАП практически полностью вытеснили мультибитные, просто по экономическим причинам. Во-первых, их требования к качеству и точности компонентов гораздо ниже, чем у мультибитных ЦАП, соответственно, и себестоимость ниже. Во-вторых, в восьмидесятые — девяностые годы стоимость реализации интерполяции и noise shaping для однобитного модулятора была существенно меньше, чем для 16 бит. Сейчас, с развитием технологий, это не так критично, и многие сигма-дельта-ЦАП имеют, подобно мультибитам, несколько уровней на выходе. Но за счет многократного увеличения частоты требования к компонентам остаются не очень высокими, поэтому первое преимущество сохраняется и по сей день.
Современные сигма-дельта-ЦАП имеют сложную структуру и включают в себя практически все технологии, перечисленные в предыдущей главе. Приведу пример внутренней структуры одного из простых сигма-дельта-ЦАП из лекций Вологдина.

Входные цифровые 16-разрядные выборки с частотой дискретизации 44,1 кГц подаются на вход цифрового фильтра передискретизации. В схеме используется нерекурсивный с четырехкратной передискретизацией FIR (finite impulse response) интерполяционный фильтр с линейной фазовой характеристикой. На первом этапе модуляции в результате переквантования число разрядов в выборках понижается с 16 до 14 и используется SDM 1-го порядка. Затем еще раз производится передискретизация c помощью двух ступеней (Kos = 32 и 2). Между этими ступенями в тракт вводится шумовой сигнал, осуществляющий операцию «Dithering» с уровнем шума, равным минус 20 дБ. Она уменьшает нелинейность передаточной функции из-за ошибок квантования. Общий коэффициент передискретизации равен 256, и частота дискретизации увеличивается до 11,29 МГц. Во второй ступени модуляции используется SDM 2-го порядка и формируется одноразрядный цифровой поток. К выходу ЦАП подключается время-импульсный цифровой модулятор, преобразующий цифровые данные в последовательность импульсов, модулированных по плотности (PDM).
Если обобщить и упростить, происходит примерно следующее. На вход ЦАП подается поток данных PCM через разъем I2S, подвергается интерполяции (oversampling), далее добавляется шум (dithering), и затем поток подается на реквантователь с обратной связью (noise shaping). В конце формируется однобитный поток, он проходит через аналоговый фильтр нижних частот, где уже и получается конечный звуковой сигнал, который мы слышим.
Многоразрядный ЦАП устроен сложнее: кроме перечисленного, в нем используется еще и технология DEM.

Если хочешь разобраться в деталях, почитай материалы по ссылкам, там есть информация не только о сигма-дельта-ЦАП, но и о сигма-дельта-АЦП.
Современные цифроаналоговые преобразователи — устройства сложные. Но применение этих технологий необходимо для искусственного расширения динамического диапазона, и по большому счету они используются, чтобы преодолеть ограничения форматов CDDA и MP3. Если бы записи изначально выпускали в высоком разрешении PCM (192 × 24), а лучше в формате DSD, то не пришлось бы применять так много технологий и сложных цифровых преобразований. В случае с DSD вмешательство в квантованный сигнал и вовсе не нужно, по крайней мере при воспроизведении.
Заключение
Путь развития звукозаписи и воспроизведения в цифровую эпоху был непростым и тернистым. С изобретением компакт-дисков всего за пару десятилетий звук на аналоговых носителях практически прекратил свое существование. Хорошо это или плохо — каждый решает для себя, но хотелось бы, чтобы оставалась сама возможность выбора. Если не между цифрой и аналогом, то хотя бы как и в каком качестве слушать любимую музыку. К сожалению, сейчас этого выбора почти нет. Сейчас мало кто выпускает музыку в высоком разрешении, кроме энтузиастов на трекерах. Винить в этом можно разве что студии звукозаписи, которые решили ограничиться единственным форматом — CDDA.
Остается только посочувствовать музыкантам! Сколько сил и времени они тратят на создание музыки, но их труд даже не сохраняется в достойном качестве. Выходом могла бы стать запись на мастер-ленту или хотя бы в DSD. Но звукозаписывающие студии не станут тратить лишние усилия, ведь их устраивает текущее положение вещей.