Enterprise проекты: что нужно знать разработчику?
Поговорим о том, что такое enterprise разработка, какие у enterprise проектов могут быть нюансы, и какие навыки нужно обрести для успешной работы в разрезе .NET стека.

Приветствую! Меня зовут Андрей Степанов, я CTO во fuse8. Мне интересно знакомиться с опытом коллег по цеху и делиться своим. В сфере я уже больше 20 лет. В этой статье – наблюдения и рекомендации для интересующихся и тех, кто еще не трогал enterprise, но очень хотел бы.
Предположим, вы изучили язык, фреймворк, инструменты, получили опыт разработки и теперь стоите на распутье:
Путь 1 enterprise разработка: микросервисная архитектура, СУБД, очереди, gRPC и проч.
Путь 2 геймдев: Unity.
Путь 3 CMS (content management system) и DXP (digital experience platform): Kentico, Sitecore, Optimizely.
Предлагаем подробно разобраться в нюансах и узнать, к чему нужно готовиться, если хочется в enterprise.
Что такое enterprise
Приходит бизнес-заказчик и говорит: «Сделайте мне продукт!». Заказчику нужно изобрести «собственный велосипед» для выполнения конкретной бизнес-задачи. Такой «велосипед» – это цельная система, и у нее есть особенности при разработке:
Написание кода, который будет поддерживаться многие годы (ООП, SOLID, GOF-паттерны, Unit-тесты и т.д.);
Сложная бизнес-логика, которая часто меняется;
Использование проверенных фреймворков/библиотек;
Код, доступный для рефакторинга, и создания документации по продукту на его основе;
Регулярность code review.
Максимально качественный код нужно писать сразу, используя разные подходы и паттерны, чтобы в дальнейшем можно было расширять проект. Поскольку проект будет решать определенные бизнес-задачи, нужно готовиться к пониманию и реализации сложной бизнес-логики. Она, кстати, по ходу развития проекта обязательно будет меняться и дополняться, поэтому зазубрить на один раз не выйдет. А еще нужно будет погрузиться в доменную область, в которой будет вестись разработка.
Enterprise проект — это всегда вопрос про деньги. Мы не можем использовать непроверенные решения.
Годятся только проверенные годами фреймворки, библиотеки, и инфраструктурные сервисы. Нельзя рисковать бюджетами и бросаться на первый попавшийся, только что вышедший новый сервис, даже если он кажется лучшим решением на планете.
Доработка и развитие проекта неразрывны с постоянным тестированием. Оно дает возможность дорабатывать или рефакторить код на протяжении долгих лет, а еще – смело трогать в дальнейшем старые участки кода, не боясь что-то сломать. Это важно, потому что подход «работает – не трогай» тут не подойдет. Ну и без код-ревью в этой связке никуда. Этот процесс помогает отлавливать несовершенства и баги еще до приемки тестировщиками, а еще – шарить знания о разработанной фиче с командой, которая потом сможет исправлять и дорабатывать фичу вместо тебя.
Из чего состоит типичное энтерпрайз приложение

Вот у нас есть центральное приложение, и нам, конечно же, для него нужна база данных. Если пишем проект с нуля, то сразу выясняем, какая база данных подойдет лучше, исходя из задач проекта.
Логирование. Недостаточно просто настроить его, нужно подобрать сервис, который будет сохранять логи. Без логирования зачастую невозможно разобраться в проблемах на проде, невозможно восстановить какие-то артефакты.
Метрики и хелсчеки. Мы не можем, запустив проект, отправить уже созданную его часть в свободное плавание, пока сидим и разрабатываем следующую. Сервис может и упасть, а мы этого не узнаем. Падения – это всегда финансовые потери для бизнеса, а их быть не должно. Чтобы их избежать, нужно превентивно, на основании бизнес-метрик, понять, что идет не так, и исправить ситуацию.
Стоит запомнить, что о багах и проблемах на проде разработчики должны узнавать быстрее заказчика.
Помимо логирования стоит предусмотреть error tracking или трекинг исключений и сервис, который будет хранить ошибки отдельно. Трекинг-сервис помогает группировать, анализировать и фильтровать ошибки, отслеживать их частоту, предоставляет более детальную информацию, чем логи, и быстро отправляет нотификации об ошибках. Можно интегрировать трекинг ошибок с чатами. А еще можно создать кастомные интеграции, чтобы, например, сервис отправлял сообщения об обнаруженных ошибках на телефоны разработчиков.
Внутри enterprise приложения должно быть настроено эффективное общение между сервисами: задачи должны выполняться своевременно, нагрузка – распределяться равномерно. В этом помогут очередь, шина, или планировщик задач.
Приложение нужно будет подстроить под деплой. Поэтому разработчику нужно знать, как будет развертываться инфраструктура. Например, нужно определиться с контейнеризацией и оркестрацией – выбрать сервисы и правильно их настроить.
На проекте могут быть DevOps-специалисты, но это не значит, что ответственность за процесс деплоя будет лежать только на них.
Если у нас монолит, мы можем кэшировать данные в памяти. Если микросервисы и для каждого отдельного сервиса могут подниматься несколько инстансов – кэшировать в памяти каждого не выйдет. Не понятно как это потом синхронно обновлять. В таких случаях на помощь приходит распределенный кэш: отдельно поднимается сервис, который хранит определенные данные и предоставляет быстрый доступ к ним. Как правило, это key-value хранилище.
Отдельные файловые хранилища. Зачем? За тем, что хранить файлы просто на диске – не удобно. Хранить файлы в базе данных – проблемно. Поэтому зачастую в enterprise проектах используются отдельные файловые хранилища. Это еще один инфраструктурный сервис.
Для задач, связанных с отображением данных, нужно подключить визуалайзер. Так удобнее следить за метриками, смотреть логи, отслеживать хелс-чеки. Мы, например, используем Grafana, чтобы выводить данные и присылать нотификации. Grafana позволяет все собранные данные отобразить так, чтобы было удобно их совокупно анализировать.
Отдельный блок – code style и анализаторы. Когда команда уже большая или среднего размера, каждый может писать код по-своему. Это порой вызывает споры на код-ревью. Поэтому зачастую на enterprise проектах используются анализаторы, которые помогают автоматически находить проблемы, потенциальные ошибки и проверять единый code style.
Что такое enterprise разработка

Enterprise разработка – это разработка, направленная на решение каких-то конкретных задач, присущих тому или иному бизнесу. Enterprise проектом может быть любая внутренняя система компании, которая используется для оптимизации бизнес процессов. Это может быть как внутреннее корпоративное десктопное приложение, так и мобильное приложение или CRM-система.
Enterprise это легко и одновременно сложно
Вообще, каких-то ярко выраженных характеристик у enterprise проектов нет, поэтому в разговорной речи многие разработчики дают свои определения и классификации. Хотя большая часть программистов соглашается с определением, что enterprise разработка это не создание чего-то нового или использование современных технологий, а, скорее, это обслуживание огромной системы с кучей бизнес логики на проверенных временем технологиях.
Проверенные временем технологии
Это не значит, что весь enterprise это старые технологии по типу Perl, PHP 5.3, Java 5. Все зависит от конкретного бизнеса и его развития, некоторые компании все же обновляют свою кодовую базу и переписывают старые программы, а, точнее, определенные участки на новые технологии. Но далеко не все делают подобные вещи, ибо это утопия. Бизнесу не выгодно тратить большие деньги на “переписывание” программы, если она и так работает и приносит деньги, а какой-то программист ноет, что “все старое” и “надо бы переписать”.
Исторически сложилось, что большинство enterprise проектов были разработаны несколько лет назад (чаще даже больше 10 лет назад). Поэтому в большинстве таких проектов Вы не встретите какие-то новые и популярные технологии просто потому, что их еще не существовало в те времена или они были в зародыше, и сообщество программистов к ним относилось очень скептически. К слову, по этой причине термин легаси-код очень часто можно услышать рядом с термином enterprise.
Бизнес логика
Ну и раз все enterprise приложения это решения для бизнеса, то стоит отметить, что все решения или новые функциональные возможности будут внедряться в проект, отталкиваясь от бизнес логики компании.
Бизнес логика – это совокупность правил, принципов и зависимостей поведения разных объектов. Проще говоря, есть набор правил, из-за которых программист делает именно так и никак иначе, ведь это диктует сам бизнес. В рамках каждого бизнеса своя бизнес логика, и она может быть как относительно легкой (если такое можно применить к данному термину), так и усложненной кучей зависимостей.
На первый взгляд кажется, что в этом нет ничего сложного, просто делай, что от тебя просят. Только вот когда условных “но” переваливает за дюжину, программист начинает понимать, что сейчас придется больше читать код, нежели писать новый код.
Enterprise разработка – это терпение. Здесь чтение кода имеет куда большее значение, чем написание нового, “быстро сделал и в продакшен” уступает размеренному и методическому подходу в доработке и разработке новых функциональных возможностей.
Что позволяет делать лицензия разработчика enterprise
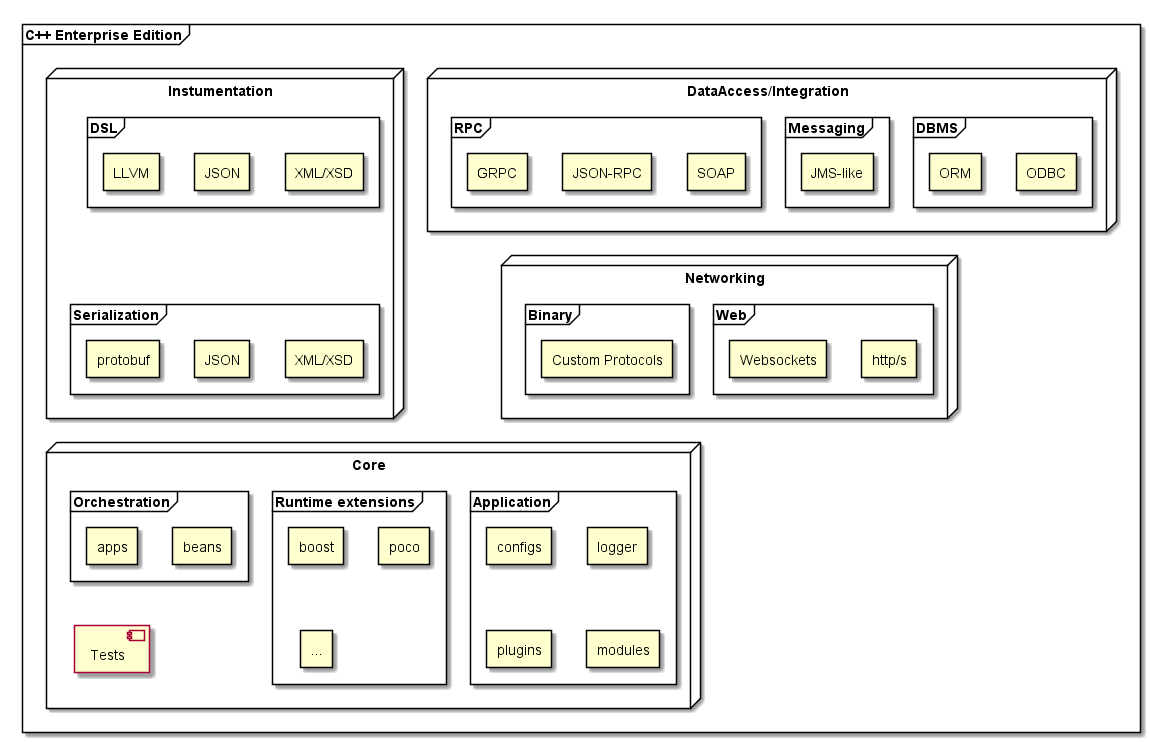
Удивительно, но за все время моей работы в IT, я ни разу не слышал, чтобы кто-то говорил «enterprise edition» относительно языка программирования, кроме как для Java. Но ведь приложения для корпоративного сегмента люди пишут на многих языках программирования, и сущности, которыми оперируют программисты, если не идентичны, то схожи. И для c++ в частности, я бы хотел заполнить пробел enterpr’айзности, хотя бы рассказав об этом.
Применительно к C++, «enterprise edition» — это подмножество языка и библиотек, позволяющее «быстро» разрабатывать [кроссплатформенные] приложения для слабосвязных модульных систем с распределенной и/или кластерной архитектурой и с прикладной бизнес-логикой и, как правило, высокой нагрузкой.
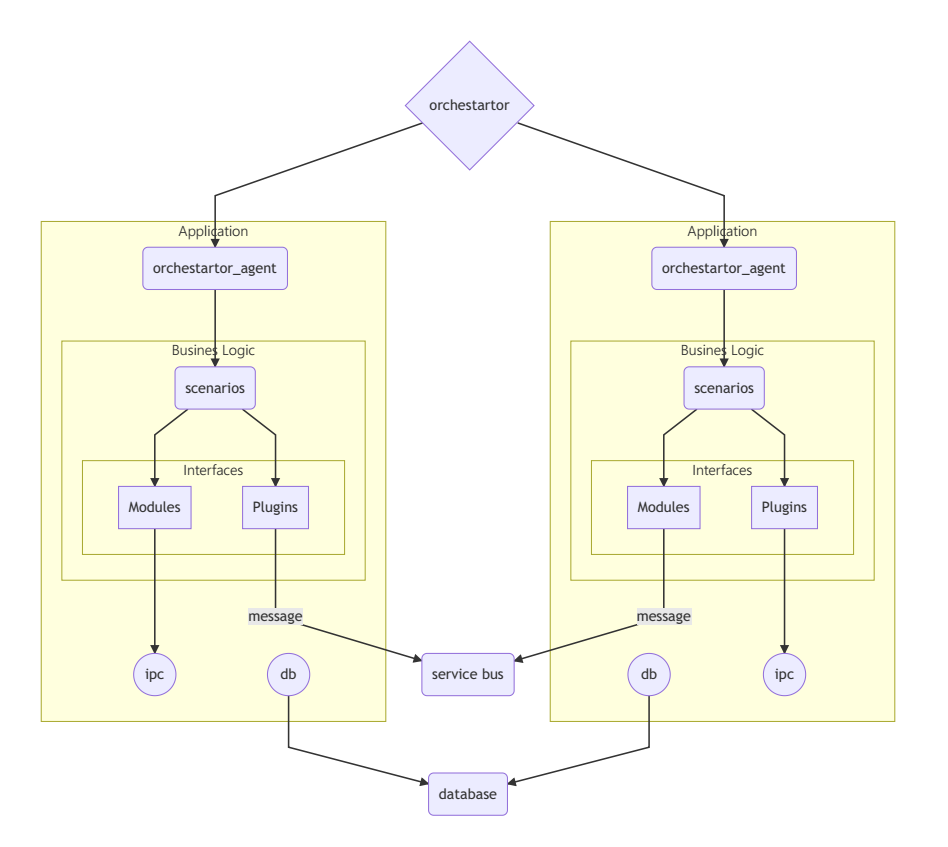
Чтобы продолжить наш разговор, в первую очередь, необходимо ввести понятия приложения, модуля и плагина
- Приложение — это исполняемый файл, который может работать в качестве системной службы, имеет свою конфигурацию, может принимать параметры на вход и может иметь модульно-плагинную структуру.
- Модуль — это реализация интерфейса, живущая внутри приложения или бизнеслогики.
- Плагин — это динамически загружаемая библиотека, в которой реализован один или несколько интерфейсов, либо часть бизнеслогики.
Все приложения, выполняя свою уникальную работу, как правило нуждаются в общесистемных механизмах, таких как, доступ к данным (СУБД), обмен информацией через общую шину (JMS), исполнение распределенных и локальных сценариев с сохранением консистентности (Транзакции), обработка запросов, приходящих, например, по протоколу http(s) (fastcgi) или через websocket’ы и т.д… Каждое приложение должно иметь возможность оркестровки своих модулей (OSGI), а в распределенной системе должна быть возможность оркестровки приложений.
Пример схемы распределенной слабосвязной системы
Приложение
Пример схемы «корпоративного» серверного приложения.

Общее определение приложению, я уже дал, так что разберемся, что же сейчас есть в мире C++ для имплементации этого понятия. Первыми показали реализацию приложения графические фреймворки, такие как Qt и GTK, но их версии приложения изначально предполагали, что приложение — это графическое «окно» со своим контекстом и только спустя время появилось общее видение приложения, в том числе и как системной службы, например, qtservice. Но тащить условно графический фреймворк для сервисной задачи не очень хочется, так что посмотрим в сторону неграфических библиотек. И первым на ум приходит boost… Но к сожалению в списке официальных библиотек нет Boost.Application и ей подобных. Есть отдельный проект Boost.Application. Проект весьма интересный, но, на мой взгляд, многословный, хотя идеология boost соблюдена. Вот пример приложения от Boost.Application
В приведенном примере определяется приложение myapp со своим основным рабочим потоком worker и механизм запуска этого приложения.
В качестве дополнения приведу аналогичный пример из фреймворка pocoproject
Обращаю Ваше внимание на то, что приложение должно содержать механизмы журналирования, загрузки конфигураций и обработки опций.
Например, для обработки опций есть :
Слабосвязность, модули и плагины.
Слабосвязность в «корпоративной» системе — это возможность быстрой и безболезненной подмены тех или иных механизмов. Это касается как модулей внутри приложения, так и самих приложений, как реализаций, например, микросервисов. Что же у нас есть, с точки зрения C++. С модулями все плохо, хоть они и реализуют интерфейсы, но живут внутри «скомпилённого» приложения, так что быстрой подмены не будет, но на помощь приходят плагины! С помощью динамических библиотек можно не только организовать быструю подмену, но и одновременную работу двух разных версий. Есть еще целый мир «удаленного вызова процедур» он же RPC. Механизмы поиска реализаций интерфейсов в купе с RPC, породили нечто похожее на OSGI из мира Java. Здорово иметь поддержку этого в экосистеме C++ и она есть, вот пара примеров:
Пример модуля для «сервера приложения» POCO OSP
Пример модуля для «серврера приложения» Apache Celix
Хочется отметить, что в распределенных слабосвязных системах необходимо иметь механизмы обеспечивающие транзакционность операций, но на текущий момент для C++ ничего подобного нет. Т.е. как нет возможности внутри одного приложения выполнить запрос к базе данных, файлу и esb в рамках одной транзакции, так и нет такой возможности для распределенных операций. Безусловно все можно написать, но чего-то обобщённого нет. Кто-то скажет, что есть software transactional memory , да, конечно, но это лишь облегчит написание транзакционных механизмов собственными силами.
Инструментарий
Из всего множество вспомогательных инструментов хочу выделить сериализацию и DSL, т.к. их наличие позволяет реализовать многие другие компоненты и сценарии.
Сериализация
Сериализация — процесс перевода какой-либо структуры данных в последовательность битов. Обратной к операции сериализации является операция десериализации (структуризации) — восстановление начального состояния структуры данных из битовой последовательности wikipedia. В контексте C++ важно понимать, что на сегодняшний день нет возможности сериализации объектов и передачи их в другую программу, которая об этом объекте ранее ничего не знала. Под объектом в этом случае я понимаю реализацию некоего класса с полями и методами. Поэтому выделю два основных подхода, применяемые в мире C++ :
- сериализация в бинарный формат
- сериализация в формализованный формат
В литературе и интернете часто встречается разделение на бинарный и текстовый формат, но я считаю такое разделение не совсем правильным, например, MsgPack не сохраняет информацию о типе объекта, соответственно, отдается контроль за правильным отображением программисту и формат MsgPack — бинарный. Protobuf, напротив, сохраняет всю метаинформацию в промежуточное представление, что позволяет использовать его между разными языками программирования, при этом, Protobuf тоже бинарный.
Итак процесс сериализации, зачем он нам нужен. Для раскрытия всех нюансов, нужна еще одна статья, я постараюсь объяснить на примерах. Сериализация позволяет, оставаясь в терминах языка программирования, «упаковывать» программные сущности (классы, структуры) для передачи их по сети, для персистентного хранения, например, в файлах и других сценариев, которые, без сериализации, заставляют нас придумывать собственные протоколы, учитывать аппаратную и программную платформу, кодировку текста и.т.д.
Приведу пару примеров библиотек для сериализации:
Domain Specific Language — язык программирования для вашей предметной области. Действительно, когда мы занимаемся автоматизацией какого-то предприятия, то мы сталкиваемся с предметной областью заказчика и все бизнес-процессы описываем в терминах предметной области, но как только дело доходит до программирования, то программисты вместе с аналитиками занимаются отображением понятий бизнес-процессов в понятия фреймворка и языка программирования. И если бизнес-процессов не определенное количество, а предметная область определена достаточно строго, то имеет смысл создать свой DSL, для имплементации большей части существующих сценариев и добавления новых. В мире с++ не так много возможностей «быстрой» реализации своего DSL. Есть, конечно, механизмы встраивания lua, javascript и других языков программирования в C++-программу, но кому нужны уязвимости и потенциально неконтролируемый движок исполнения «всего» ?! Так что разберем те инструменты, что позволяют делать DSL самому.
Библиотека Boost.Proto как раз создана для создания собственных DSL, это её прямое предназаначение, вот пример
- Реализации на базе flex и bison
Flex и Bison используются для генерации лексеров и парсеров придуманных Вами грамматик. Синтаксис не простой, но задачу решает эффективно.
Пример кода для генерации лексера
А еще, существует спецификация SCXML — State Chart XML: State Machine Notation for Control Abstraction, описание конечного автомата в XML-подобной разметке. Это не совсем DSL, но тоже удобный механизм автоматизации процессов без программирования. Отличная имплементация есть у Qt SCXML. Есть и другие рализации, но они не такие гибкие.
Это пример FTP клиента в SCXML нотации, пример взят с сайта Qt Documentation
А так это выглядит в визуализаторе SCXML

Доступ к данным и Интеграция
Это, пожалуй, одна из самых «наболевших» тем в мире с++. Мир данных для с++ разработчика всегда связан с необходимостью уметь отображать их на сущности языка программирования. Строку в таблице — в объект или структуру, json — в класс и так далее. В отсутствие рефлексии — это огромная проблема, но мы, с++-ники, не отчаиваемся и находим различные выходы из ситуации. Начнем с СУБД.
Сейчас буду банален, но единственным универсальным механизмом доступа к реляционным СУБД является ODBC, других вариантов пока не придумали, но с++-сообщество не стоит на месте и на сегодняшний день есть библиотеки и фреймворки, предоставляющие обобщённые интерфейсы доступа к нескольким СУБД.
В первую очередь упомяну библиотеки, предоставляющие унифицированный доступ к СУБД с помощью клиентских библиотек и SQL
Все они хороши, но заставляют помнить о нюансах отображения данных из БД в объекты и структуры с++, плюс эффективность SQL-запросов сразу ложиться на ваши плечи.
Следующими примерами будут ORM на C++. Да такие есть! И кстаи, SOCI, поддерживает механизмы ORM, через специализацию soci::type_conversion, но её я намеренно не включил, так как это не прямое её предназначение.
-
— ORM, позволяющий взаимодействовать с СУБД SQLite3, PostgreSQL, MySQL. Эта библиотека требует от программиста предварительного оформить xml-файлы с описанием объектов и отношений, чтобы, с помощью litesql-gen сгенерировать дополнительные исходники. — очень интересная ORM, позволяет оставаться в рамках C++, не использую промежуточные файлы описания, вот небольшой пример :
-
— большой фреймворк, о нем можно вообще отдельную статью написать, тоже содержит ORM, умеющий взаимодействовать с СУБД Sqlite3, Firebird, MariaDB/MySQL, MSSQL Server, PostgreSQL и Oracle.
- Отдельно хочется упомянуть ORM над sqlite sqlite_orm и hiberlite. Так как sqlite встраиваемая СУБД, а ORM для него проверяет запросы, да и вообще все взаимодействие с БД, в compile-time, то инструмент становится очень удобным для быстрого развертывания и прототипирования. — ORM для Qt5 с поддержкой Postgresql. Пропитан идеями hibernate от java.
Хоть и интеграцию через СУБД считают «интеграцией», я предпочту оставить это за скобками и перейти к интеграции через протоколы и API.
RPC — remote porocess call, всем известная техника взаимодействия «клиента» с «сервером». Как и в случае c ORM, главная трудность — это написание/генерация различных вспомогательных файлов для связывания протокола с реальными функциями в коде. Я намеренно не буду упоминать различные RPC, реализованные непосредственно в операционной системе, а сосредоточусь на кроссплатформенных решениях.
-
— фреймворк от Google для удалённого вызова процедур, весьма популярный и эффективный фреймворк от google. В основе своей использует google protobuf, его я упоминал в разделе сериализация, поддерживает множество языков программирования, но в корпрративной среде пока новичок.
- json-rpc — RPC, где в качестве протокола используется JSON, хороший пример реализации — это библиотека libjson-rpc-cpp, вот пример файла описания :
На основе этого описания генерятся клиентский и серврерный код, который можно использовать в своем приложении. Вообще есть спецификация для JSON-RPC 1.0 и 2.0. Так что вызвать функцию из web-приложения, а обработать в C++ труда не составит.
- XML-RPC и SOAP — тут явный лидер — это gSOAP, очень мощная библиотека, не думаю, что есть достойные альтернативы. Также как и в предыдущем примере, содаем промежуточный файлик с xml-rpc или soap содержимым, натравливаем на него генератор, получаем код и пользуемся. Типичные примеры запроса и ответа в нотации xml-rpc:
-
— очень интересный проект от pocoproject. Позволяет определеять какие классы, функции и т.п. могут быть вызваны удаленно с помощью аннотаций в комментариях. Вот пример,
Для генерации вспомогательного кода используется собственный «компилятор». Долгое время эта функциональность была только в платной версии POCO Framework, но с появлением проекта macchina.io, Вы можете пользоваться этим бесплатно.
Messaging — несколько широкое понятие, но я разберу его с точки зрения обмена сообщениями через общую шину данных, а именно пройдусь по библиотекам и серврерам реализующим Java Message Service используя различные протоколы, например AMQP или STOMP. Общая шина данных, она же Enterprise Servise Bus (ESB), очень распространена в решениях корпоративного сегмента, т.к. позволяет достаточно быстро интегрировать различные элементы IT-инфраструктуры между собой, используюя паттерн «точка-точка» и «публикация-подписка». Промышленных брокеров сообщений, написанных на C++, мало, я знаю два: Apache Qpid и UPMQ, причем второй написан мной. Есть еще Eclipse Mosquitto, но он написан на си. Прелесть JMS для java заключается в том, что Ваш код не зависит от протокола, который использует клиент и сервер, JMS как ODBC, декларирует функции и поведение, так что Вы можете хоть деясть раз на дню менять JMS-провайдера и не переписывать код, для C++ такого, к сожалению нет. Вам прийдется переписывыать клиентскую часть под каждого провайдера. Перечислю, на мой взгляд, самые популярные C++ библиотеки для не менее популярных брокеров сообщений:
-
— клиентская библиотека к брокеру Apache AcriveMQ, который написан на java. — наверное самый популярный брокер сообщений, имеет несколько библиотек на C/C++. — проприетарщина, но с очень развитым функционалом. — тоже, он от Oracle — версия от Microsoft
Принцип по которому эти библиотеки предоставляют функиональность общий, как правило соответствует спецификации JMS. В связи с этим есть желание собрать группу единомышленников и написать некое подобие ODBC, но для брокеров сообщений, чтобы каждый программист на C++ страдал чуть меньше, чем обычно.
Сетевое взаимодействие
Я умышлено оставил все что связано непосредственно с сетевым взаимодействием на последок, т.к. на этом поприще у C++ разработчиков меньше всего проблем, на мой взгляд. Остается лишь выбрать паттерн, который ближе всего к Вашему решению, и фреймворк, его реализующий. Прежде чем перечислить самые популярные библиотеки, хочу отметить важную деталь разработки собственных сетевых приложений. Если Вы решили придумать собственный протокол поверх TCP или UDP, будьте готовы, что всякие «умные» средства защиты будут блокировать Ваш трафик, так что озаботьтесь упаковкаой своего протокола, например, в https или могут быть проблемы. Итак, библиотеки :
Apple Developer Enterprise Program
The Apple Developer Enterprise Program allows large organizations to develop and deploy proprietary, internal-use apps to their employees. This program is for specific use cases that require private distribution directly to employees using secure internal systems or through a Mobile Device Management solution.
Eligibility
The Apple Developer Enterprise Program is only for the internal use and distribution of proprietary apps in specific use cases that are not adequately addressed with public apps on the App Store, custom apps through Apple Business Manager or Ad Hoc distribution, or beta testing through TestFlight. Your proprietary app must be developed by you for use on Apple platforms.
In addition, the following eligibility requirements apply. Your organization must:
- Have 100 or more employees.
- Be a legal entity. We do not accept DBAs, fictitious businesses, trade names, or branches.
- Use the program only to create proprietary, in-house apps for internal use, and to distribute these apps privately and securely to employees within the organization.
- Have systems in place to ensure only employees can download your internal-use apps, and to protect membership credentials and assets.
- Participate in and pass Apple’s verification interview and continuous evaluation process.
Applying
Application
As the person applying to the Apple Developer Enterprise Program on behalf of your organization, you must have the legal authority to bind your organization to legal agreements. You must be the organization’s owner/founder, executive team member, senior project lead, or have legal authority granted to you by a senior employee. To start your application, sign in with your Apple ID with two-factor authentication turned on. If you’re already enrolled in the Apple Developer Program for distributing apps on the App Store, or have an iTunes Connect account for distributing another media type (music, TV, movies, or books), you will need to use a different Apple ID.
Verification
Verification is conducted to authenticate your organization’s information, to validate your intended use of the program, and to ensure that the App Store, Apple Business Manager, Ad Hoc distribution, or TestFlight would not adequately meet your needs. Your organization must have a D-U-N-S Number, which is a unique nine-digit number assigned by Dun & Bradstreet and widely used as a standard business identifier. You can check to see if your organization already has a D-U-N-S Number and request one if necessary. They are free in most jurisdictions. Your organization must also have a publicly available website with a domain name that’s associated with your organization. In addition, we may contact your organization to verify other details and continue to evaluate your use of the program. If you choose to renew your membership, your organization will be verified again. Apple reserves the right to reject your application at its sole discretion.
Agreement and Payment
If your organization is approved for membership in the Apple Developer Enterprise Program, you will receive the enterprise program license agreement for review and acceptance. The Apple Developer Enterprise Program is 299 USD per membership year or in local currency where available.
Getting Started
The Apple Developer Program allows you to distribute public apps on the App Store, beta versions of apps through TestFlight, and custom apps to specific businesses, including your organization, through Apple Business Manager or Ad Hoc distribution. The Apple Developer Enterprise Program is only for specific use cases that are not addressed with these options. Before applying, use the drop down below to find out which program is best for you.
What types of apps will you distribute?
Please enroll in the Apple Developer Program instead. You’ll get access to resources for public app distribution on the App Store, distribution through Apple Business Manager, Ad Hoc distribution, and beta testing through TestFlight.
Please enroll in the Apple Developer Program instead. You’ll get access to resources for custom app distribution through Apple Business Manager, Ad Hoc distribution, beta testing through TestFlight, and public app distribution. Your customer can use Apple Business Manager or redemption codes to privately distribute custom apps. (Note: If you’re an organization purchasing an app that has been customized for you, simply create an account to access the app on Apple Business Manager. You do not need to join a developer program.)
Please learn about the Apple Developer Program first. The Apple Developer Program is the right option for most organizations that want to distribute proprietary, internal-use apps. It allows you to use Apple Business Manager, Ad Hoc distribution, or redemption codes to privately distribute custom apps to employees, and TestFlight to test beta versions of your apps.
The Apple Developer Enterprise Program is only for specific use cases that cannot be addressed using these methods. Before applying for the Apple Developer Enterprise Program, learn more about the Apple Developer Program to see if it addresses your use case. If not, you can start your application.
В чём разница между популярными Open Source лицензиями? Объясняет Github
В сентябре Github добавила на страницы проектов, которые используют стандартные Open Source лицензии, секцию, в которой эта лицензия указывается:

После переработки условий использования сервиса, которые прояснили (наконец-то) правовой статус GitHub относительно проектов, которые он хранит, компания решила пойти дальше в том, чтобы помочь пользователям разобраться, на что они имеют право, а на что — нет. С этой целью на страницу просмотра файла LICENSE из корневой директории проекта были добавлены краткие сведения о лицензии с сайта Choose A License:

Мы решили перевести для вас эти замечания, чтобы вы в случае необходимости могли быстро вспомнить, зачем нужна та или иная лицензия. Ниже мы приводим краткие описания лицензий и таблицы, которые содержат три колонки:
- Первая содержит информацию о том, что лицензия вам разрешает делать с проектом (авторское право или закрытые лицензии обычно, напротив, запрещают делать это);
- Вторая — о том, какие ограничения лицензия накладывает на тех, кто модифицирует или распространяет работу;
- Последняя — о том, чего лицензия не гарантирует и чего не разрешает.
Пояснения некоторых значений таблиц
Разрешения * распространять, * использовать в коммерческих целях или * изменять работу значат ровно то, что написано — вы можете пользоваться этими правами, но лишь до тех пор, пока соблюдаете условия, указанные в секциях * «Требует» и * «Запрещает».
Пункт * «Разрешает личное использование» (англ. private use) означает, что если вы изменяете работу, вы не обязаны её распространять — на своей машине вы можете делать с кодом всё, что захотите.
Пункт * «Предоставление патентных прав» означает что соавторы работы (контрибьюторы) отказываются от патентных прав (если они есть) на те части кода, которые они добавили; это гарантирует безопасность при использовании работы — иск на вас точно не подадут.
Пункты * «Отказ от ответственности» и * «Никакой гарантии» означают, что ни при каких условиях авторы произведения не могут быть ответственны за последствия его использования, продажи и вообще чего угодно.
GNU AGPLv3
Разрешает:
* Коммерческое использование
* Распространение
* Изменение
* Личное использование
* Предоставление патентных прав
Требует:
* Распространять исходный код вместе с продуктом
* Упоминания авторства и лицензии в работе
* Указывать изменения, внесённые в работу
* Использование по сети приравнивается к распространению
* Производные продукта необходимо выпускать под той же лицензией
Запрещает:
* Отказ от ответственности
* Никакой гарантии
Это самая сильная копилефтная лицензия из всех существующих. Она разрешает делать с кодом всё, что угодно, но взамен от всех, кто изменяет или распространяет произведение, требуется указание исходного авторства, распространение исходного кода вместе с работой (или предоставление его по первому требованию), а также указание того, что в работу были внесены изменения. При этом производные работы должны публиковаться строго под этой же лицензией, без исключений. Лицензия гарантирует, что к пользователю (распространителю) не будут применены никакие требования из-за патентных прав.
Отличительной особенностью этой лицензии от основной лицензии GPL является то, что если кто-то предоставляет доступ к программе по сети (например, через интернет), то это считается распространением, а значит, распространитель обязан представлять исходный код, если от него этого потребуют.
GNU GPLv3
Оригинальный текст Перевод на русский
Разрешает:
* Коммерческое использование
* Распространение
* Изменение
* Личное использование
* Предоставление патентных прав
Требует:
* Распространять исходный код вместе с продуктом
* Упоминания авторства и лицензии в работе
* Указывать изменения, внесённые в работу
* Производные продукта необходимо выпускать под той же лицензией
Запрещает:
* Отказ от ответственности
* Никакой гарантии
Это самая популярная копилефтная лицензия. От предыдущей она отличается только тем, что не приравнивает использование программы по сети к её распространению.
GNU LGPLv3
Оригинальный текст Перевод на русский
Разрешает:
* Коммерческое использование
* Распространение
* Изменение
* Личное использование
* Предоставление патентных прав
Требует:
* Распространять исходный код вместе с продуктом
* Упоминания авторства и лицензии в работе
* Указывать изменения, внесённые в работу
* Производные продукта необходимо выпускать под той же лицензией (но можно использовать продукт в качестве библиотеки)
Запрещает:
* Отказ от ответственности
* Никакой гарантии
От основной GPL лицензии эта отличается тем, что использование работы под LGPL в качестве части для большей работы (т.е. в качестве библиотеки) не накладывает требования лицензировать большую работу под LGPL, или открывать её исходный код. Но код самой библиотеки все равно должен предоставляться по первому требованию.
Mozilla Public License 2.0
Разрешает:
* Коммерческое использование
* Распространение
* Изменение
* Личное использование
* Предоставление патентных прав
Требует:
* Распространять исходный код вместе с продуктом (в случае использования в качестве библиотеки — только исходный код библиотеки)
* Упоминания авторства и лицензии в работе
* Производные продукта необходимо выпускать под той же лицензией (но можно использовать продукт в качестве библиотеки)
Запрещает:
* Отказ от ответственности
* Никакой гарантии
* Не передаются права на торговые марки
Ещё одна лицензия, которая хорошо подходит для библиотек из-за слабого копилефта. В отличие от LPGL, при использовании работы под этой лицензией в качестве библиотеки, не нужно открывать даже исходный код самой библиотеки, равно как и указывать изменения, которые были внесены в работу.
Лицензия отдельно оговаривает, что для производных работ нельзя использовать те же названия, если они являются торговым марками.
The MIT License
Оригинальный текст Перевод на русский
Разрешает:
* Коммерческое использование
* Распространение
* Изменение
* Личное использование
Требует:
* Упоминания авторства и лицензии в работе
Запрещает:
* Отказ от ответственности
* Никакой гарантии
Одна из так называемых «разрешительных» лицензий — с работой можно делать что угодно до тех пор, пока вы указываете автора оригинальной работы. Производные работы можно выпускать под другой лицензией и не открывать их исходники. Однако эта лицензия не гарантирует пользователю патентных прав, поэтому вместо неё рекомендуется использовать Apache License, которая приведена ниже.
Apache License 2.0
Разрешает:
* Коммерческое использование
* Распространение
* Изменение
* Личное использование
* Предоставление патентных прав
Требует:
* Упоминания авторства и лицензии в работе
* Указывать изменения, внесённые в работу
Запрещает:
* Никаких обязательств
* Никакой гарантии
* Не передаются права на торговые марки
Ещё одна разрешительная лицензия — от пользователей она требует только, если работа была изменена, писать об этом, и, конечно, указывать исходное авторство. Лицензия отдельно оговаривает, что для производных работ нельзя использовать те же названия, если они являются торговым марками.
The Unlicense
Разрешает:
* Коммерческое использование
* Распространение
* Изменение
* Личное использование
* Предоставление патентных прав
Требует:
(Ничего не требует)
Запрещает:
* Никаких обязательств
* Никакой гарантии
Выпуская работу под этой лицензией, вы отказываетесь от всех прав на неё, буквально передавая её в общественное достояние — на тех, кто её использует, не накладывается никаких ограничений. Приятная новость в том, что вы не будете нести ответственность за то, что написали — отсутствие гарантии здесь прописано так же, как и везде.
А как же остальные лицензии? Как же BSD?
Этого набора более чем достаточно, если вы хотите выбрать лицензию для своего Open Source проекта — не надо писать свою лицензию или использовать что-то более специфическое. Путаница, которая возникает из-за обилия лицензий и их совместимости друг с другом — актуальная проблема Open Source. Лицензия BSD достаточно популярна, но её сокращённый вариант полностью совпадает по смыслу с лицензией MIT, и GNU советуют использовать именно последнюю. Если же вы столкнулись с проектом, который использует какую-то нестандартную лицензию, и хотите узнать, что она вам разрешает, вы можете подсмотреть в шпаргалке на сайте Choose A License.
Что такое энтерпрайз(Enterprise) в контексте программирования?
Иногда встречаю понятие энтерпрайз программирование или энтерпрайз код. Какое этому понятию можно дать определение ? И почему часто это употребляется как что-то негативное?
P.S. Понимаю что вопрос не зависит от языка, но ответ интересует относительно .Net платформы.

Всякие сервисы, базы данных и их интеграции между собой. Чаще всего это инфраструктура организаций, всякие CRMы, 1Сы и прочее. Нелюбимо творческими программистами за то, что это b2b, которым нельзя похвастаться перед друзьями, а Ъ-программисты ругают «галерных» программистов, что работа эта не творческая, рутинная, а исполнители — бестолковые и неквалифицированные, которые не могут в бородатые стартапы. Ну и так как этими системами клиентов не завлекают, то там гнездятся тонны легаси-кода.
Можно сказать, что зависит от языка. В подавляющем большинстве случаев это Java и .NET.
Постройка дома/дачи-это обычные проекты, хоть и бывают сложные
Строительство МКД на 1000+ квартир по ГОСТу в 70-100+ лет эксплуатации это Энтерпрайз.
По моим наблюдениям, Энтерпрайз решение должно обладать следующими характеристиками:
1) широкий масштаб разработки (международная компания или хотя бы специалисты из разных городов и областей, разные направления специалистов, часто решение находится на стыке научных изысканий)
2) большое количество пользователей (от 1 млн пользователей примерно)
3) решение, которое охватывает целую отрасль и более (т е находится в топе среди подобных решений в рамках мира или хотя бы большой страны/группы стран)
4) решение стабильное, отказоустойчивое, предсказуемое и требующее минимум изменений с течением долгого времени эксплуатации (т е даже спустя десятилетия, данное решение будет оптимальным решением вне зависимости от смены технологий, подходов и прочих как внешних, так и внутренних условий)
Почему негативное? Это субъективно-код получается неубиваемый, живучий и местами сложно понимаемый. Здесь нужно терпение и быстро результат нельзя получить, равно как и все новомодное встраивается очень медленно в виду сложности решения.