Как вывести повторяющиеся значения в столбце на T-SQL? Microsoft SQL Server
Приветствую всех на сайте Info-Comp.ru! В этой небольшой заметке я покажу, как можно на SQL вывести повторяющиеся значения в столбце таблицы в Microsoft SQL Server. Все будет рассмотрено очень подробно и с примерами.
Исходные данные для примеров
Сначала давайте я расскажу, какие данные я буду использовать в статье, чтобы Вы четко понимали и видели, какие результаты будут возвращаться, если выполнять те или иные действия.
Сразу скажу, что все данные тестовые.
Следующей инструкцией мы создаем таблицу Goods и добавляем в нее несколько строк, в некоторых из которых значение столбца Price будет повторяться.
Останавливаться на том, что делает та или иная инструкция, я не буду, так как это другая тема, если Вам интересно, можете более подробно посмотреть в следующих статьях:
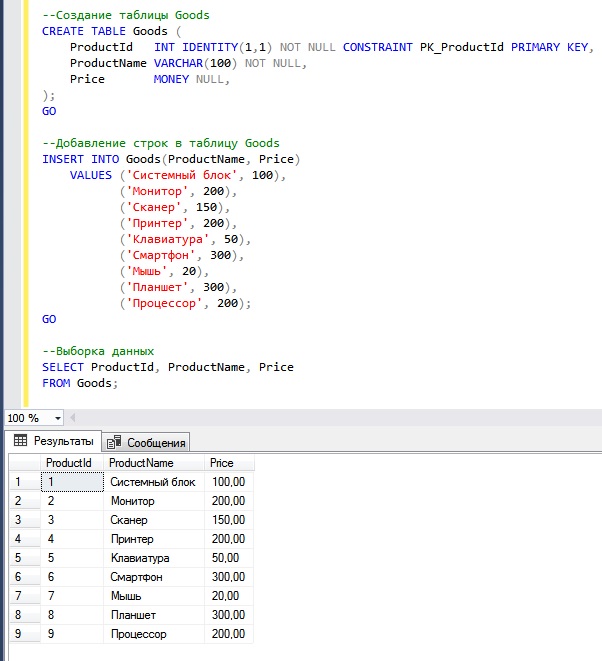
Вы видите, какие данные есть, именно к ним я буду посылать SQL запрос, который будет определять и выводить повторяющиеся значения в столбце Price.
Выводим повторяющиеся значения в столбце на T-SQL
Основной алгоритм определения повторяющихся значений в столбце состоит в том, что нам нужно сгруппировать все строки по столбцу, в котором необходимо найти повторяющиеся значения, и подсчитать количество строк в каждой сгруппированной строке, а затем просто поставить фильтр (>1) на итоговое количество, отбросив тем самым строки со значением 1, т.е. если значение встречается всего один раз, значит, оно не повторяется, и нам не нужно.
Вот пример всего вышесказанного.
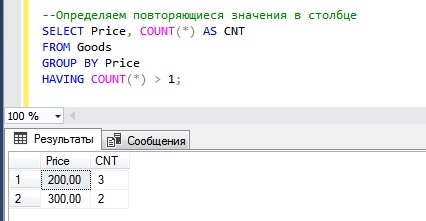
Мы видим, что у нас есть всего два значения, которые повторяются — это 200 и 300. Первое значение, т.е. 200, повторяется 3 раза, второе — 2 раза.
Данные сгруппировали мы конструкцией GROUP BY, подсчитали количество значений встроенной функцией COUNT, а отфильтровали сгруппированные строки конструкцией HAVING.
Выводим все строки с повторяющимися значениями на T-SQL
Но в большинстве случаев просто узнать повторяющиеся в столбце значения недостаточно, иногда необходимо вывести все записи в этой таблице, которые содержат эти повторяющиеся значения.
Это можно реализовать с помощью подзапроса, но использовать подзапрос, в котором будет группировка, не очень удобно, и уж точно неудобочитаемо. Поэтому мне нравится в каких-то подобных случаях использовать CTE (обобщённое табличное выражение) для повышения читабельности кода. Также чтобы сделать результирующий набор данных более наглядным, его можно отсортировать по целевому столбцу, тем самым мы сразу увидим строки с повторяющимися значениями.
Вот пример, в котором мы выводим все строки с повторяющимися значениями в столбце, отсортированные по столбцу Price.
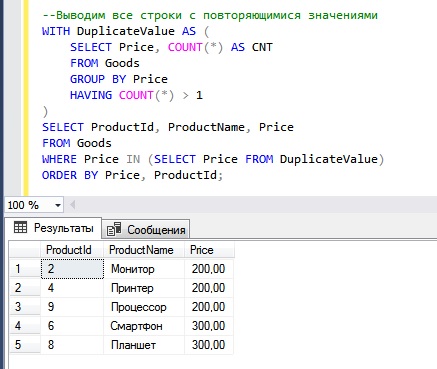
Как видим, сначала у нас идут все строки со значением 200, а затем строки со значением 300. Сортировку мы осуществили конструкцией ORDER BY. Если у Вас возникает вопрос, что такое DuplicateValue, то это всего лишь название CTE выражения, в принципе Вы его можете назвать и по-другому.
Заметка!
Для комплексного изучения языка T-SQL рекомендую почитать мои книги и пройти курсы:
Как вывести дубликаты в sql
Создание игр на Unreal Engine 5
Данный курс научит Вас созданию игр на Unreal Engine 5. Курс состоит из 12 модулей, в которых Вы с нуля освоите этот движок и сможете создавать самые разные игры.
В курсе Вы получите всю необходимую теоретическую часть, а также увидите массу практических примеров. Дополнительно, почти к каждому уроку идут упражнения для закрепления материала.
Помимо самого курса Вас ждёт ещё 8 бесплатных ценных Бонусов: «Chaos Destruction», «Разработка 2D-игры», «Динамическая смена дня и ночи», «Создание динамической погоды», «Создание искусственного интеллекта для NPC», «Создание игры под мобильные устройства», «Создание прототипа RPG с открытым миром» и и весь курс «Создание игр на Unreal Engine 4» (актуальный и в 5-й версии), включающий в себя ещё десятки часов видеоуроков.
Подпишитесь на мой канал на YouTube, где я регулярно публикую новые видео.
Подписаться

Подписавшись по E-mail, Вы будете получать уведомления о новых статьях.
Подписаться
Добавляйтесь ко мне в друзья ВКонтакте! Отзывы о сайте и обо мне оставляйте в моей группе.
Мой аккаунт Моя группа
Какая тема Вас интересует больше?
Основы Unreal Engine 5
Пройдя курс:
— Вы получите необходимую базу по Unreal Engine 5
— Вы познакомитесь с множеством инструментов в движке
— Вы научитесь создавать несложные игры
Общая продолжительность курса 4 часа, плюс множество упражнений и поддержка!
Find duplicate records in MySQL
I want to pull out duplicate records in a MySQL Database. This can be done with:
Which results in:
I would like to pull it so that it shows each row that is a duplicate. Something like:
Any thoughts on how this can be done? I’m trying to avoid doing the first one then looking up the duplicates with a second query in the code.
28 Answers 28
The key is to rewrite this query so that it can be used as a subquery.
Why not just INNER JOIN the table with itself?
A DISTINCT is needed if the address could exist more than two times.

I tried the best answer chosen for this question, but it confused me somewhat. I actually needed that just on a single field from my table. The following example from this link worked out very well for me:
Isn’t this easier :
10 000 duplicate rows in order to make them unique, much faster than load all 600 000 rows.
This is the similar query you have asked for and its 200% working and easy too. Enjoy.
Find duplicate users by email address with this query.

we can found the duplicates depends on more then one fields also.For those cases you can use below format.

Finding duplicate addresses is much more complex than it seems, especially if you require accuracy. A MySQL query is not enough in this case.
I work at SmartyStreets, where we do address validation and de-duplication and other stuff, and I’ve seen a lot of diverse challenges with similar problems.
There are several third-party services which will flag duplicates in a list for you. Doing this solely with a MySQL subquery will not account for differences in address formats and standards. The USPS (for US address) has certain guidelines to make these standard, but only a handful of vendors are certified to perform such operations.
So, I would recommend the best answer for you is to export the table into a CSV file, for instance, and submit it to a capable list processor. One such is LiveAddress which will have it done for you in a few seconds to a few minutes automatically. It will flag duplicate rows with a new field called "Duplicate" and a value of Y in it.
SQL-запрос на вывод повторяющихся строк таблицы
При работе с базами данных довольно часто возникает ситуация, когда нужно вывести повторяющиеся строки в таблице или повторяющиеся значения некоторых из полей строк.
Предположим, есть таблица TableName, содержащая некое поле DuplicateField. Нужно выбрать все строки, содержащие дублирующиеся значения поля DuplicateField и их количество. Т.е. выбрать те строки, в которых в поле записано одно и тоже значение более одного раза. Тогда запрос на выбор дублирующихся строк для поля DuplicateField может выглядеть так:
Чтобы выбрать конкретные дублирующиеся элементы, содержащие только значение @SomeValue (параметр), можно добавить условие «WHERE»:
Если нужно провести выборку по нескольким повторяющимся полям, то sql-запрос может выглядеть так:
И, наконец, если нужно вывести полные строки, содержащие все поля (выбрать *), в которых дублируется одно поле, сделать это можно таким sql-запросом:
Если нужно выбрать все поля и строки таблицы, в которых в разных строках повторяются комбинации значений двух и более полей, то sql-запрос будет немного сложнее. Для sql-сервера (Transact-SQL), с применением логического оператора Exists, запрос sql может быть таким :