Разработка высоконагруженных проектов для начинающих
Вообще, высоконагруженные проекты могут быть разными. Например, на ваш новостной сайт приходит миллион-другой посетителей в сутки, но это такие хорошие, спокойные посетители, почитали себе статью, в крайнем случае, оставили комментарий, и ушли.
Другое дело, когда вы разрабатываете соцсеть, и по цифрам видите те же самые миллион-другой человек в сутки, но тут уже совсем другая история – они без конца чего-то постят, пишут друг другу, загружают фоточки и т.д.
Если вы (как я однажды) мирно писали себе скромные сайтики, интернет-магазины или туристические порталы с посещаемостью до 5 тысяч человек в сутки и вдруг попали в разработку соцсети или подобного проекта, то это может для вас выглядеть приблизительно так:
В этом случае вам могут помочь некоторые советы и практические приемы.
Что может сделать обычный программист, чтобы ускорить работу приложения?
Прежде всего, попросить денег на новое оборудование, память и т.д.))
А также позаботиться о грамотном проектировании архитектуры базы данных, оптимизации запросов и активном кешировании.
Проектирование архитектуры базы данных
Если вы только начинаете новый проект, то стоит уделить достаточно времени продумыванию архитектуры базы.
Ошибки в проектировании начинаются с неправильной расстановки индексов, либо совершенным их отсутствием, (неэкономным) выбором типов данных под определенное поле и заканчиваются абсолютно нелогичной архитектурой.
Как мы можем улучшить архитектуру базы?
1. Разделение баз
Прежде всего, нужно разделить и, при возможности, разнести по разным серверам базы разного назначения. Например, выделить отдельные базы: внешнего проекта, внутреннего проекта, если есть, служебных очередей, например, под крон-задачи, под логи и т. д.
Зачем это нужно?
Представьте, что происходит, когда у вас все лежит в одном месте. Допустим, вы логгируете все основные действия пользователей (или ошибки, или постоянно записываете новые задачи в очередь для исполнения по крону).
Это постоянные, частые запросы, причем, на апдейты, которые грузят базу и сказываются на производительности всего проекта. Как правило, эти данные базы независимы друг от друга и их легко разнести по разным базам и серверам.
2. Тщательно продумайте структуру таблиц.
Если вы предполагаете, что ваша таблица будет содержать миллионы записей статей, то не нужно все свойства этих статей сгружать в эту таблицу.
Разбейте ее на несколько, хотя бы две, и в первой заведите только заголовок и краткое описание, т.е. то, что будет показываться в каталоге или на главной странице, причем, по возможности, сделайте поля фиксированной длины, а вот полноценные тексты вынесите во вторую таблицу.
Таким образом, вы будете обращаться к тяжелой таблице только в момент непосредственного обращения к тексту статьи, что, как правило, случается гораздо реже, чем вывод их названий.
Тоже самое относится к пользователям. Не нужно хранить все данные профиля в одной таблице, если они показываются только один раз: когда кто-то зашел на профиль пользователя. Вынесите главное и часто используемое отдельно.
Этот принцип называется Вертикальное разделение.
Но надо быть уверенными в том, что не потребуется постоянного связывания двух таблиц, которые вы только что разделили, так как это может привести к ухудшению производительности.
3. Правильно выбирайте тип данных.
Не нужно ставить поле типа INT, если заведомо известно, что вам требуется тип TINYINT.
Вопрос: сколько памяти выделит mysql под тип INT(1) и под INT(20)?
Надеюсь увидеть ответ в комментариях)
Внимательно изучите нюансы работы выбранной СУБД с разными типами данных.
Например, в столбцах DATETIME и TIMESTAMP можно хранить один и тот же тип данных: дату и время с точностью до секунды. Однако тип TIMESTAMP требует вдвое меньше места, позволяет работать с часовыми поясами и обладает специальными средствами автоматического обновления. При этом диапазон допустимых значений для него намного уже, а специальные средства могут стать недостатком.
Или, еще пример. Часто разработчики хранят в базе IP-адрес используя тип данных VARCHAR(15). Это очень неэкономно и достаточно медленно работает при поиске.
Оптимально хранить ip-адреса не как строки (VARCHAR), а как числа.
Для этого существует две функции mysql — INET_ATON и INET_NTOA.
Первая преобразует 4-байтную последовательность ip-адреса в число, вторая преобразует обратно. Таким образом:
- Столбец, в котором будут хранится ip-адреса объявляется как `ip` INT UNSIGNED NOT NULL
- При вставке:
INSERT INTO `ips` SET ip = INET_ATON(‘213.169.23.35’) - При выборке:
SELECT INET_NTOA(ip) FROM `ips` WHERE `ips`.ip > INET_ATON(‘255.255.0.0’)
4. Числовые поля
Иногда встречается практика заводить текстовые поля под статусы или типы, например, “on”, “deleted” и тому подобное.
Замените их на числовые, это заметно ускорит их обработку.
Про индексы, думаю, и так все хорошо знают, поэтому не будем на них задерживаться.
Оптимизация запросов
Столкнувшись с высоконагруженным проектом, приходится забыть свои блестящие навыки нормализации базы данных и заняться денормализацией.
1. Никаких сверхсложных запросов со множеством джойнов, группировками и вложенными выборками!
Это на собеседованиях любят задавать вопросы, что такое полиморфизм и предлагают сделать сложную выборку, но в большом проекте все по-другому — сложные запросы просто его положат.
Для высоконагруженных проектов очень часто (но не всегда) работает правило:
лучше два простых запроса, чем один сложный
Проект в этом случае будет работать быстрее.
Когда-то давно я искренне гордилась своим запросом (скопировала прямо из кода):
Вы сейчас в таком же ужасе, как и я, когда смотрите на него?Да, по тем реалиям, когда сайт посещали 5000 человек в день, запрос выполнял свою функцию.
В приложении с большой посещаемостью даже запрос вида
может сильно усложнить жизнь.
Вложенный запрос будет вызываться для каждой строки внешнего, а не вычисляться один раз перед выполнением внешнего.
В некоторых запросах поможет замена на join, но не всегда, нужно замерять время работы запроса. Когда речь идет о миллионах записей, то гораздо эффективнее будет разбиение запроса. Конечно, хочется все сделать быстренько и за один заход, мы так привыкли. Но.
Сначала выполните select cetegory_id from B, а потом в цикле пройдитесь по результату и выберите нужные значения из А.
2. В запросах вместо * выбирайте только те столбцы, которые вам реально нужны.
Этим вы снизите нагрузку.
3. Постарайтесь избавиться от агрегирующих функций вроде group by.
Как же можно избавиться от группировок, если, скажем, вам нужно постоянно выводить количество комментариев для каждого пользователя?
Очень просто: в таблице пользователей заведите поля вроде comments_count. Да, вам придется дергать таблицу пользователей при каждом добавлении комментария, но вы избавитесь от тяжелых группировок.
Впрочем, дергать таблицу пользователей каждый раз тоже необязательно, и тут нам на помощь приходит, например, мемкеш, но это уже следующая история.
4. Также желательно не использовать count(*).
В mysql лучше использовать SQL_CALC_FOUND_ROWS. При использовании этой опции можно получить количество всех найденных по запросу записей — это незаменимо при постраничном выводе поисковых результатов, когда используются «тяжелые» запросы.
5. Давайте поговорим про перебор большого количества данных.
Очень часто приходится перебирать большое количество данных. Например, перебрать все фотки или альбомы. Или всех пользователей.
Есть три способа перебора данных, чтобы база сразу не умерла от перегрузки:
делая перебор по ID;
LIMIT
Старый, добрый limit. Типичное использование limit
Но лучше отказаться он данного типа выборки.
Почему, спросите вы. Потому что она очень медленная. Чем больше объектов надо перебрать, тем медленнее работает данный перебор.
Between IDs
Этот способ мы использовали, когда уперлись в то, что обновление всех фоток идет неделями.
Тысячи пользователей онлайн: как работать, когда у тебя высоконагруженный проект
Вот вы зашли в интернет-магазин: посмотрели рекомендации, выбрали, что нужно, положили в корзину, оплатили. Для вас это как один связный фильм. А для магазина это серия запросов: «показать рекомендации», «добавить товар в корзину», «обработать оплату».
Если вы единственный пользователь магазина, то проблем не будет. Но если вдруг тысяча пользователей решит одновременно что-то купить, то сервер получит в тысячу раз больше запросов — и если на сервере что-то сделано криво, всё это хозяйство мёртво ляжет.
Такова судьба высоконагруженных проектов.
�� Эта статья написана по мотивам разговора с Александром Трегером, руководителем службы разработки Практикума. Раньше Александр работал в сервисе знакомств Badoo. Можете представить, насколько там всё нагружено.
Высокая нагрузка — это сколько?
Высоконагруженные проекты (хайлоад) — это сайты, сервисы и приложения, которые обрабатывают большое количество запросов. Это интернет-магазины, мессенджеры, социальные сети, интернет-банки: сотни и тысячи пользователей одновременно покупают, общаются, загружают фотографии, переводят деньги. Сервера без остановки обрабатывают их действия.
«Большое количество запросов» — понятие относительное. Чёткой границы, после которой проект можно считать высоконагруженным, нет: это зависит от инфраструктуры. Если у вас небольшой сервер, то даже стабильные 10 запросов в секунду могут стать проблемой. Но если усреднить, то граница высокой нагрузки пролегает около сотни запросов в секунду.
Сотня запросов в секунду — это, скорее всего, тысячи и десятки тысяч пользователей онлайн: если каждый пользователь делает запрос раз в несколько секунд, как раз набегает несколько сотен запросов в секунду.
В чём проблема
Если запросов слишком много, сервер не успевает их обрабатывать и начинает сбоить. Чем это чревато:
- Страницы сайта начинают загружаться медленнее или вовсе не загружаются.
- Появляются случайные ошибки, пользователи не могут выполнять привычные операции.
- Соединение между сервером и пользователем в принципе теряется.
Пользователей это напрягает, а бизнес теряет деньги. В условиях жёсткой конкуренции это вообще может означать потерю людей: например, в 2007 году, когда только начинались соцсети, в студенческой среде было два сайта — «Вконтакте» и «Факультет». О втором вы ничего не слышали, потому что он дико тормозил в пиковое время, и все постепенно переползли во «Вконтакте».
А ещё в хайлоад-проектах меньше простор для эксперимента. В любой момент тысячи людей по всему миру могут использовать сервис, так что он должен быть стабильным. Приходится использовать проверенные технологии и уделять больше внимания тестированию.
Что нужно учитывать при разработке хайлоад-проекта
Много запросов — много данных. Пользователи загружают фотографии, заполняют анкеты, переписываются — это всё нужно хранить и обрабатывать. Значит, нужно много серверов, а если проект международный, то ещё и в разных странах, чтобы у пользователей из Америки всё работало так же быстро, как и у пользователей из Европы.
Объём данных может резко вырасти. Никогда не знаешь, что произойдёт завтра. Может, выстрелит реклама, придёт миллион новых пользователей и нагрузка станет в несколько раз выше. Сегодня у тебя создаётся гигабайт личных сообщений в день, а завтра — 10 гигабайт в день.
Поэтому недостаточно просто иметь много серверов, чтобы просто решать текущие задачи. Нужно спроектировать систему так, чтобы иметь возможность быстро её масштабировать.
Лучше всё дублировать. «1» — плохое число для высоконагруженного проекта. Любой сервер или сервис может неожиданно выйти из строя, поэтому приходится всё дублировать. Запасной сервер, реплика базы данных — без этого никуда.
Использовать кэширование. Ответ на запрос пользователя можно кэшировать — временно сохранять, например, в оперативной памяти. Когда от пользователя повторно придёт запрос, можно не обращаться к серверу, а взять информацию из кэша. Это помогает снижать нагрузку: если в кэше есть информация, которая нужна пользователю, не придётся отправлять идентичный запрос и снова ждать ответ. Страница загрузится быстрее.
Как выкатывать высоконагруженные проекты
Обновить личный блог или сайт компании с парой десятков визитов в день несложно. Даже если во время обновления сайт не будет доступен несколько минут, ничего страшного не произойдёт. С нагруженными проектами всё по-другому — они не могут позволить себе такую задержку. Чтобы пользователь во время использования такого сервиса не наткнулся на ошибку или неправильные данные, существуют разные релизные флоу — способы выпускать новые версии.
�� Вот что Александр Трегер рассказывает про это:
«Для начала код нужно писать так, чтобы всегда была обратная совместимость. Это значит, что новая версия кода должна уметь работать с данными и в новом формате, и в старом, из предыдущей версии. Сложные миграции баз данных нужно делать по шагам и независимо от обновления кода. А такие действия, как, например, переименование полей, — практически табу.
Когда я работал в Badoo, мы использовали подход, в основе которого лежала штатная система автозагрузки файлов в PHP. Каждый файл в процессе подготовки к выкладке получает свою версию, и в каждом релизе есть карта с актуальными версиями. В продакшен-окружении на каждой машине есть symlink-файл — символическая ссылка — который указывает на нужную карту.
Когда все машины получили новый код, мы меняем одну ссылку на другую. Для всех новых запросов PHP начинает использовать новую карту и, соответственно, новые файлы.
Минус такого подхода в том, что файлы постоянно докладываются, занимая место на диске, и их нужно периодически чистить. А ещё старый код может ещё работать в памяти, порой по несколько дней. Инфраструктура может сильно поменяться, и логи засыпет ошибками.
В Практикуме мы используем внутреннее облако Яндекса для деплоя наших приложений. У нас всё в контейнерах, и каждое приложение запущено в несколько экземпляров. Процесс так настроен, что поднимается несколько новых экземпляров, балансировщик пускает на них трафик вместо части старых и гасит последние. Так постепенно всё обновляется. Это — rolling update.
Есть ещё вариант сначала полностью параллельно поднять нужное количество экземпляров и одномоментно на них переключиться. Такой метод деплоя называется blue-green. Чтобы его использовать, нужно всегда иметь в запасе в два раза больше свободных ресурсов, что не всегда возможно».
Блог Степана Родионова
В предыдущей статье мы рассмотрели frontend и backend, разобрали возможные способы их оптимизации и масштабирования. В этой статье мы будем говорить о базах данных, очень важном звене в нагруженных системах. Попробуем разобраться, какие существуют подходы к масштабированию базы данных. Сразу скажу, что это, пожалуй, самая сложная тема.
База данных.
Модель предметной области и типы БД.

Тюнинг базы данных.
В-четвертых, излюбленная тема JOIN-ов. В запросах не должно быть JOIN-ов. Если нужно перемножить результаты двух таблиц — делайте это в памяти backend-а. Два (или больше) легких запроса к базе данных, а потом в памяти обрабатываете результаты.
Вообще есть очень действенный подход при проектировании слоя хранения данных, который может на начальном этапе обеспечить возможность масштабирования базы данных, либо позволит в дальнейшем поиметь меньше проблем. Он заключается в следующем: изначально представляйте себе такую схему, когда все ваши таблицы уже находятся в разных базах данных на разных серверах и пишите код соответствующим образом. По началу будет непросто, но постепенно все встанет на свои места. Да, это порушит ваши представления о консистентности данных, но highload-проекты требует другого подхода к разработке.
Денормализация.
Для повышения эффективности выборки данных можно попробовать размещать их не самым оптимальным способом — денормализованно, т.е. дублировать, хранить в разных форматах и т.д. Преподаватели в университетах будут негодовать 🙂
Денормализация — это намеренное приведение структуры базы данных в состояние, не соответствующее правилам нормализации, для того, чтобы повысить эффективность чтения данных. В частном случае денормализация позволяет избавиться от JOIN-запросов.
Пара примеров чтобы стало понятнее. Возьмем какую-нибудь запись из социальной сети, у этой записи есть 30 лайков. Нам нужно при наведении на эту запись показать имена и фотографии тех, кто ее лайкнул. В базе данных можно хранить таблицу соответствий [id записи — id лайкнувшего пользователя], а потом просто сделать JOIN имени и фотографии. А можно сразу имя и фотографию включать в эту таблицу соответствий, тогда запрос на выборку будет очень быстрым и легким, мы сразу получим все нужные данные. Понятно, что в таком случае обновление данных будет сложнее, но у любой медали две стороны.
Второй пример. Лента в Instagram. Как вы думаете она строится? «Выбери все последние фотографии тех, на кого я подписан, и отсортируй по времени»? Это не будет работать на таких нагрузках и объемах. Там для каждого пользователя есть своя лента, хранящаяся в Redis. Таким образом, один пост там может храниться в сотнях тысяч экземпляров. Да, дублирование, но это позволяет предоставлять пользователям качественный и быстрый сервис.
Пример с Instagram тесно связан с таким понятием как «масштабирование во времени», о котором мы будем говорить в следующей статье.
Шардинг.
На самом деле это основная техника масштабирования базы данных, она же самая сложная. Принцип простой. Вот есть у вас 15 миллионов пользователей. Всю информацию, которая относится к первым пяти миллионам вы храните на первом сервере, ко вторым пяти — на втором, остальные — на третьем. Таким образом, шардинг — это разбиение ваших данных на отдельных серверах.

Когда данные только добавляются и никогда не удаляются может работать принцип ящиков. Шард — это ящик. Ящик заполнился — добавили новый ящик. Но это такая простая ситуация, которая, как правило, проблем не вызывает. Гораздо интереснее, когда данные на разных шардах могут расти или не расти по разным причинам — так обычно и бывает в реальных проектах. Есть классический пример с Lady Gaga и Facebook: если вы будете хранить все данные, относящиеся к Lady Gaga на сервере №21, то рано или поздно этот сервер переполнится. Тут уже нужно думать, что делать со всеми этими данными. Главная особенность этого сюжета — непредсказуемость, поэтому нужна гибкая техника, которая называется «виртуальные шарды».
[Рекомендую посмотреть выступление Алексея Рыбака (Badoo) и Константина Осипова (Mail.ru) на конференции Highload++ на тему шардинга: http://www.youtube.com/watch?v=MhGO7BBqSBU]
Виртуальные шарды.
Как определить на какой шард нужно делать запрос? Обычно определяется некоторая функция, которая по ключу отдает шард (номер или IP-адрес сервера).
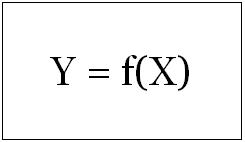
Технику виртуальных шардов можно представить себе как промежуточное отображение, т.е. сначала вы ключ отображаете на некий промежуточный виртуальный шард, а потом этот виртуальный шард на соответствующий ему физический.
В чем суть? Вы разбиваете все пространство данных на заведомо большое и определяете, например, тысячу виртуальных шардов. При этом у вас на самом деле всего 1 физический сервер. Вы запускаете на этом сервере 10 инстансов PostgreSQL, а в каждом инстансе еще по 100 баз данных. Постепенно система начнет наполняться. Только теперь вы сможете без проблем, используя репликацию, разнести данные на отдельные серверы или инстансы. Примерно вот так:
Таким образом, виртуальные шарды — это такая прослойка, которая позволяет backend-у общаться с конкретным шардом, при этом не не задумываясь о том, где этот шард физически находится. К примеру, нужно нам найти пользователя. Сначала он вычисляется «виртуально» — определяется виртуальный шард, затем берется какая-то таблица соответствий, по которой выясняется, где этот виртуальный шард находится физически.
Поначалу все может работать медленнее, чем если бы у нас был просто один сервер и один инстанс, но все это делается для того, чтобы в будущем, когда будет замечаться рост какого-то отдельного шарда, вы могли легко и просто (без изменения бизнес-логики приложения) мигрировать данные с одного сервера на другой.
У вас должен быть реализован какой-то центральный элемент этой системы, который будет знать, как выполняется шардинг. Кто-то должен знать, как «замапить» виртуальный шард на физический. Это уже некая договоренность между backend-ом и звеном хранения. Реализовать этот центральный элемент можно по-разному: это может быть просто конфигурационный файл, в котором вы прописываете соответствия виртуальному шарду физического, либо какой-то сервис, в котором реализуется логика этого же отображения. Все зависит от конкретной ситуации и конкретного проекта.
Репликация.
Что делать, когда один из серверов базы данных выйдет из строя? Срочно его поднимать 🙂 Но в это время обслуживание части пользователей будет невозможно. Чтобы этого не случилось используется репликация. Репликация — это механизм синхронизации данных между несколькими серверами базы данных.
Существует две основных задачи репликации: повышение отказоустойчивости и снижение нагрузки. В первом случае вы поднимаете несколько серверов базы данных и если один из них выходит из строя, то ничего страшного не случится, т.к. клиентов могут обслуживать оставшиеся сервера. Ко второму случаю относятся ситуации, когда запросов на чтение данных намного больше, чем запросов на запись. В этом случае выделяется один сервер (Master), в который пользователи пишут данные, а с остальных серверов (Slave/Replica) они их читают. После записи данных на Master-сервер они автоматически мигрируются (синхронно или асинхронно) на сервера для чтения.
[Про настройку репликации в PostgreSQL можно почитать тут]
Партиционирование.
Шардинг — это когда мы разбиваем данные на части и кладем их по выбранному критерию на разные серверы. Партиционирование — это тоже разбиение данных, но больше похожее на разбиение backend-ов по функциональности, т.е. данные для системы сообщений храним в одной базе, а данные для чего-то другого — в другой.
Партиционирование помогает, когда в вашем проекте часть данных читается очень активно, а часть — реже. Например, новостной сайт. Самые актуальные новости последней недели будут гораздо чаще читаться пользователями, поэтому здесь имеет смысл хранить эти данные отдельно от остальных, «поближе к пользователям». Вы просто выносите новости последней недели в отдельную таблицу или базу данных, в которую идут все запросы за свежими новостями. Помимо этого, есть «общая» база данных (архив), куда попадают вообще все новости. В эту базу данных идут все запросы за старыми новостями. Настройка партиционирования в PostgreSQL или MySQL выполняется достаточно просто, сейчас это практически полностью автоматизированный процесс.
К партиционированию можно отнести и ситуацию, когда мы начинаем разделять хранилище по типам данных. Например, начинаем хранить сообщения в какой-то NoSQL базе данных, а все остальное — в PostgreSQL. Каждая СУБД имеет какие-то свои фишки, позволяющие ей хранить определенные типы данных более эффективно, чем другие СУБД. Поняв это, можно существенно повысить эффективность всей системы.
Например, в вашем проекте есть возможность вести чат между пользователями. Все данные, включая сообщения чатов, хранятся в РСУБД, к примеру, PostgreSQL. Заметив, что формат общения и хранения данных у MongoDB, nodejs и клиентским javascript одинаковый (JSON), можно существенно снизить ненужные издержки, повысить эффективность чатов, обеспечить автоматическое масштабирование системы хранения сообщений и т.д. Nodejs позволяет писать быстрые и легкие сервера, MongoDB обеспечивает очень быструю запись (и чтение) данных, а также автоматическое масштабирование. Плюс ко всему, они общаются на одном «языке». Разумный и прагматичный подход — выбрать инструменты, которые лучше остальных подходят для решения конкретной задачи.
На этом все, мы кратко прошлись по всем основным нюансам масштабирования и оптимизации базы данных. В следующей статье мы познакомимся с другими способами масштабирования больших интернет-проектов, в частности масштабированием во времени.
Масштабирование БД в высоконагруженных системах
На прошлом внутреннем митапе Pyrus мы говорили о современных распределенных хранилищах, а Максим Нальский, CEO и основатель Pyrus, поделился первым впечатлением от FoundationDB. В этой статье рассказываем о технических нюансах, с которыми сталкиваешься при выборе технологии для масштабирования хранения структурированных данных.
Когда сервис недоступен пользователям какое-то время, это дико неприятно, но всё же не смертельно. А вот потерять данные клиента — абсолютно недопустимо. Поэтому любую технологию для хранения данных мы скрупулезно оцениваем по двум-трем десяткам параметров. Часть из них диктует текущая нагрузка на сервис.
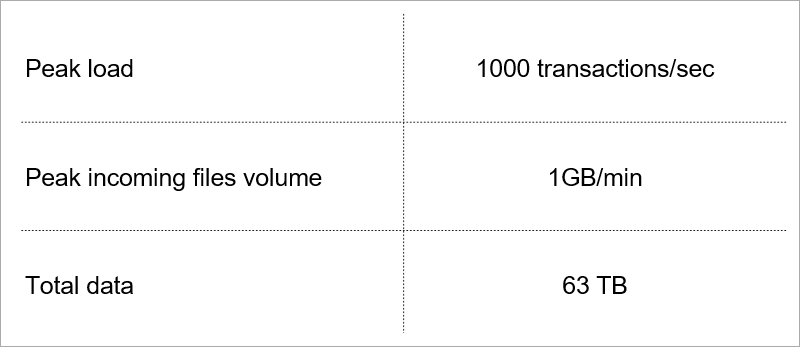 Текущая нагрузка. Технологию подбираем с учётом роста этих показателей.
Клиент-серверная архитектура
Классическая модель клиент-сервер — самый простой пример распределенной системы. Сервер — точка синхронизации, он позволяет нескольким клиентам делать что-то вместе скоординированно.
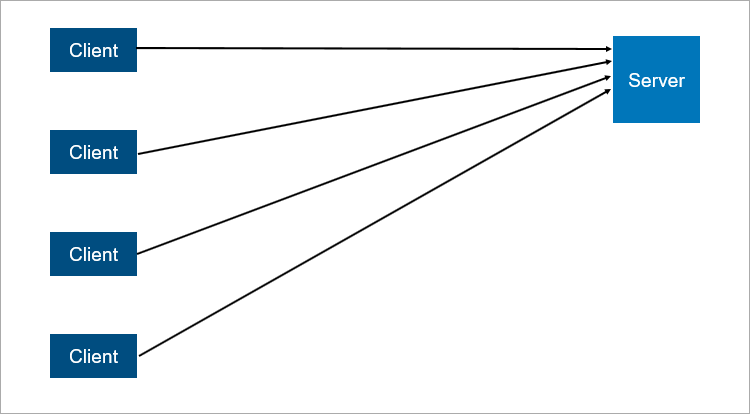 Очень упрощенная схема клиент-серверного взаимодействия.
Что ненадёжно в клиент-серверной архитектуре? Очевидно, сервер может упасть. А когда сервер падает, все клиенты не могут работать. Чтобы этого избежать, люди придумали master-slave подключение (которое теперь политкорректно называют leader-follower). Суть — есть два сервера, все клиенты общаются с главным, а на второй просто реплицируются все данные.
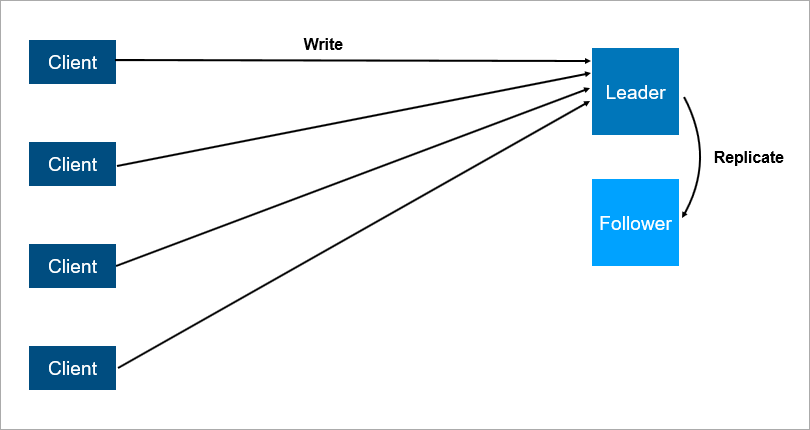 Клиент-серверная архитектура с репликацией данных на фолловера.
Ясно, что это более надёжная система: если основной сервер упадёт, то на фолловере находится копия всех данных и её можно будет быстро поднять.
При этом важно понимать, как устроена репликация. Если она синхронная, то транзакцию нужно сохранять одновременно и на лидере, и на фолловере, а это может быть медленно. Если репликация асинхронная, то можно потерять часть данных после аварийного переключения.
А что будет, если лидер упадет ночью, когда все спят? Данные на фолловере есть, но ему никто не сказал, что он теперь лидер, и клиенты к нему не подключаются. ОК, давайте наделим фолловер логикой, что он начинает считать себя главным, когда связь с лидером потеряна. Тогда легко можем получить split brain — конфликт, когда связь между лидером и фолловером нарушена, и оба думают, что они главные. Это действительно происходит во многих системах, например в RabbitMQ — самой популярной сегодня технологии очередей.
Чтобы решить эти проблемы, организовывают auto failover — добавляют третий сервер (witness, свидетель). Он гарантирует, что у нас только один лидер. А если лидер отваливается, то фолловер включается автоматически с минимальным даунтаймом, который можно снизить до нескольких секунд. Конечно, клиенты в этой схеме должны заранее знать адреса лидера и фолловера и реализовывать логику автоматического переподключения между ними.
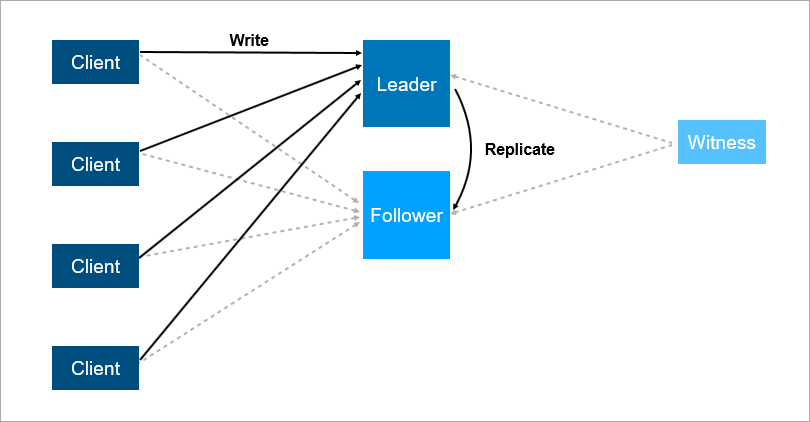 Свидетель гарантирует, что есть только один лидер. Если лидер отваливается, то фолловер включается автоматически.
Такая система сейчас работает у нас. Есть основная база данных, запасная база данных, есть свидетель и да — иногда мы приходим утром и видим, что ночью произошло переключение.
Но и у этой схемы есть недостатки. Представьте, что вы ставите сервис паки или обновляете ОС на лидер-сервере. До этого вы вручную переключили нагрузку на фолловера и тут… он падает! Катастрофа, ваш сервис недоступен. Что делать, чтобы защититься от этого? Добавляют третий резервный сервер — ещё один фолловер. Три — что-то вроде магического числа. Если вы хотите, чтобы система работала надежно, два сервера недостаточно, нужно три. Один на обслуживании, второй падает, остаётся третий.
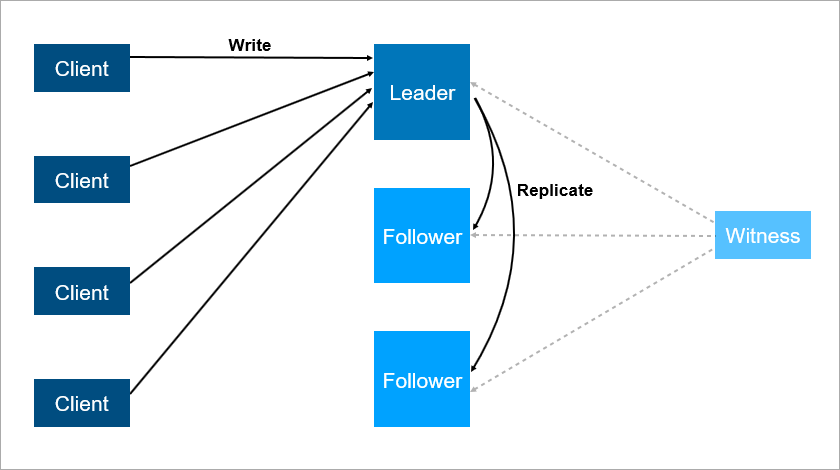 Третий сервер обеспечивает надежную работу, если первые два недоступны.
Если обобщить, то избыточность должна равняться двум. Избыточности, равной единице, недостаточно. По этой причине в дисковых массивах люди начали вместо RAID5 применять схему RAID6, переживающую падение сразу двух дисков.
Транзакции
Хорошо известны четыре основных требования к транзакциям: атомарность, согласованность, изолированность и долговечность (Atomicity, Consistency, Isolation, Durability — ACID).
Когда мы говорим о распределенных базах данных, то подразумеваем, что данные надо масштабировать. Чтение масштабируется очень хорошо — тысячи транзакций могут читать данные параллельно без проблем. Но когда одновременно с чтением другие транзакции пишут данные, возможны разные нежелательные эффекты. Очень легко получить ситуацию, при которой одна транзакция прочитает разные значения одних и тех же записей. Вот примеры.
Dirty reads. В первой транзакции мы два раза отправляем один и тот же запрос: взять всех пользователей, у которых Если вторая транзакция поменяет эту строчку, а потом сделает rollback, то база данных с одной стороны никаких изменений не увидит, а с другой стороны первая транзакция прочитает разные значения возраста для Joe.
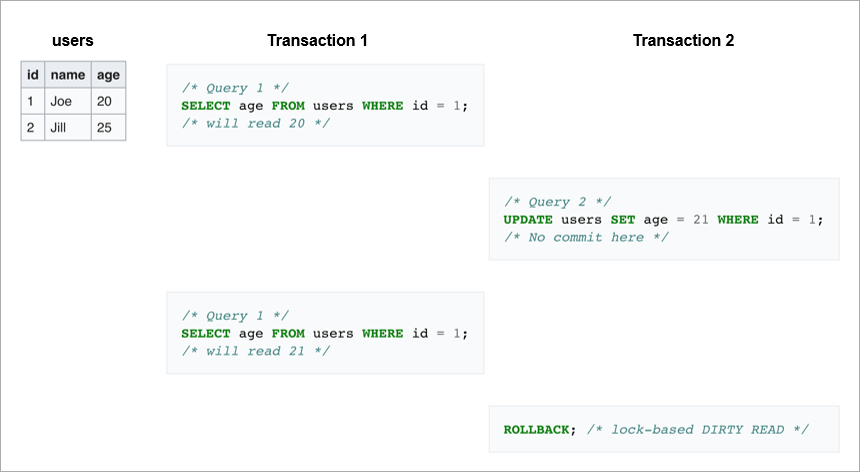
Non-repeatable reads. Другой случай — если транзакция записи завершилась успешно, а транзакция чтения при выполнении одного и того же запроса также получила разные данные.
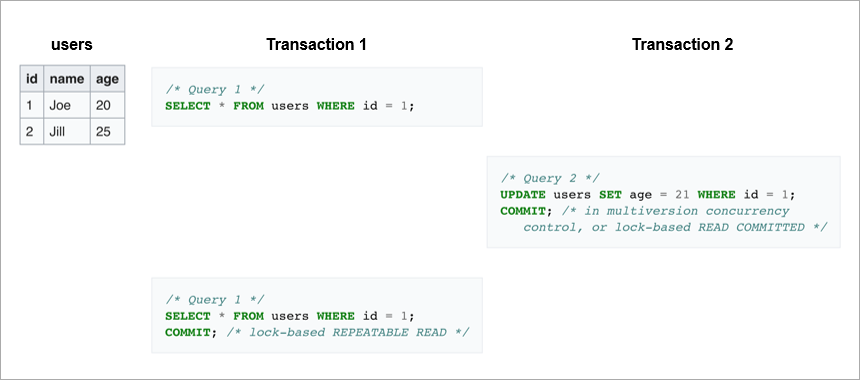
В первом случае клиент прочитал данные, которые вообще в базе отсутствовали. Во втором случае клиент оба раза прочитал данные из базы, но они отличаются, хотя чтение происходит в рамках одной транзакции.
Phantom reads — это когда мы в рамках одной транзакции повторно читаем какой-нибудь диапазон и получаем разный набор строк. Где-то посередине влезла другая транзакция и вставила или удалила записи.
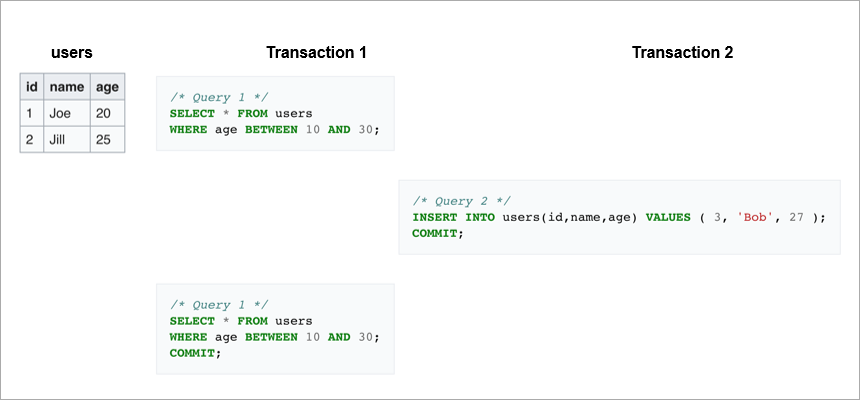
Чтобы избегать этих нежелательных эффектов, современные СУБД реализуют механизмы блокировок (транзакция ограничивает другим транзакциям доступ к данным, с которыми она сейчас работает) или мультиверсионный контроль версий, MVCC (транзакция никогда не изменяет ранее записанные данные и всегда создает новую версию).
Стандарт ANSI/ISO SQL определяет 4 уровня изоляции транзакций, которые влияют на степень их взаимной блокировки. Чем выше уровень изоляции, тем меньше нежелательных эффектов. Платой за это является замедление работы приложения (поскольку транзакции чаще находятся в ожидании снятия блокировки с нужных им данных) и повышение вероятности deadlocks.
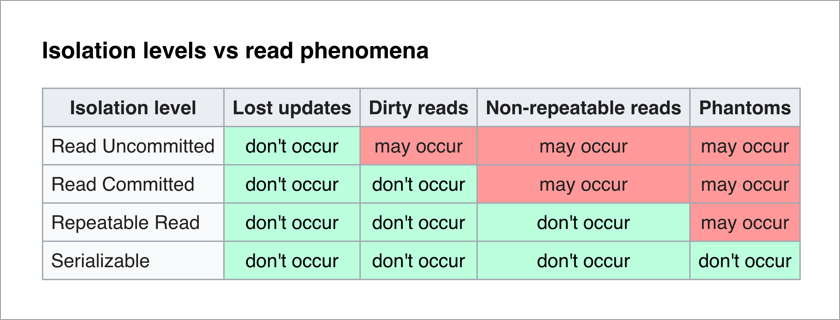
Самым приятным для прикладного программиста является уровень Serializable — нет никаких нежелательных эффектов и вся сложность обеспечения целостности данных переложена на СУБД.
Давайте подумаем о наивной реализации уровня Serializable — при каждой транзакции мы просто блокируем все остальные. Каждая транзакция записи может теоретически выполняться за 50мкс (время одной операции записи у современных SSD дисков). А мы хотим сохранять данные на три машины, помните? Если они находятся в одном дата-центре, то запись займет 1-3 мс. А если они, для надежности, находятся в разных городах, то запись легко может занять 10-12мс (время путешествия сетевого пакета из Москвы в Санкт-Петербург и обратно). То есть при наивной реализации уровня Serializable последовательной записью мы сможем выполнять не больше 100 транзакций в секунду. При том, что отдельный диск SSD позволяет выполнять порядка 20 000 операций записи в секунду!
Вывод: транзакции записи нужно выполнять параллельно, и для их масштабирования нужен хороший механизм разрешения конфликтов.
Шардирование
Что делать, когда данные перестают влезать на один сервер? Есть два стандартных механизма масштабирования:
- Вертикальное, когда мы просто добавляем в этот сервер память и диски. Это имеет свои пределы — по количеству ядер на процессор, количеству процессоров, объему памяти.
- Горизонтальное, когда мы используем много машин и распределяем данные между ними. Наборы таких машин называются кластерами. Чтобы поместить данные в кластер, их нужно шардировать — то есть для каждой записи определить, на каком конкретно сервере она будет размещена.
Представьте, что вам нужно записать в кластер данные обо всех жителях Земли. В качестве ключа шарда можно взять, например, год рождения человека. Тогда хватит 116 серверов (и каждый год нужно будет добавлять новый сервер). Или вы можете взять в качестве ключа страну, где проживает человек, тогда вам понадобится примерно 250 серверов. Предпочтительнее всё-таки первый вариант, потому что дата рождения человека не меняется, и вам никогда не нужно будет перекидывать данные о нём между серверами.
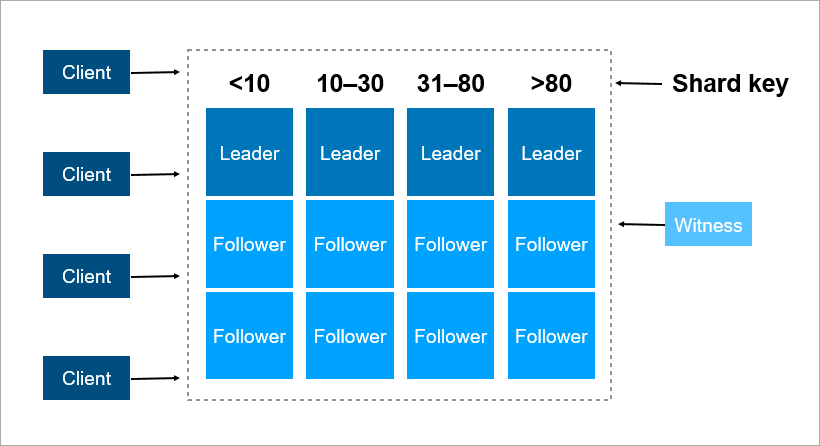
В Pyrus в качестве ключа шардирования можно взять организацию. Но они сильно отличаются по размеру: есть как огромный Совкомбанк (более 15 тысяч пользователей), так и тысячи небольших компаний. Когда ты присваиваешь организации определенный сервер, ты заранее не знаешь, как она вырастет. Если организация крупная и использует сервис активно, то рано или поздно ее данные перестанут помещаться на одном сервере, и придется делать решардинг. А это непросто, если данных терабайты. Представьте: нагруженная система, каждую секунду идут транзакции, и в этих условиях вам нужно перемещать данные с одного места на другое. Останавливать систему нельзя, такой объем может перекачиваться несколько часов, и бизнес-заказчики не переживут столь длительный простой.
В качестве ключа шардирования лучше выбирать данные, которые редко меняются. Однако далеко не всегда прикладная задача позволяет это легко сделать.
Консенсус в кластере
Когда машин в кластере много и часть из них теряют связь с остальными, то как решить, кто хранит самую последнюю версию данных? Просто назначить witness-сервер недостаточно, ведь он тоже может потерять связь со всем кластером. Кроме того, в ситуации split brain несколько машин могут записывать разные версии одних и тех же данных — и нужно как-то определить, какая из них самая актуальная. Для решения этой задачи люди придумали консенсус-алгоритмы. Они позволяют нескольким одинаковым машинам прийти к единому результату по любому вопросу путем голосования. В 1989 году был опубликован первый такой алгоритм, Paxos, а в 2014 году ребята из Стэнфорда придумали более простой в реализации Raft. Строго говоря, чтобы кластеру из (2N+1) серверов достичь консенсуса, достаточно, чтобы в нем было одновременно не более N отказов. Чтобы переживать 2 отказа, в кластере должно быть не менее 5 серверов.
Масштабирование реляционных СУБД
Большинство баз данных, с которыми разработчики привыкли работать, поддерживают реляционную алгебру. Данные хранятся в таблицах и временами нужно соединить данные из разных таблиц путем операции JOIN. Рассмотрим пример БД и простого запроса к ней.
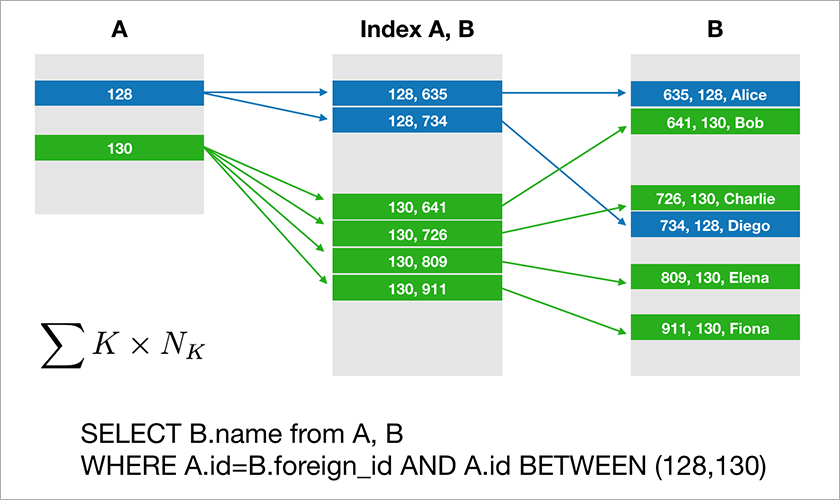
Предполагаем, что A.id — это первичный ключ с кластерным индексом. Тогда оптимизатор построит план, который скорее всего вначале выберет нужные записи из таблицы A и затем возьмет из подходящего индекса (A,B) соответствующие ссылки на записи в таблице B. Время выполнения этого запроса растет логарифмически от количества записей в таблицах.
Теперь представьте, что данные распределены по четырем серверам кластера и вам нужно выполнить тот же самый запрос:
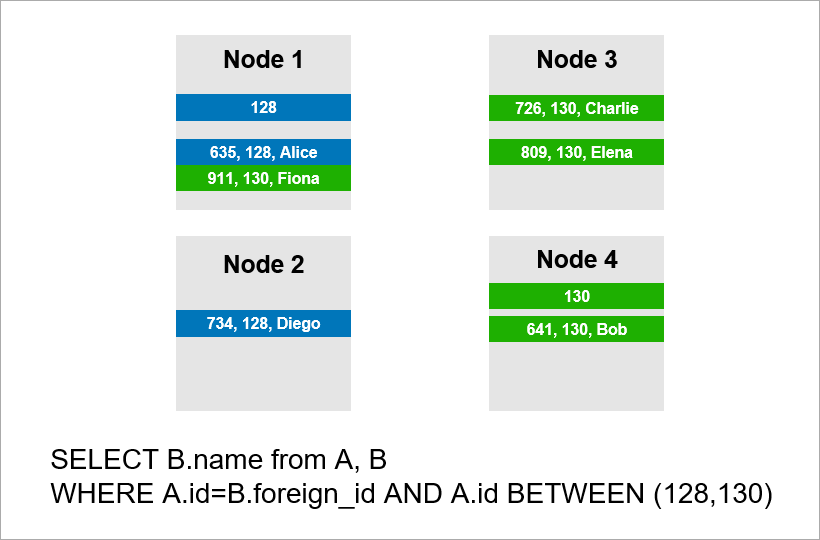
Если СУБД не хочет просматривать все записи всего кластера, то она вероятно попробует найти записи с A.id равным 128, 129, или 130 и найти для них подходящие записи из таблицы B. Но если A.id не является ключом шардирования, то СУБД заранее не может знать, на каком сервере лежат данные таблицы А. Придется все равно обратиться ко всем серверам, чтобы узнать, есть ли там подходящие под наше условие записи A.id. Потом каждый сервер может сделать JOIN внутри себя, но этого не достаточно. Видите, запись на ноде 2 нам нужна в выборке, но там нет записи c A.id=128? Если ноды 1 и 2 будут делать JOIN независимо, то результат запроса будет неполным — часть данных мы не получим.
Поэтому для выполнения этого запроса каждый сервер должен обратиться ко всем остальным. Время выполнения растет квадратично от количества серверов. (Вам повезет, если вы сможете шардировать все таблицы по одному и тому же ключу, тогда все сервера обходить не нужно. Однако, на практике это малореально — всегда будут запросы, где требуется выборка не по ключу шардирования.)
Таким образом, операции JOIN масштабируются принципиально плохо и это фундаментальная проблема реляционного подхода.
NoSQL подход
Сложности с масштабированием классических СУБД привели к тому, что люди придумали NoSQL-базы данных, в которых нет операции JOIN. Нет джойнов — нет проблем. Но нет и ACID-свойств, а об этом в маркетинговых материалах умолчали. Быстро нашлись умельцы, которые испытывают на прочность разные распределенные системы и выкладывают результаты публично. Оказалось, бывают сценарии, когда кластер Redis теряет 45% сохраненных данных, кластер RabbitMQ — 35% сообщений, MongoDB — 9% записей, Cassandra — до 5%. Причем речь идет о потере после того, как кластер сообщил клиенту об успешном сохранении. Обычно ты ожидаешь более высокий уровень надежности от выбранной технологии.
Компания Google разработала базу данных Spanner, которая работает глобально по всему миру. Spanner гарантирует ACID-свойства, Serializability и даже больше. У них в дата-центрах стоят атомные часы, которые обеспечивают точное время, и это позволяет выстраивать глобальный порядок транзакций без необходимости пересылать сетевые пакеты между континентами. Идея Spanner в том, что пусть лучше программисты разбираются с проблемами производительности, которые возникают при большом количестве транзакций, чем делают костыли вокруг отсутствия транзакций. Однако, Spanner — закрытая технология, он вам не подходит, если вы по каким-либо причинам не хотите зависеть от одного вендора.
Выходцы из Google разработали open source аналог Spanner и назвали его CockroachDB («cockroach» по-английски «таракан», что должно символизировать живучесть БД). На Хабре уже писали о неготовности продукта к production, потому что кластер терял данные. Мы решили проверить более новую версию 2.0, и пришли к аналогичному выводу. Данные мы не потеряли, но некоторые простейшие запросы выполнялись необоснованно долго.
В итоге на сегодняшний день есть реляционные БД, которые хорошо масштабируются только вертикально, а это дорого. И есть NoSQL-решения без транзакций и без гарантий ACID (хочешь ACID — пиши костыли).
Как же делать mission-critical приложения, у которых данные не умещаются на один сервер? На рынке появляются новые решения и про одно из них — FoundationDB — мы подробнее расскажем в следующей статье.