How to Mitigate CVE-2022-0847 (The Dirty Pipe Vulnerability)
Dirty Pipe vulnerability is a Linux kernel vulnerability that allows the ability of non-privileged users to overwrite read-only files. The vulnerability is due to an uninitialized “pipe_buffer.flags” variable, which overwrites any file contents in the page cache even if the file is not permitted to be written, immutable, or on a read-only mount, including CD-ROM mounts. The page cache is always writable by the kernel and writing to a pipe never checks any permissions. An extensive write-up on the Dirty Pipe vulnerability can be found in the reference links at the end of this blog.
Why is this important?
This enables attackers to perform privilege escalation by overwriting data in arbitrary read-only files and injecting code from unprivileged processes to privileged processes. This can make Linux and Android systems vulnerable to a multitude of malware and other exploits, including ransomware.
Who is affected?
This vulnerability affects endpoints running Linux with a kernel version 5.8 or higher. This includes a multitude of devices running Android 12 and Linux.
How to find out if I am affected?
Linux:
From the Linux command line, run the following command:
Your output should show something similar:
Linux 5.13.19-3-generic x86_64
Android:
To find the kernel version on Android:
With most generic Android devices, go to setting and search or select “About Phone” -> “Android Version” and you should see the “Kernel version.”
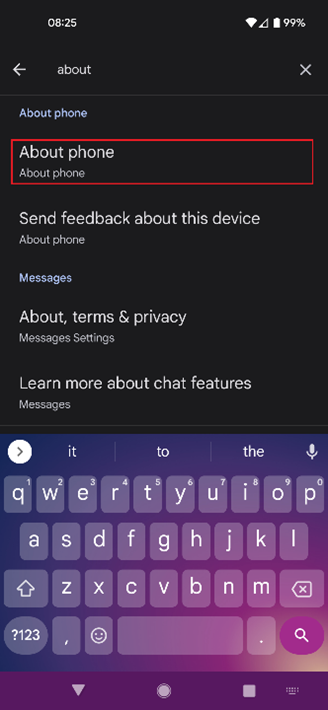
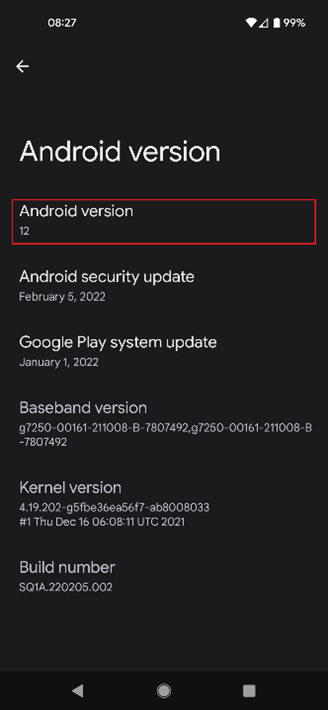
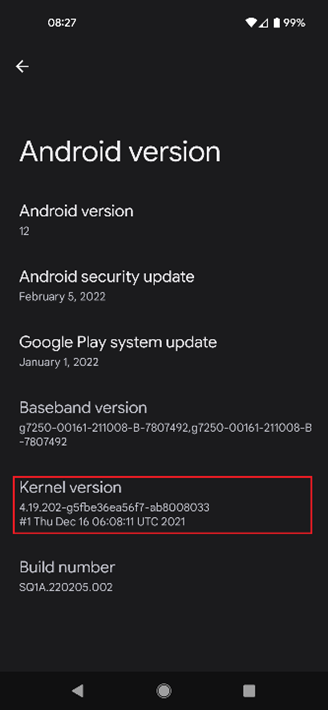
With Samsung, go to settings and search or select “About Phone” -> “Software Information” and your “Kernel version” should be displayed.
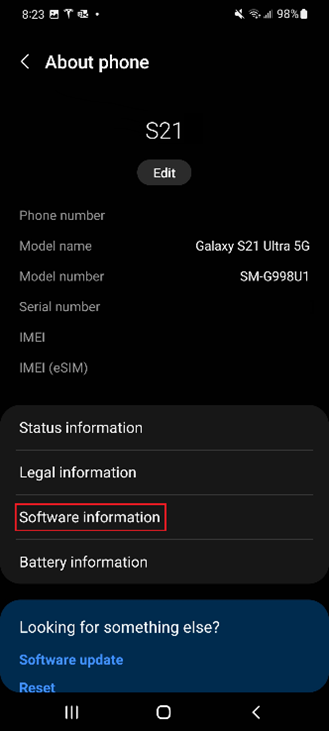
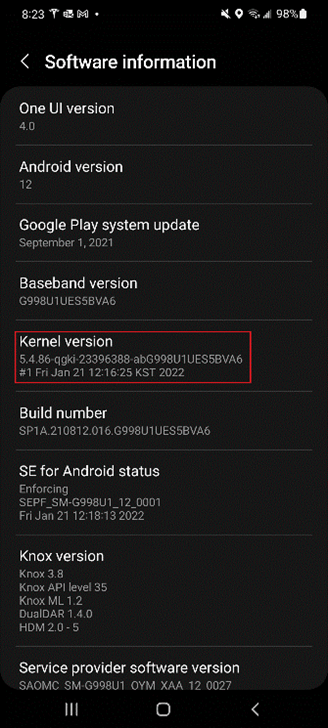
Currently, the most common Android devices affected by this vulnerability are Samsung S22 and Google Pixel 6 series.
How to mitigate Dirty Pipe
Linux
If your endpoint is running a Linux kernel version 5.8 or higher, you should patch your kernel to 5.16.11, 5.15.25 and 5.10.102 or greater. Most distributions have already released a kernel patch. You can run an update with your distro’s package manager to update to the latest kernel.
Ivanti Patch for Endpoint Manager can find which Linux endpoints are affected and automatically apply the vulnerability fix.
Android
On Android, manufacturers are working on applying a critical system update. It is highly recommended to contact your device manufacturer to confirm they are addressing this vulnerability.
You can create reports in Neurons for Discovery to find which Android endpoints are affected.
With Ivanti Neurons for MDM, applying a “System Update” configuration and setting the “Android System Update” to “Automatic” will push the latest manufacture approved system updates to your devices.
How to fix CVE-2022-0847
CVE-2022-0847 — dubbed Dirty Pipe for its similarity to the Dirty Cow vulnerability — has emerged in Linux distributions. Here’s everything you need to know about this growing threat.

On Monday, a cybersecurity researcher released the details of a Linux vulnerability – CVE-2022-0847 – that allows an attacker to overwrite data in arbitrary read-only files.
Dubbed Dirty Pipe by the researcher due to its similarity to the Dirty Cow flaw, – this vulnerability has already been patched in the Linux and Android kernels. Meanwhile security updates with the patch are being pushed out in affected Linux distributions.
Here’s what you need to know:
What is the CVE-2022-0847 vulnerability?
CVE-2022-0847 represents a flaw in how Linux treats pipe buffer flags. The vulnerability lets threat actors to overwrite data in read-only files and SUID binaries to achieve root access.
For a local kernel vulnerability, this is about as critical as it gets. There’s pretty much no way to mitigate it – just like Dirty Cow – and it targets core Linux functionality.
While the bug is easy to exploit, it can’t be done remotely – attackers need to have prior access to a vulnerable host to deploy an exploit. But if the Dirty Cow flaw was exploited by attackers in the wild, you can be sure that it won’t be long before they take advantage of Dirty Pipe, too.
The original write-up from the researcher who discovered the vulnerability contains plenty of information for other security professionals, including a PoC exploit. Other researchers have been able to produce variations of this.
Does it affect me?
The vulnerability affects Linux Kernel 5.8 and later versions but was fixed in Linux 5.16.11, 5.15.25 and 5.10.102.
Has CVE-2022-0847 been actively exploited in the wild?
Any exploit that gives root level access to a Linux system is problematic.
An attacker with root access has full control over the target system. There’s a good chance that they could leverage that control to reach other system. The risk is slightly lower given the fact that local access is required, but it’s still a vulnerability that should be taken seriously.
Fixing CVE-2022-0847
Users of various Linux distributions and Android devices should be on the lookout for security updates implementing the patch.
CVE-2022-0847 affects Linux Kernel 5.8 and later versions ( possibly even earlier ones ), and has been fixed in Linux 5.16.11, 5.15.25 and 5.10.102 and the latest Android kernel.
One thing’s for certain: vulnerabilities aren’t going anywhere. Get ahead of the game with Vulcan Remedy Cloud – the free, comprehensive resource for everything you need to know about how to fix the latest CVEs.
The Vulcan Cyber platform is a valuable partner in mitigating the continuing threat of vulnerabilities. See it in action .
People also read
 Voyager18 (research) OWASP Top 10 vulnerabilities 2022: what we learned Jan 04, 2023
CVE 2022-0847: Исследование уязвимости Dirty Pipe

Данная статья является переводом англоязычного исследования, посвященного
разбору уязвимости Dirty Pipe и непосредственно эксплоита, позволяющего ею
воспользоваться для локального повышения привилегий.
Уязвимость Dirty Pipe была обнаружена в ядре Linux исследователем Максом
Келлерманном(Max Kellermann) и описана им здесь. Несмотря на то, что статья
Келлерманна — отличный ресурс, содержащий всю необходимую информацию для
понимания ошибки ядра, все таки она предполагает некоторое знакомство с ядром
Linux.
Коротко о Pipe, Page и файловых дескрипторах в Linux
Далее в статье еще будут более подробно разобраны такие понятия, как pipe, page и
file descriptor. Но для начала давайте вспомним общую концепцию работы этих
элементов.
Pipe (канал, конвейер) — это однонаправленный метод взаимодействия процессов
между собой.
Канал позволяет процессу получать входные данные от предыдущего, используя pipe buffer(буфер канала или буфер конвейера).
Самый простой пример, который наглядно показывает работу Pipe-ов приведен на
скриншоте ниже:

В данном примере выходные данные команды cat используются в качестве входных
данных для команды grep, применяя Pipe.
Page(страница) представляет собой блок данных, чаще всего размером 4096 байт.
Ядро Linux разбивает данные на страницы и работает непосредственно с ними, а не с
целыми файлами сразу.
В механизме канала(pipe) есть флаг “PIPE_BUF_FLAG_CAN_MERGE”, который
указывает, разрешено ли слияние большего количества данных в буфер канала. Если
размер скопированной страницы меньше 4096 байт, то в буфер канала можно добавить
больше данных.
File descriptor (файловый дескриптор) — это число, которое однозначно
идентифицирует открытый файл в ОС.
Когда программа запрашивает открытие файла, ядро в свою очередь:
Создает запись в глобальной таблице файлов.
Предоставляет программе расположение этой записи.
Когда процесс делает успешный запрос на открытие файла, ядро возвращает
файловый дескриптор, который указывает на запись в глобальной файловой таблице
ядра.
Запись таблицы файлов содержит информацию, такую как:
Смещение в байтах
Ограничение доступа для данного потока данных (read-only, write-only и т.д.).
После обсуждения основных понятий, давайте перейдем к уязвимости.
Разбор уязвимости и PoC
На данный момент мы уже можем предположить, что из себя представляет уязвимость
Dirty Pipe: она позволяет перезаписать кешированные данные любого файла, который
нам разрешено открывать(достаточно будет прав на чтение), фактически не помечая
страницы с перезаписанной страницей кеша как “грязные”(всякий раз, когда процесс
изменяет какие либо данные, на соответствующую страницу устанавливается флаг
“PG_dirty”, тем самым она помечается как “грязная”).
Таким образом мы можем воспользоваться данной уязвимостью, чтобы повысить привилегии в локальной системе путем перезаписи файла. В нашем случае, добавив пользователя с неограниченными правами в /etc/passwd.


Но перейдем непосредственно к эксплоиту.
Первым делом наш PoC открывает файл для чтения, без каких-либо дополнительных
флагов.
Функция ядра, обрабатывающая наш open() вызов пользовательского пространства,
называется do_sys_openat2(). Она пытается получить файл в желаемом ей режиме, и, если это получается, устанавливает новый файловый дескриптор, который поддерживается файлом, и возвращает его в виде целого числа.
Выполнение вызова do_filp_open() связано с риском потеряться в “джунглях”
(виртуальной) файловой системы, поэтому мы поместим нашу первую точку останова
на return оператор. Это дает нам возможность найти struct file, возвращающий
дескриптор файла, который получает наш процесс PoC.
Действительные кешированные данные находятся на одной или нескольких страницах
в физической памяти. Каждая страница физической памяти описывается файлом
struct page. Расширяемый массив(struct xarray), содержащий указатели на эти
структуры страниц, можно найти в i_pages поле файла struct address_space.
В последнем комментарии дается подсказка, как найти реальную страницу
физической памяти в виртуальном адресном пространстве ядра. Дело в том, что ядро
отображает всю физическую память в свое виртуальное адресное пространство ,
поэтому мы знаем, где она находится. Дополнительные сведения см. в документации.
Ключом к поиску “иголки в стоге сена“ является другая область виртуального
адресного пространства ядра.
Vmemmap использует виртуально отображаемую карту памяти для
оптимизации операций pfn_to_page и page_to_pfn. Имеется глобальный
страничный указатель структуры *vmemmap, указывающий на практически
непрерывный массив объектов структуры страницы. PFN — это индекс этого
массива, а смещение страничной структуры из vmemmap — это PFN этой
страницы.Источник
В отладчике мы можем убедиться, что адрес struct page, связанный со struct
address_space целевого файла, открытого нашим процессом PoC, и правда находится
в этом диапазоне.
Ядро реализует преобразование этого адреса в состояние непрерывного отображения
всей физической памяти, используя серию макросов, которые скрываются за вызовом
lowmem_page_address/page_to_virt.
При выполнении макросов, обязательно учитывайте свою архитектуру(например, x86)
и проверяйте определения времени компиляции в файле .config вашей
сборки(например,CONFIG_DYNAMIC_MEMORY_LAYOUT=y ). На значения
vmemmap_base и page_ofset_base обычно влияет KASLR(kernel address space layout
randomization), но они могут быть определены во время исполнения, например, с
помощью отладчика.
Вооружившись этими знаниями, мы можем написать скрипт для отладчика, который
сделает этот расчет за нас и выведет кешированные данные из открытого нами файла.
Проверка прав доступа к файлу подтверждает, что у нас действительно нет прав на
запись в него.
Далее мы будем исследовать вторую подсистему ядра, связанную с уязвимостью Dirty
Pipe.
Pipes
Как было сказано в начале статьи, каналы(pipes) — это механизм однонаправленного
межпроцессного взаимодействия(IPC), используемый в UNIX-подобных операционных
системах. По сути, канал — это буфер в пространстве ядра, к которому процессы
обращаются через файловые дескрипторы. Однонаправленность означает, что
существует два типа файловых дескрипторов — для чтения и для записи:
При создании канала, вызывающий процесс получает оба файловых дескриптора, но
обычно он извлекает выгоду путем распространения одного или обоих файловых
дескрипторов другим процессам(например, с помощью fork/clone или через сокеты
домена UNIX)для облегчения процесса IPC. Как пример, они используются
оболочками для подключения stdout и stdin запущенных процессов.
В контексте статьи мы будем рассматривать анонимные каналы, но также существуют
именованные каналы, о которых тоже было бы полезно знать.
Еще есть отличная книга “The Linux Programming Interface”, написанная Майклом
Керриском (Michael Kerrisk). В главе 44 “Pipes and FIFO” развернуто представлена
тема каналов.
Pipes (инициализация)
После открытия целевого файла, исполнение нашего PoC продолжается созданием
канала:
Давайте посмотрим, что делает ядро, чтобы обеспечить функциональность канала.
Наш системный вызов обрабатывается функцией ядра do_pipe2.
Как мы можем видеть, здесь создаются два целочисленных файловых дескриптора,
поддерживаемые двумя разными файлами. Один для чтения(fd[0]) и один для
записи(fd[1]). Дескрипторы также копируются из ядра в пространство пользователя
copy_to_user(fildes, fd, sizeof(fd)), где fildes — это указатель пространства
пользователя, который мы установили при вызове pipe(pipefds) в нашем PoC.
После вызова __do_pipe_flags() видно, какие структуры данных использует ядро для
реализации канала. Мы объединили соответствующие структуры и их взаимодействия
на следующей схеме:
Два целочисленных файловых дескриптора, представляющие канал в
пользовательском пространстве, поддерживаются двумя структурными файлами,
которые отличаются только своими битами разрешений. Также, они оба ссылаются на
один и тот же struct inode.
Inode(индексный узел) — это структура данных в файловой системе, которая
описывает объект файловой системы, такой как файл или каталог. Каждый индексный узел хранит атрибуты и расположение дисковых блоков данных
объекта. Атрибуты объекта файловой системы могут включать в себя
метаданные(время последнего изменения, доступа, модификации), а также
данные о владельце и правах доступа.
Каталог — это список индексных узлов с присвоенными им именами. Список
включает запись для себя, своего родителя и каждого из своих дочерних
элементов.Источник
Поле i_fop индексного узла содержит указатель на struct file_operations. Эта
структура содержит указатели функций для реализации различных операций, которые
могут выполняться в канале. Важно отметить, что они включают в себя функции,
которые ядро будет использовать для обработки запроса процесса на чтение или
запись канала.
Как указано выше, индексный узел не ограничивается описанием каналов, и для
других типов файлов это поле будет указывать на другой набор указателей функций.
Специфическая для канала часть индексного узла(inode) в основном содержится в
функции struct pipe_inode_info, на которую указывает поле i_pipe.
На этом этапе мы уже можем сформировать первое представление о том, как
реализованы каналы. На высоком уровне ядро представляет для себя канал как
кольцевой массив pipe_buffer структур, иногда также называемый “кольцом”(ring).
Поле bufs является указателем на начало этого массива.
В этом массиве есть две позиции: одна для записи в «заголовок»(head), и одна для
чтения из «хвоста»(tail) канала. ring_size по умолчанию равен 16 и всегда будет
степенью 2, поэтому цикличность реализуется путем кеширования доступа к индексу с
помощью ring_size — 1 (например, bufs[head & (ring_size — 1)]). Поле страницы
является указателем на struct page, которая описывает, где хранятся фактические
данные, содержащиеся в pipe_buffer. Ниже мы подробнее остановимся на процессе
добавления и использования данных. Обратите внимание, с каждым pipe_buffer
связана одна страница. Это означает, что общая емкость канала равна ring_size *
4096 байт(4 кб).
Процесc может получить и установить размер «кольца»(ring) с помощью системного
вызова fcntl() с флагами F_GETPIPE_SZ и F_SETPIPE_SZ соответственно. Для
простоты, наш PoC устанавливает размер канала равным одному буферу.
Анализ исходного кода ядра
Мы также можем следить за настройкой канала в исходном коде ядра. Инициализация
целочисленных файловых дескрипторов происходит в __do_pipe_flags().
Файлы поддержки инициализируются в функции create_pipe_files(). Как мы можем
заметить, оба файла идентичны с точки зрения разрешений, а также содержат ссылку
на канал в своих конфиденциальных данных, и представляются как потоки.
Инициализация общей структуры inode(индексного узла) происходит в функции
get_pipe_inode(). Мы видим, что создается inode, а также информация для канала
выделяется и сохраняется таким образом, что inode—>pipe впоследствии можно
использовать для доступа к каналу из данного нам inode. Кроме того, inode—>i_fops
указывает выполнения, используемые для файловых операций в канале.
Большинство специфичных для канала настроек происходит в alloc_pipe_info(). Здесь
мы можем увидеть непосредственно создание канала(не только inode, но и
pipe_buffers/pipe_inode_info->bufs, которые содержат данные канала).
Отладчик
Мы можем вывести информацию о только что инициализированнном канале(после изменения его размера) путем создания прерывания в конце функции pipe_fcntl(), которая является обработчиком, вызываемом в случае F_SETPIPE_SZ(оператора switch внутри do_fcntl()).
Пока что эта информация нам не понадобится, но в будущем мы сможем ей воспользоваться.
Pipes (reading/writing)
Writing
После выделения канала, PoC продолжает запись в него.
Глядя на файловые операции индексного узла(inode), мы видим, что запись в канал
обрабатывается функцией pipe_write(). Когда данные перемещаются между ядром и
пользовательским пространством, часто приходится сталкиваться с
векторизированным вводом-выводом с использованием объектов iov_eter. В контексте
наших целей. мы можем воспринимать их, как буферы, но при желании вы можете
узнать о них больше.
При обработке записи(write()) в канал, поведение ядра можно разделить на два
сценария. Сначала, оно проверяет, есть ли возможность добавить данные(или хотя бы
какую-то их часть ) к странице pipe_buffer, которая в данный момент времени
является главной частью ring-а. Ядро узнает это путем проверки трех вещей:
Пуст ли канал, когда мы начинаем процесс записи(подразумевается наличие
доступных инициализированных буферов, !was_empty)
Установлен ли флаг PIPE_BUF_FLAG_CAN_MERGE. buf->flags &
PIPE_BUF_FLAG_CAN_MERGE
Достаточно ли места осталось в странице. offset + chars <= PAGE_SIZE
Если ответ на все эти пункты положительный, ядро начинает запись, добавляя данные
к существующей странице.
Чтобы завершить оставшуюся часть записи, ядро перемещает заголовок(head) к
следующему pipe_buffer, выделяет для него новую страницу, инициализирует
флаги (устанавливается флаг PIPE_BUF_FLAG_CAN_MERGE, если только
пользователь явно не запрашивает, чтобы канал находился в режиме O_DIRECT) и
записывает данные в начало новой страницы. Это продолжается до тех пор, пока не
останется данных для записи (или не заполнится канал).Что касается режима
O_DIRECT для pipe():
Эта обработка происходит в if-условии is_packetized(filp) в pipe_write() (см. выше).
Мы также можем наблюдать эти два типа записи в отладчике. Первая запись
выполняется в пустой канал и, таким образом, инициализирует наш ранее
заполненный нулями буфер канала.
Все остальные записи идут по “пути добавления” и заполняют существующую
страницу.
Reading
Затем наш PoC «опустошает» канал, считывая все “A” с конца.
Сценарий, когда процесс запрашивает у ядра чтение(read()) из канала,
обрабатывается функцией pipe_read():
Если канал не пустой, данные берутся из tail-indexed буфера pipe_buffer. В случае,
если буфер «опустошается» во время чтения, исполняется указатель функции release
ops поля в pipe_buffer. Для pipe_buffer, который был инициализирован более ранней
функцией write(), поле ops является указателем на struct pipe_buf_operations
anon_pipe_buf_ops.
Таким образом, исполняется функция anon_pipe_buf_release(), которая вызывает
put_page() для того, чтобы освободить нашу ссылку на страницу. Обратите внимание,
что хотя указатель ops установлен на NULL, чтобы сигнализировать об освобождении
буфера, поля page и flags в pipe_buffer остаются неизменными. Из этого выходит, что
ответственность за код, который может повторно использовать буфер канала для
инициализации всех его полей, лежит на нем. Мы можем это зафиксировать, если
посмотрим на структуры каналов после последней read операции.
Для нас ключевыми выводами является:
Записи в канал могут добавляться к странице pipe_buffer-а, если установлен
флаг PIPE_BUF_FLAG_CAN_MERGE.
Этот флаг установлен по умолчанию для буферов, которые инициализируются
записью.
«Опустошение» канала с помощью read() оставляет флаги pipe_buffers без
изменений.
Однако запись в канал не единственный способ его заполнения.
Pipes (splicing)
Помимо чтения и записи, программный интерфейс Linux также предполагает
системный вызов splice, предназначенный для перемещения данных из канала или в
него. И именно с ним наш PoC работает далее:
Но поскольку этот системный вызов может быть не так известен как другие, давайте
кратко обсудим его с точки зрения пользователя. Ниже приведен отрывок из
документации для разработчиков Linux.
Итак, как упоминалось выше, процесс может получить дескриптор файла, используя
системный вызов sys_open. Если процесс хочет записать содержимое файла(или его
часть) в канал, у него есть разные варианты сделать это. Он может производить
операцию чтения(read()) данных из файла в буфер своей памяти(или mmap() файла),
а затем записать(write()) их в канал. Однако весь этот процесс включает в себя три
контекстных переключения в kernel-user-space. Чтобы вся эта операция выполнялась
более эффективно, ядро Linux использует системный вызов sys_splice. По сути, он выполняет копирование(на самом деле это является не совсем копированием, это
можно будет увидеть ниже) из одного файлового дескриптора в другой в пространстве
ядра. Как мы скоро увидим, в этом есть немалый смысл, поскольку содержимое файла
или канала уже присутствует в памяти ядра в виде буфера, страницы или другой
структуры. Либо fd_in, либо fd_out должен являтьcя каналом.
Другой «fd» может быть сокетом, файлом, блочным устройством, символьным
устройством или другим каналом. Вы можете вновь обратиться к статье Макса
Келлерманна, где показан пример того, как splicing используется для оптимизации
ПО(и как это самое ПО привело к обнаружению описанной им ошибки :). Также
полезным опытом будет прочтение данной статьи, в которой Линус Торвальдс
объясняет работу системного вызова splice.
Реализация системного вызова splice
Идея реализации splice проиллюстрирована на рисунке ниже. После splicing’а и
канал, и кеш страниц имеют разные представления одних и тех же данных в памяти.

Для того, чтобы убедиться, что представленная выше схема верна, мы начнем с точки
входа системного вызова SYSCALL_DEFINE6(splice. ) и первым делом перейдем к
функции __do_splice(), которая отвечает за копирование из userspace и в userspace.
Вызываемая функция do_splice() определяет, что именно мы хотим сделать:
присоединиться к каналу, установить соединение с/из/между каналами. В первом
случае нижеприведенная функция вызывается:
С этого момента, execution path зависит от типа файла, который мы хотим “соединить”
с каналом. Поскольку нашей целью является обычный файл, а имеющаяся
виртуальная машина использует файловую систему ext2, реализация системного
вызова splice находится в ext2_file_operations.
Примечание: если у вас есть желание, вы можете более подробно разобраться Linux
VFS, которая хорошо описана в официальной документации к Linux.
Вызов generic_file_splice_read() наконец приводит нас к filemap_read(). Заметьте, что
в этот момент мы переключаемся с файловой системы fs/ на подсистему управления
памятью ядра(memory managment subsystem of the kernel) mm/. Дополнительно.
В этой функции происходит фактическое копирование(без реального побайтового
копирования) данных из кеша страниц в канал. В цикле данные копируются частями, с
помощью вызова функции copy_folio_to_iter(). Обратите внимание, что folio это не
совсем то же самое, что и страница, но для наших целей это не столь важно.
Но что если мы внимательно посмотрим на реализацию данной операции в
copy_page_to_iter_pipe()? Мы заметим, что на самом деле данные не копируется
вообще!
Сначала мы пытаемся “присоединить” текущую операцию копирования к предыдущей,
попробовав увеличить длину pipe_buffer в начале. В случае если это невозможно, мы
просто “двигаем” заголовок(head), и помещаем ссылку на страницу, которую мы
копируем, в поле данной страницы, убедившись, что длина и смещение установлены
правильно. Идея эффективности sys_splice заключается в том, чтобы реализовать ее
как операцию с нулевым копированием(zero-copy), где вместо дублирования данных
используются указатели(pointers) и счетчики ссылок(reference counts).
Стоит отметить, что этот код имеет возможность повторно использовать
pipe_buffers(buf = &pipe->bufs[i_head & p_mask]), поэтому все поля должны быть
проверены и, при необходимости, повторно инициализированы, так как есть
вероятность существования некоторых старых значений, которые могут оказаться
неправильными. К этому в том числе относится отсутствие инициализации флагов, о
котором в своем исследовании упоминал Макс Келлерманн.
Мы также можем наблюдать эффект операции нулевого копирования(zero-copy
operation) и отсутствия инициализации, воспользовавшись отладчиком.
Это состояние канала до splicing-a,
Указатель данных в struct_address_space и pipe_buffer в заголовке(head) одинаковы,
а длина и смещение отражают то, что наш PoC указал в вызове splice.
Обратите внимание, что мы повторно используем буфер, который мы ранее очистили,
заново инициализируя все поля, кроме флагов.
Так в чем же заключается проблема?
На данном этапе суть уязвимости становится очевидна. В случае с анонимными
буферами каналов разрешается продолжить запись там, где предыдущая была
остановлена, на что указывает флаг PIPE_BUF_FLAG_CAN_MERGE. С файловыми
буферами(file-backed buffers), созданными с помощью splicing’a, это должно быть
запрещено ядром, поскольку эти страницы «принадлежат» страничному кешу, а не
каналу.
Таким образом, когда мы производим операцию splicing’a данных из файла в канал,
необходимо установить buf->flags=0, чтобы запретить добавление данных к уже
существующей, но не полностью записанной, странице(buf->page), так как она
принадлежит страничному кешу(т. е. файлу). Когда мы снова производим операцию
pipe_write()(или просто write()) в нашей программе, мы записываем в страницу page
cache’a, потому что проверка buf->flags & PIPE_BUF_FLAG_CAN_MERGE
возвращает true(см. pipe_write).
Итак, главная проблема заключается в том, что мы начинаем с анонимного канала,
который затем будет «преобразован»(не весь, только некоторые буферы) в file-backed
канал с помощью splice(), но сам канал этой информации не получает, поскольку buf->flags значение не установлено на «0». Из этого следует, что слияние все еще разрешено.
Патч для устранения уязвимости заключается в добавлении недостающей инициализации.
Как мы можем видеть выше, наш PoC организовал установку флага
PIPE_BUF_FLAG_CAN_MERGE для буфера канала, повторно используемого для
соединения. Таким образом, последняя запись вызовет ошибку.
Возвращаясь к отладчику, мы видим, что финальный вызов pipe_write() добавляется к
частично заполненному pipe_buffer.
Также, мы видим, что содержимое файла было перезаписано с “owned by root” на
“pwned by user” в кеше страницы.
В терминале мы можем подтвердить, что произошло изменение для всех процессов в
системе.
Также можно отметить, что изменения данных в кеше страницы не записываются на
диск. После очистки кеша содержимое файла возвращается в изначальное состояние.
Но, при этом, все программы будут использовать модифицированную версию из
страничного кеша, поскольку ядро будет предлагать вам использовать кешированную версию данных файла, так как это прямая задача страничного кеша.
Ограничения
Существуют некоторые ограничения на записи, которые мы можем выполнять с
использованием этой техники, связанные с реализацией каналов и страничного кеша,
о которых также упоминает в своем исследовании Макс Келлерманн:
У атакующего должны быть права на чтение, так как необходимо выполнить
«копирование» страницы в канал с помощью splice().
Смещение не должно быть на границе страницы, поскольку по крайней мере
один байт этой страницы должен быть «скопирован» в канал, опять же, с
помощью splice().
Запись не может «пересекать» границу страницы, поскольку будет создан новый
анонимный буфер.
Размер файла не может быть изменен, так как канал самостоятельно управляет
заполнением страницы и не сообщает страничному кешу, сколько данных было
добавлено.
Вывод
Детальный анализ любой ошибки может создавать впечатление ее незначительности.
Однако это совсем не так. Для понимания ошибки и причины ее возникновения
требуется концептуальное понимание множества взаимодействующих между собой
подсистем, в нашем случае ядра Linux. Анализ первопричины без PoC, патча или
статьи с разбором уязвимости был бы довольно сложной задачей. Стоит также
отметить, что разбор данной уязвимости дает отличную возможность дополнить свои
знания о ядре Linux и посмотреть, как все работает «под капотом». В заключение,
справедливо будет заметить, что, в отличие от подобных уязвимостей, эксплуатация
изученной нами сегодня, довольно тривиальна, стабильна и, ко всему прочему,
работает в огромном количестве дистрибутивов Linux. Будем надеяться, что данная
статья пробудила в вас желание изучить какие-нибудь более сложные уязвимости/
эксплоиты, или погрузиться в исходный код ядра Linux :).
Saved searches
Use saved searches to filter your results more quickly
You signed in with another tab or window. Reload to refresh your session. You signed out in another tab or window. Reload to refresh your session. You switched accounts on another tab or window. Reload to refresh your session.
microsoft / WSL Public
Have a question about this project? Sign up for a free GitHub account to open an issue and contact its maintainers and the community.
By clicking “Sign up for GitHub”, you agree to our terms of service and privacy statement. We’ll occasionally send you account related emails.
Already on GitHub? Sign in to your account
CVE-2022-0847 «Dirty Pipe» Linux Kernel bug #8128
CVE-2022-0847 «Dirty Pipe» Linux Kernel bug #8128
Comments
Version
Microsoft Windows [Version 10.0.19044.1566]
WSL Version
- WSL 2
- WSL 1
Kernel Version
Distro Version
Other Software
Repro Steps
CVE-2022-0847 was first reported to the Linux kernel maintainers by Max Kellermann «max.kellermann@ionos.com» and was public disclosed earlier today (2022-03-07). The TL;DR is that this bug allows extremely low privileged accounts (including Nobody) to escalate privileges up to root, modify read-only files, and otherwise do serious damage if exploited.
I noticed that the WSL2 Kernel appears to be in one of the affected kernel releases, so I was wondering when a new release would roll out to address the bug. For reference, «The vulnerability was fixed in Linux [kernel versions] 5.16.11, 5.15.25 and 5.10.102.»
Technical details from Mr. Kellermann’s blog: https://dirtypipe.cm4all.com/
I didn’t use the security vulnerability reporting form since I’m not a security researcher in any way, shape or form. Just a sysadmin who reads ArsTechnica a lot. Apologies in advance if y’all are already well aware of this issue.