Как узнать, поддерживает ли процессор AVX
Аббревиатура AVX расшифровывается как Advanced Vector Extensions. Это наборы инструкций для процессоров Intel и AMD, идея создания которых появилась в марте 2008 года. Впервые такой набор был встроен в процессоры линейки Intel Haswell в 2013 году. Поддержка команд в Pentium и Celeron появилась лишь в 2020 году.
Прочитав эту статью, вы более подробно узнаете, что такое инструкции AVX и AVX2 для процессоров, а также — как узнать поддерживает ли процессор AVX.
AVX и AVX2 – что это такое
AVX/AVX2 — это улучшенные версии старых наборов команд SSE. Advanced Vector Extensions расширяют операционные пакеты со 128 до 512 бит, а также добавляют новые инструкции. Например, за один такт процессора без инструкций AVX будет сложена 1 пара чисел, а с ними — 10. Эти наборы расширяют спектр используемых чисел для оптимизации подсчёта данных.
Наличие у процессоров поддержки AVX весьма желательно. Эти инструкции предназначены, прежде всего, для выполнения сложных профессиональных операций. Без поддержки AVX всё-таки можно запускать большинство игр, редактировать фото, смотреть видео, общаться в интернете и др., хотя и не так комфортно.
Как узнать, поддерживает ли процессор AVX
Далее будут показаны несколько простых способов узнать это. Некоторые из методов потребуют установки специального ПО.
1. Таблица сравнения процессоров на сайте Chaynikam.info.
Для того чтобы узнать, поддерживает ли ваш процессор инструкции AVX, можно воспользоваться предлагаемым способом. Перейдите на этот сайт. В правом верхнем углу страницы расположена зелёная кнопка Добавить процессор. Нажмите её.
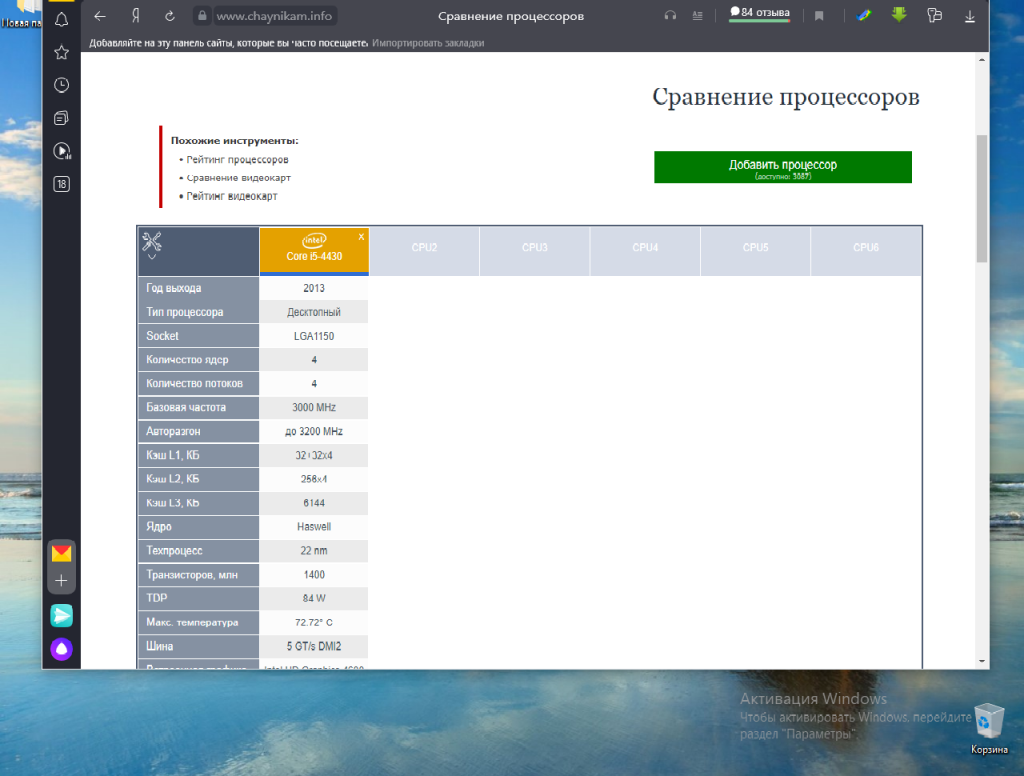
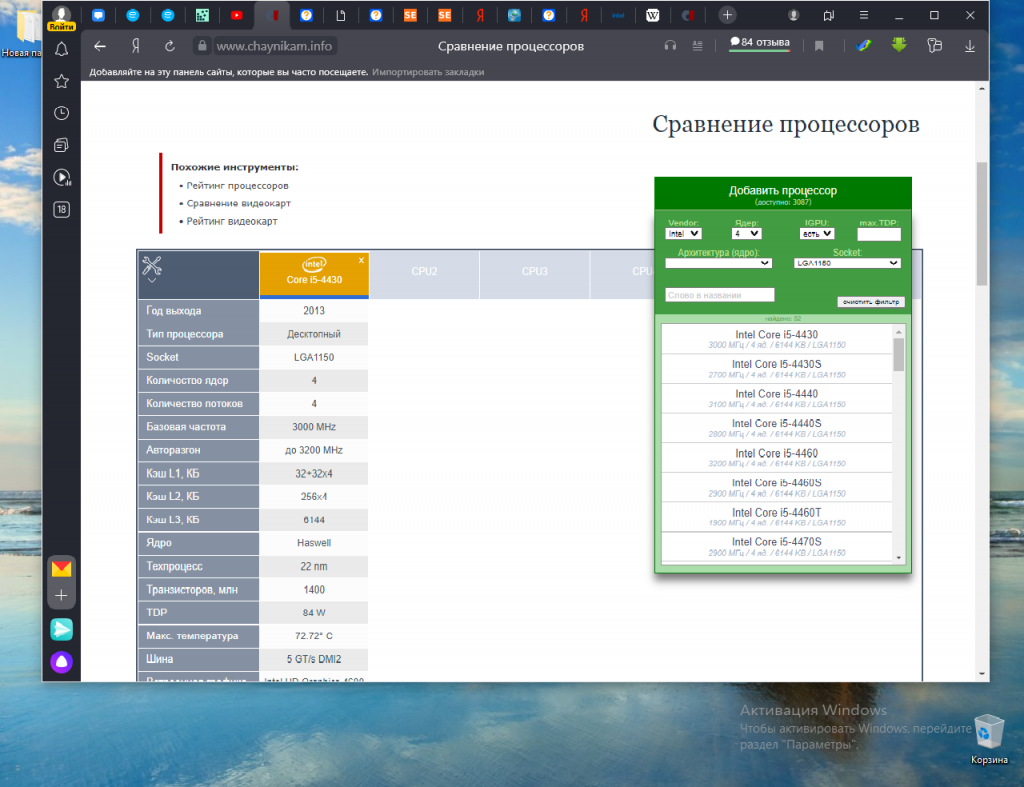
В открывшемся окне вам будет предложено указать параметры выбора нужного процессора. Все указывать не обязательно.
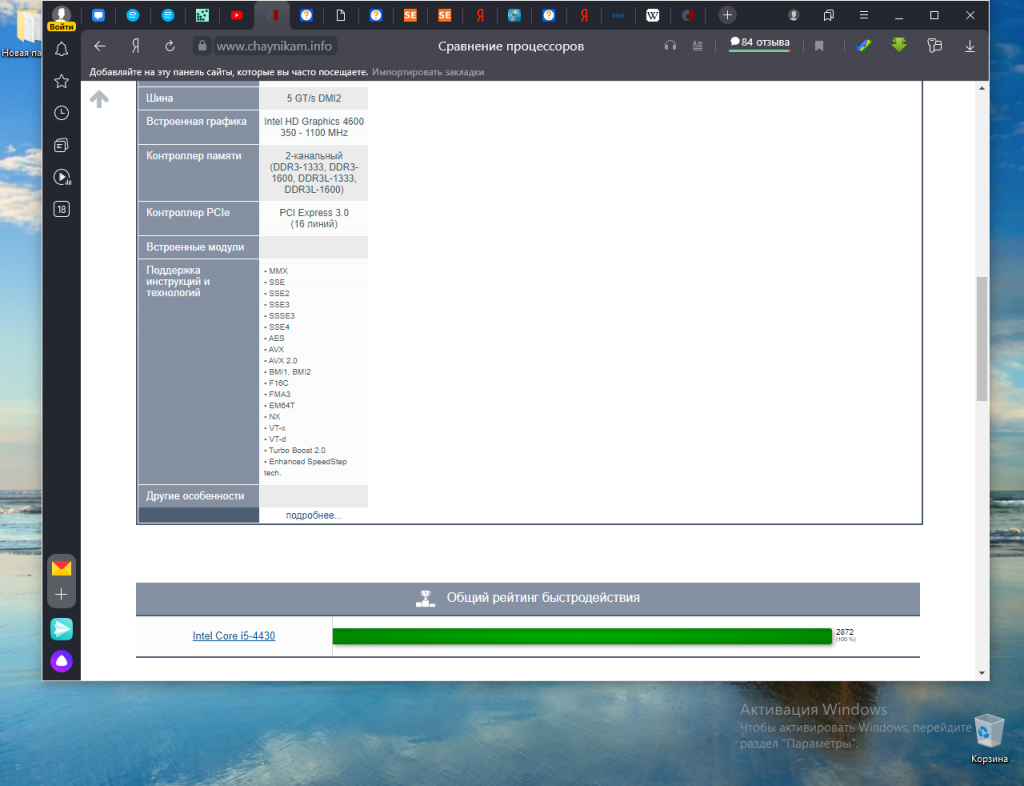
В результате выполнения поиска будет сформирована таблица с параметрами выбранного из списка процессора. Прокрутите таблицу вниз. В строке Поддержка инструкций и технологий будет показана подробная информация.
2. Утилита CPU-Z.
Один из самых простых и надёжных способов узнать поддерживает ли процессор AVX инструкции, использовать утилиту для просмотра информации о процессоре — CPU-Z. Скачать утилиту можно на официальном сайте. После завершения установки ярлык для запуска утилиты появится на рабочем столе. Запустите её.
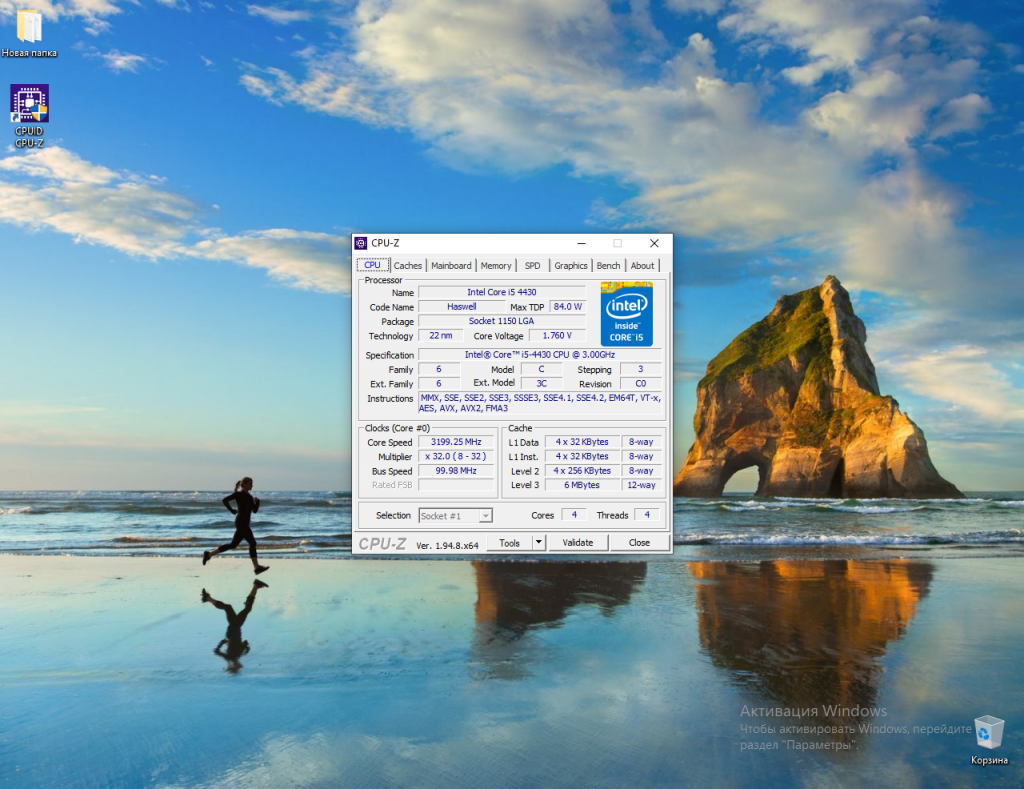
В строке Instructions показаны все инструкции и другие технологии, поддерживаемые вашим процессором.
3. Поиск на сайте производителя.
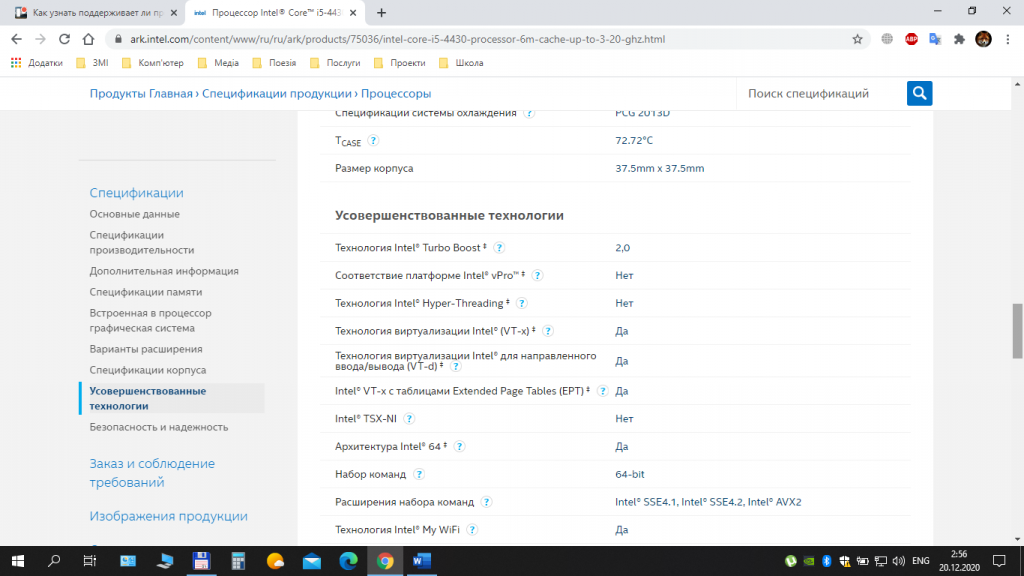
Ещё один способ узнать, есть ли AVX на процессоре, воспользоваться официальным сайтом производителя процессоров. В строке поиска браузера наберите название процессора и выполните поиск. Если у вас процессор Intel, выберите соответствующую страницу в списке и перейдите на неё. На этой странице вам будет предоставлена подробная информация о процессоре.
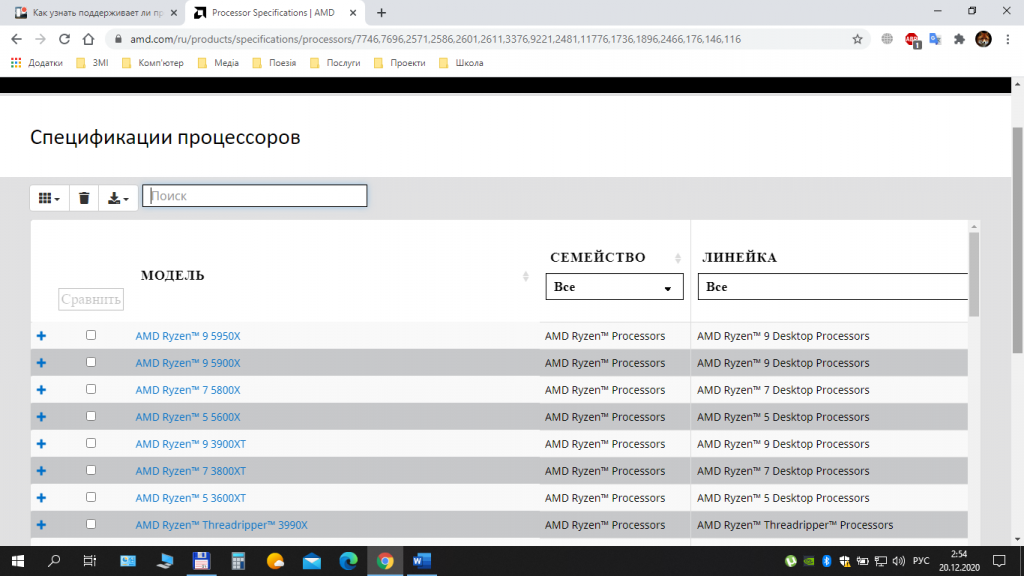
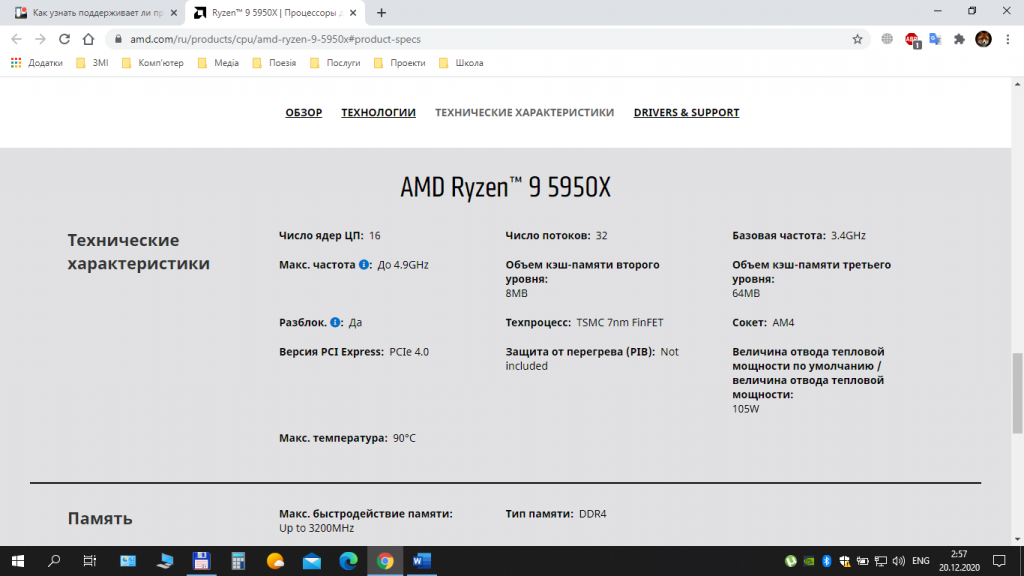
Если у вас процессор от компании AMD, то лучше всего будет воспользоваться сайтом AMD. Выберите пункт меню Процессоры, далее — пункт Характеристики изделия и затем, выбрав тип (например, Потребительские процессоры), выполните переход на страницу Спецификации процессоров. На этой странице выполните поиск вашего процессора по названию и посмотрите подробную информацию о нём.
Выводы
В этой статье мы довольно подробно рассказали о поддержке процессорами инструкций AVX, AVX2, а также показали несколько способов, позволяющих выяснить наличие такой поддержки конкретно вашим процессором. Надеемся, что дополнительная информация об используемом процессоре будет полезна для вас, а также поможет в выборе процессора в будущем.
У меня интересный вопрос. А для чего инструкция avx в процессорах? Будут ли игры на этой инструкции?
Новые игры должны быть уже скомпилены с учетом возможного наличия avx. Так ведь всегда — постепено появлялась поддержка mmx, sse, 3dnow и прочих вещей, которые сейчас уже стали стандартом для процессоров. Так и avx скоро будет поддерживаться всеми играми как само собой разумеющееся.
А применение простое:
Без avx для, например, сложения 10 пар чисел надо потратить 10 тактов процессора, а с avx это можно сделать примерно за 1 такт, что в 10 раз быстрее. Это уже можно было делать со времен mmx, просто avx, грубо говоря, позволяет использовать намного большие числа, чем mmx или sse.
Популярно об MMX, SSE и AVX
В мире компьютерных технологий нет ничего странного в обилии всевозможных аббревиатур: CPU, GPU, RAM, SSD, BIOS, CD-ROM, и многих других. И почти каждый день появляются всё новые и новые сокращения названий каких-то технологий, что является неизбежным следствием бесконечного стремления инженеров улучшить функции и возможности наших вычислительных устройств.
Сегодня речь пойдёт о таких расширениях набора команд процессоров, как MMX, SSE и AVX. Многим знакомы эти сокращения, и мы выясним, действительно ли это какие-то интересные разработки, или же это не более чем бессмысленные маркетинговые уловки.
Ну о-о-очень первые дни
Середина 80-х прошлого столетия. Рынок процессоров был очень похож на сегодняшний. Intel бесспорно преобладала, но столкнулась с жесткой конкуренцией со стороны AMD. Домашние компьютеры, такие как Commodore 64, использовали базовые 8-битные процессоры, тогда как настольные ПК начинали переходить с 16-битных на 32-битные чипы.
Эти числа означают размер значений данных, которые могут быть обработаны математически, при этом чем выше эти значения, тем выше точность и возможности. Они также определяет размер основных регистров в микросхеме: небольших участков памяти, используемых для хранения рабочих данных.
Такие процессоры являются также скалярными и целочисленными. Что это означает? Скаляр – это когда над одним элементом данных выполняется только одна любая математическая операция. Обычно это обозначается как SISD (single instruction, single data, «одиночный поток команд – одиночный поток данных»).
Таким образом, инструкция по сложению двух значений данных просто обрабатывается для этих двух чисел. А если вам, например, нужно прибавить одно и то же значение к группе из 16 чисел, то для этого потребуется выполнить все 16 наборов инструкций – для каждого числа из этой группы по отдельности. По-другому процессоры тех лет складывать ещё не умели.
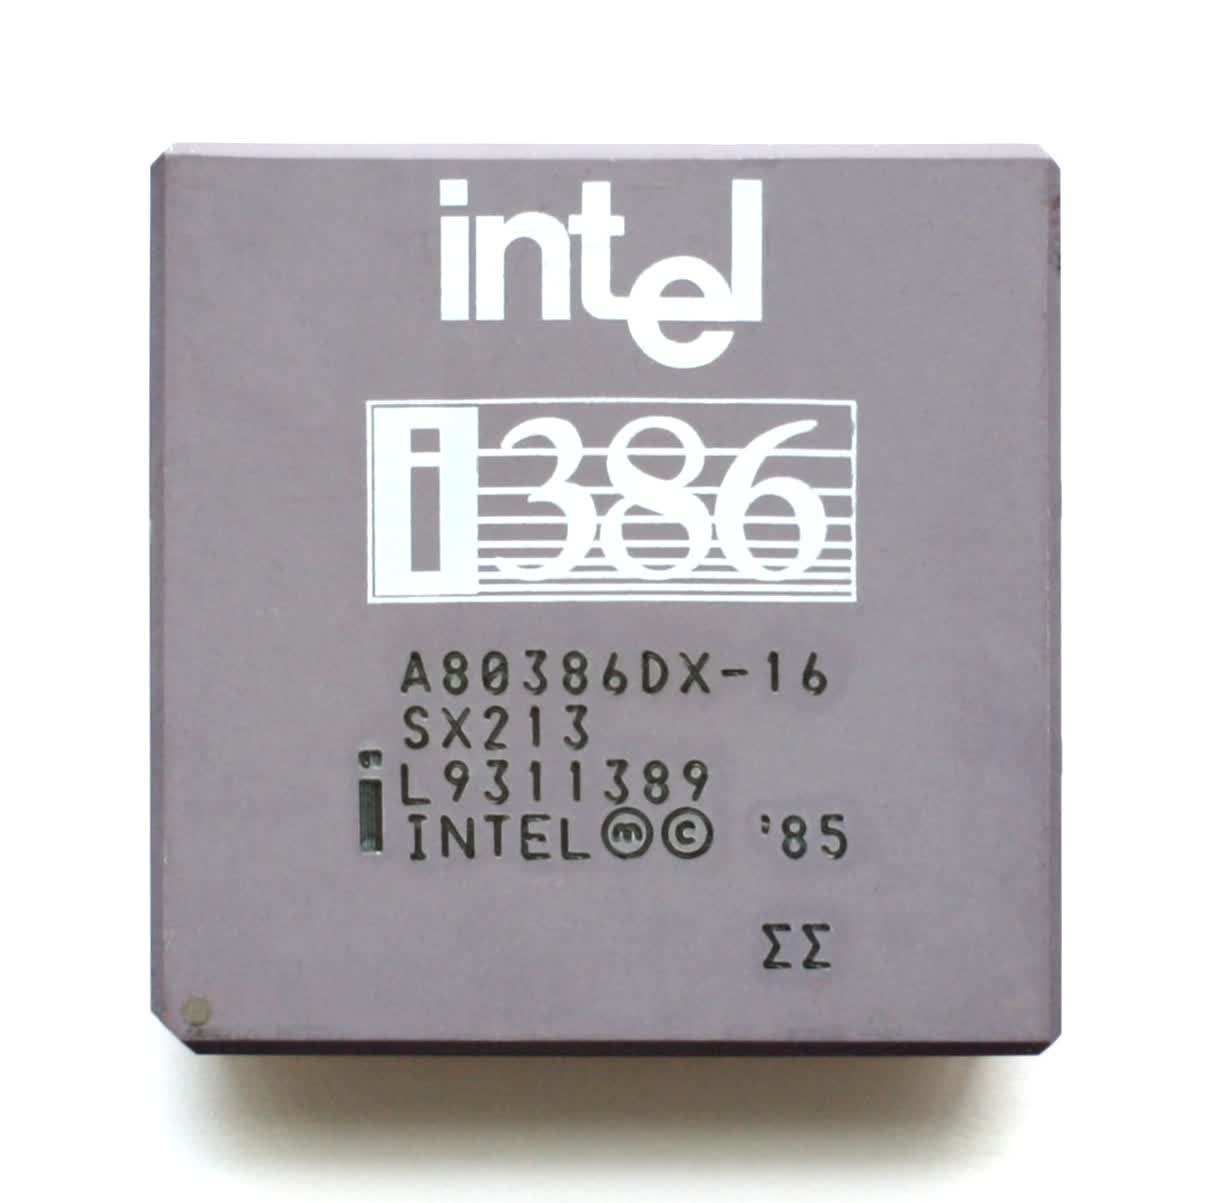
Intel 80386DX с частотой 16МГц (1985).
Целое (Integer) – в математике, это такое число, которое не имеет дробной части. Например, 8 или -12. Процессоры типа интеловского 80386SX не имели врожденной способности сложить, скажем, 3.80 и 7.26 – такие дробные числа называются числами с плавающей точкой (или запятой, в русском языке это без разницы) – по-английски FP, floating point или просто floats. Чтобы справиться с ними, нужен был другой процессор, например 80387SX, и отдельный набор инструкций – список команд, который сообщает процессору, что делать.
В те времена под инструкциями x86 понимали наборы команд для целочисленных (integer) операций, а под инструкциями x87 – для чисел с плавающей точкой (float). В наши дни все операции умеет выполнять один процессор, поэтому мы используем термин x86 для обозначения набора инструкций обоих типов данных.
Использование отдельных сопроцессоров для обработки разных типов данных было нормой, пока Intel не представила 80486: их первый CPU для персоналок со встроенным математическим сопроцессором для обработки вещественных данных (FPU, Floating Point Unit).
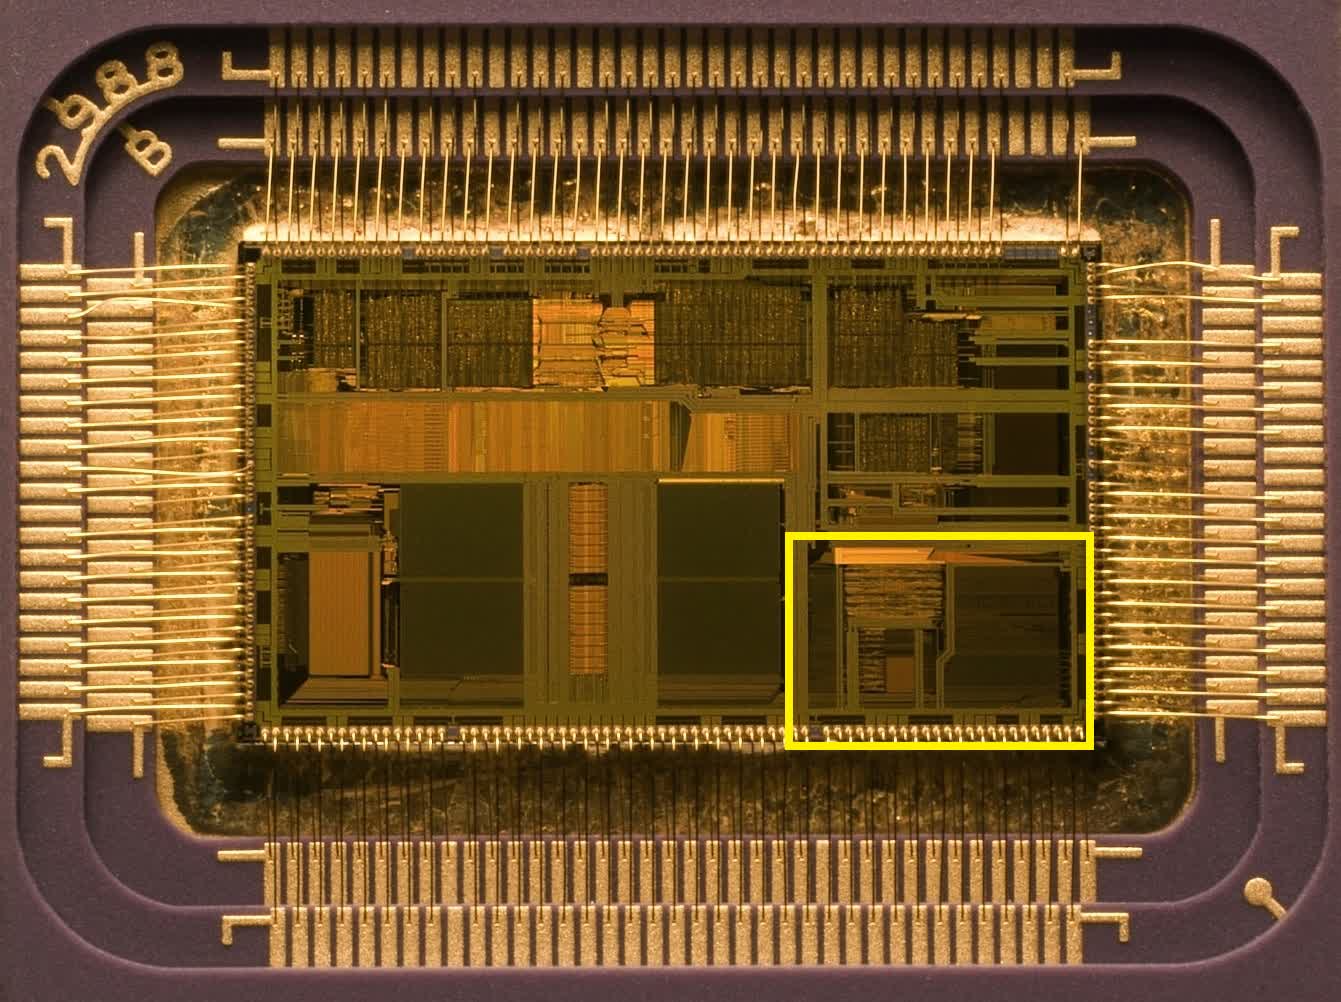
Intel 80486: Жёлтым цветом выделен блок FPU для обработки чисел с плавающей точкой.
Как вы можете видеть, этот блок совсем немного занимает места в процессоре, но рывок в производительности, благодаря этому решению, был огромен.
Но в целом принцип работы оставался скалярным, и таким он перешел и к преемнику 486-го: оригинальному Intel Pentium.
И пройдёт ещё три года после релиза этого первого Пентиума, прежде чем Intel представит миру Pentium MMX. Это произошло в октябре 1996 года.
V – значит «векторный». А MMX что значит?
В мире математики числа можно группировать в наборы различных видов и размеров – одна такая упорядоченная совокупность называется арифметическим вектором. Проще всего представить его себе в виде списка значений, расположенных горизонтально или вертикально. Технология MMX привнесла в мир процессоров возможность выполнять векторные математические вычисления.
Однако она была изначально довольно ограниченной, поскольку оперировала только целыми числами и фактически эксплуатировала для своих целей регистры FPU. Поэтому программисты, желающие использовать какие-то инструкции MMX, вынуждены иметь в виду, что при выполнении таких инструкций любые вычисления с плавающей запятой не могут выполняться одновременно с ними.
Знаменитая реклама технологии Intel MMX (1997).
FPU Pentium имел 64-битные регистры, и в операциях MMX каждый из них мог вместить два 32-битных, четыре 16-битных или восемь 8-битных целых числа. Именно эти группы чисел и являются векторами, и каждая инструкция, предназначенная для них, будет выполняться сразу над всеми значениями в группе.
Такой принцип получил название SIMD (single instruction, multiple data, «одиночный поток команд, множественный поток данных») и знаменует собой большой шаг вперед в развитии возможностей процессоров для персональных компьютеров.
Ну а какие приложения выигрывают от использования такого принципа? Практически все, которым приходится выполнять одинаковые вычисления над группой однородных данных, и в первую очередь это некоторые функции в 3D-моделировании и мультимедийных технологиях, а также в системах обработки стандартных сигналов.
Например, MMX можно применить для ускорения умножения матриц при обработке вершин в 3D, или для смешивания видеопотоков при работе с хромакеем или альфа-композитингом.

Процессор AMD K6-2 – где-то там есть 3DNow!
К сожалению, внедрение MMX продвигалось довольно медленными темпами из-за негативного влияния этой технологии на производительность операций с плавающей точкой. AMD частично решила эту проблему, создав свою собственную версию под названием 3DNow! примерно через два года после появления MMX. Технология от AMD предлагала больше инструкций SIMD и умела обрабатывать числа с плавающей точкой, но также страдала от недостатка понимания программистами.
Ах, да! Как же официально расшифровывается аббревиатура MMX? Согласно Intel – никак!
Проще пареной SSE
Ситуация переломилась в лучшую сторону с приходом в 1999 году процессора Intel Pentium III. Он принёс с собой блестящую реализацию векторной функции под названием SSE (Streaming SIMD Extensions, «потоковые расширения SIMD»). На этот раз это был дополнительный набор из восьми 128-битных регистров, отдельных от регистров в FPU, и стек дополнительных инструкций для обработки чисел с плавающей точкой.
Использование независимых регистров означает, что больше нет такой сильной зависимости от FPU, хотя Pentium III не мог выполнять инструкции SSE одновременно с инструкциями FP. А также, новая функция поддерживает только один тип данных в регистрах: четыре 32-битных FP-числа.
Но переход к использованию FP-инструкций SIMD позволил значительно увеличить производительность в таких приложениях, как кодирование/декодирование видео, обработка изображений и звука, сжатие файлов и многих других.
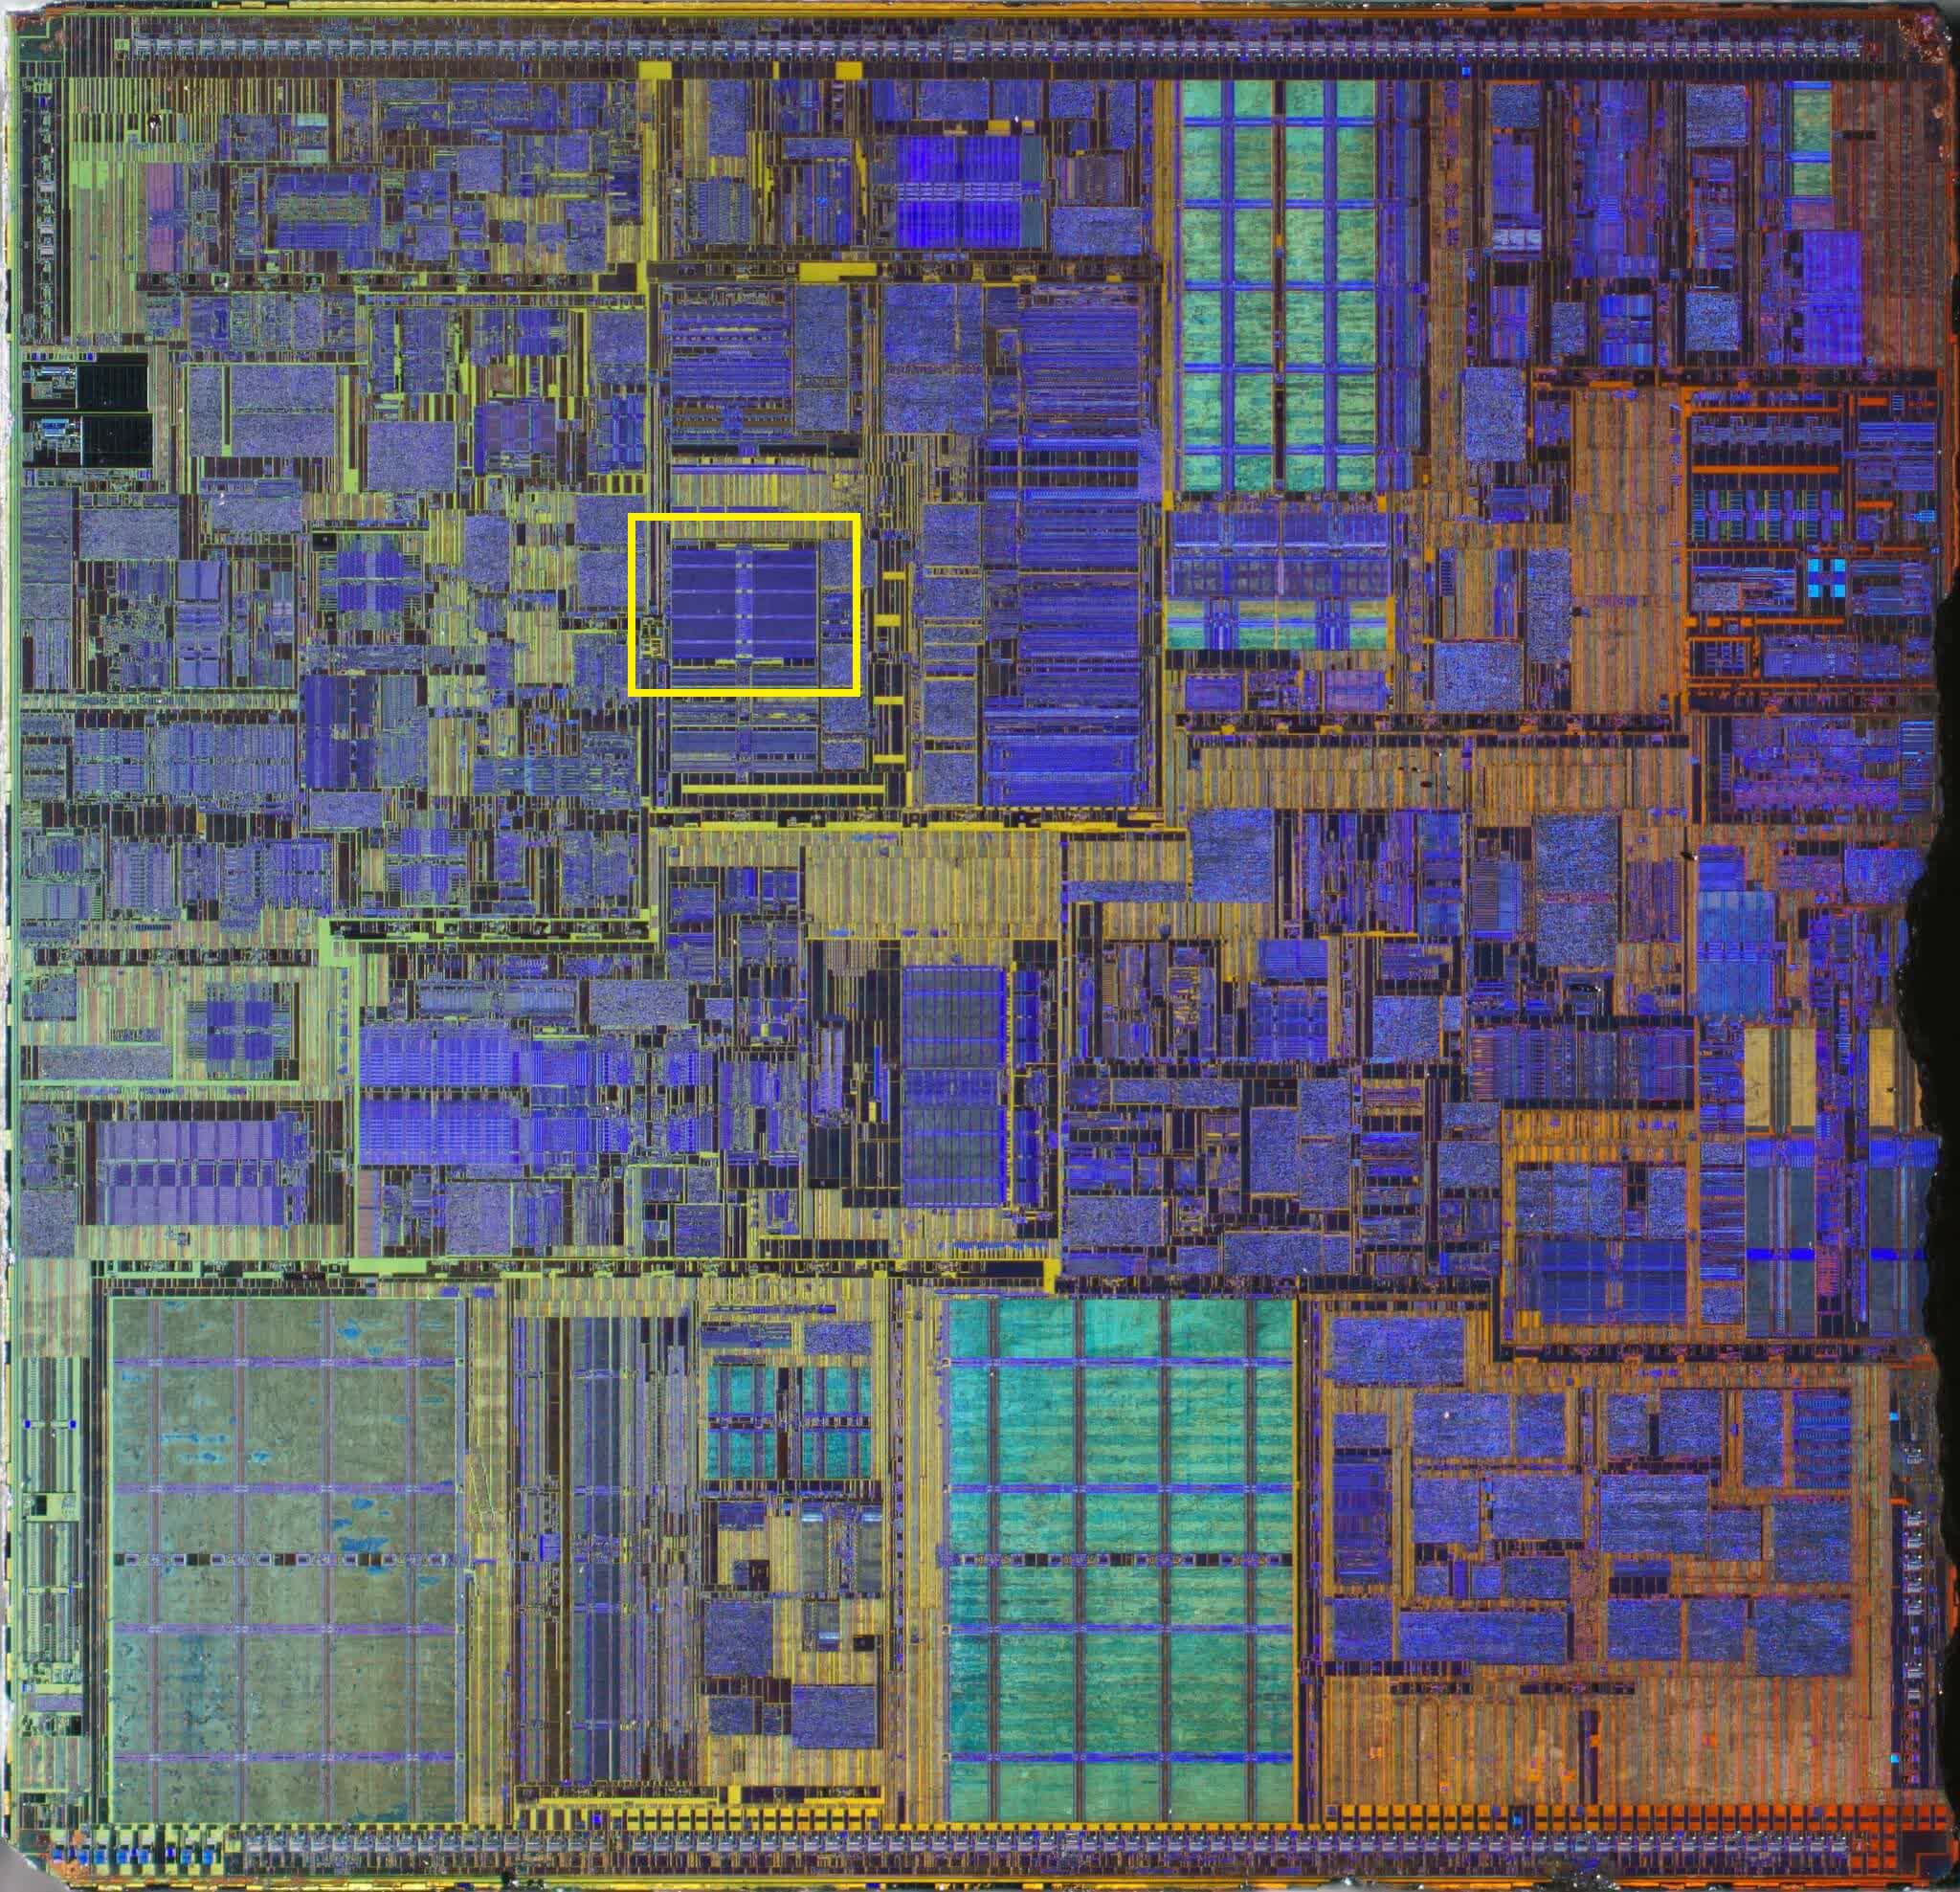
Pentium IV: желтым цветом выделен блок регистров SSE2.
Усовершенствованная версия SSE2 появилась в 2001 году вместе с Pentium 4, и на этот раз поддержка типов данных была намного лучше: четыре 32-битных или два 64-битных FP-числа, а также шестнадцать 8-битных, восемь 16-битных, четыре 32-битных или два 64-битных целых числа. Регистры MMX остались в процессоре, но все операции MMX и SSE могли выполняться с использованием независимых 128-битных регистров SSE.
Модификация SSE3 появилась на свет в 2003 году, имея больше инструкций и возможность выполнять некоторые математические вычисления между значениями внутри одного регистра.
Ещё через 3 года мы познакомились с архитектурой Intel Core, принёсшей ещё одну ревизию технологии SIMD (SSSE3 – Supplemental SSE, «расширенные SSE»), и чуть позже в том же году – финальную версию, SSE4.
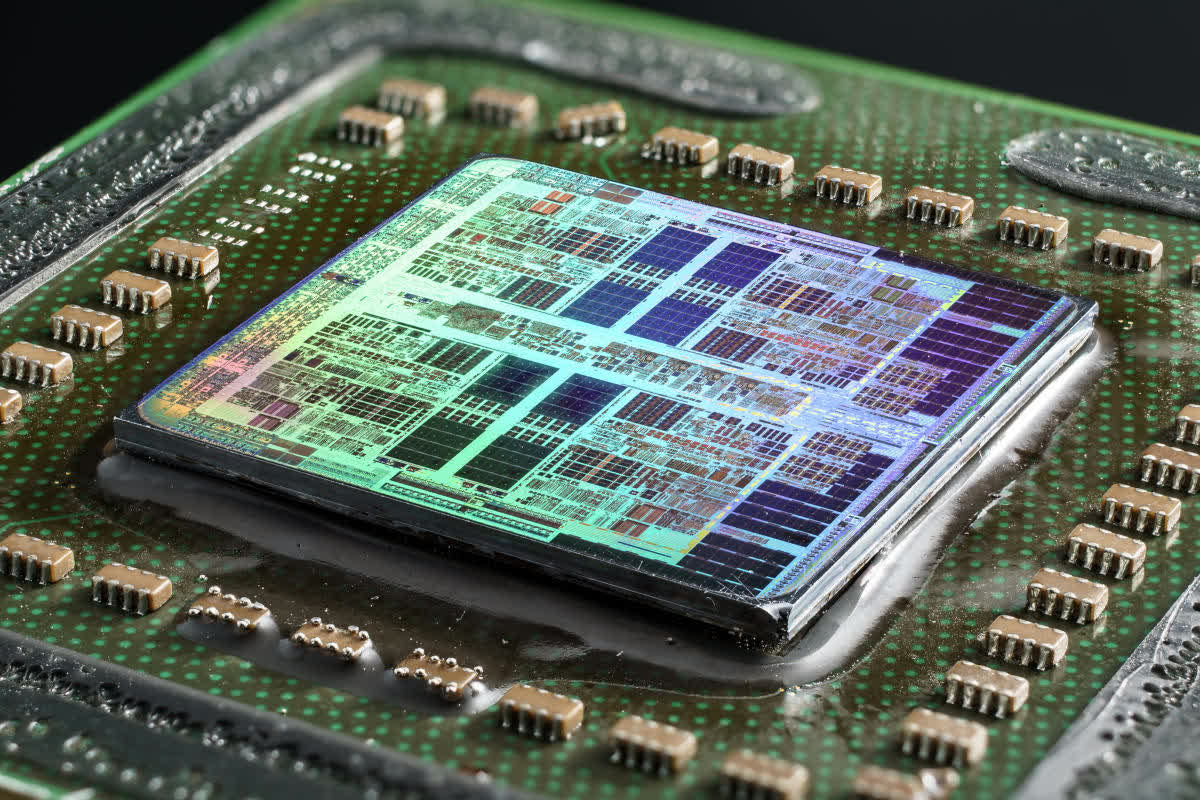
В 2007 году AMD применила собственную версию расширений CPU-инструкций SSE4 в своей архитектуре Barcelona. С названием в AMD париться не стали, и назвали свою версию просто SSE4a.
С линейкой Nehalem Core в 2008 году было выпущено незначительное обновление этой версии, которую Intel обозначила как SSE4.2 (а под SSE4.1 стали понимать исходную версию этого обновления). Обновления не затронули регистры, а лишь добавили больше инструкций в таблицу, расширив диапазон возможных математических и логических операций.
AMD, со своей стороны, сперва предложила новую версию SSE5, но позже решила разделить ее на три отдельных расширения, одно из которых довольно проблемное – подробнее об этом чуть позже.
К концу 2008 года и Intel, и AMD поставляли процессоры, которые уже могли обрабатывать все версии наборов инструкций от MMX до SSE4.2, и многие приложения (в основном игры) начали требовать этих функций для работы.
Время для новых букв
2008 год также был годом, когда Intel объявила о том, что они работают над значительным апгрейдом своей системы SIMD, и в 2011 году выкатила линейку процессоров Sandy Bridge с поддержкой набора инструкций AVX (Advanced Vector Extensions, «продвинутые векторные расширения»).
Всё удвоилось: вдвое больше векторных регистров и вдвое больше их размер.
Шестнадцать 256-битных регистров вмещают только восемь 32-битных или четыре 64-битных вещественных числа, поэтому в плане форматов данных, этот набор инструкций более ограничен в сравнении с SSE, но ведь и SSE никто не отменял. К тому времени программная поддержка векторных операций для CPU была уже хорошо отлажена, начиная с фундаментального мира компиляторов, заканчивая сложными приложениями.
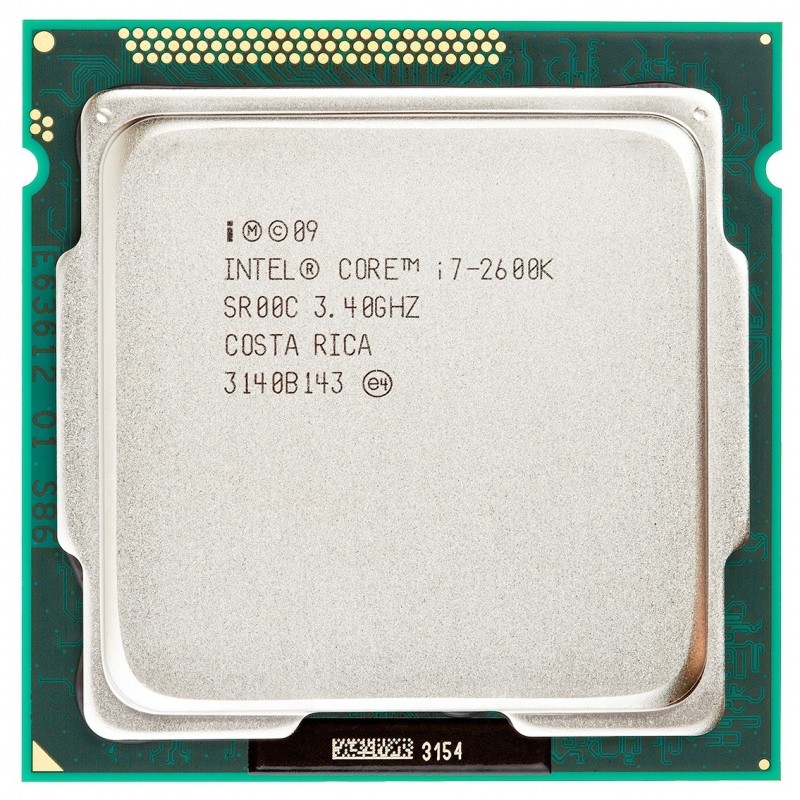
И не даром: Core i7-2600K (или подобный ему), работающий на частоте 3,8ГГц, потенциально может выдавать более 230 GFLOPS (миллиардов операций с плавающей точкой в секунду) при выполнении инструкций AVX – неплохо для дополнения, относительно немного места занимающего на кристалле процессора.
Или могло бы быть неплохо, если бы он действительно работал на частоте 3,8ГГц. Частично проблема AVX заключалась в том, что нагрузка на чип получалась настолько высокой, что Intel пришлось заставить процессор автоматически снижать тактовую частоту в этом режиме примерно на 20%, чтобы уменьшить энергопотребление и не допустить перегрева. К сожалению, такова цена за выполнение любой работы SIMD в современном процессоре.
Еще одно усовершенствование, предлагаемое в AVX – это возможность работать одновременно с тремя значениями. Во всех версиях SSE операции выполнялись между двумя значениями, после чего результат заменял одно из них в регистре. При выполнении инструкций SIMD AVX не трогает исходные значения, сохраняя результирующее значение в отдельный регистр.
AVX2 был выпущен вместе с архитектурой Haswell для процессоров Core 4-го поколения в 2013 году, и представлял собой довольно значительный апгрейд, благодаря добавлению нового расширения: FMA (Fused Multiply-Add, «умножение-сложение с однократным округлением»).
Эта независимая функция в составе AVX2 была крайне востребована для приложений, работающих с векторной и матричной математикой, поскольку давала возможность выполнять две операции с помощью одной инструкции. Функция поддерживала и скалярные операции также.
Проблема оказалась в том, что FMA от Intel отличался от аналогичного расширения AMD настолько, что они были совершенно несовместимы. Причина в том, что Intel FMA представляет собой систему с тремя операндами, то есть работает с тремя отдельными значениями: два слагаемых и сумма, либо три слагаемых и сумма, замещающая одно из слагаемых.
У версии от AMD четыре операнда, поэтому она может вычислить 3 числа и записать ответ в отдельный регистр, не трогая исходные значения. Математически FMA4 лучше, чем FMA3, но его реализация немного сложнее, как с точки зрения программирования, так и с точки зрения интеграции функции в процессор.
AVX-512: а не многовато-ли?
AVX2 ещё только начал появляться на рынке процессоров, а Intel уже плела маниакальные планы относительно его преемника, AVX-512, и общий настрой среди разработчиков был такой: «больше регистров богу регистров!». Мало того, что этих самых регистров снова вдвое больше, и они снова вдвое увеличились в размере, так ещё и появился стек новых инструкций и поддержка устаревших.
Первой партией чипов, на которых поднялся в воздух набор функций AVX-512, стала серия Xeon Phi 7200 – второе поколение громоздких и очень многоядерных процессоров Intel, ориентированных на рынок суперкомпьютеров.
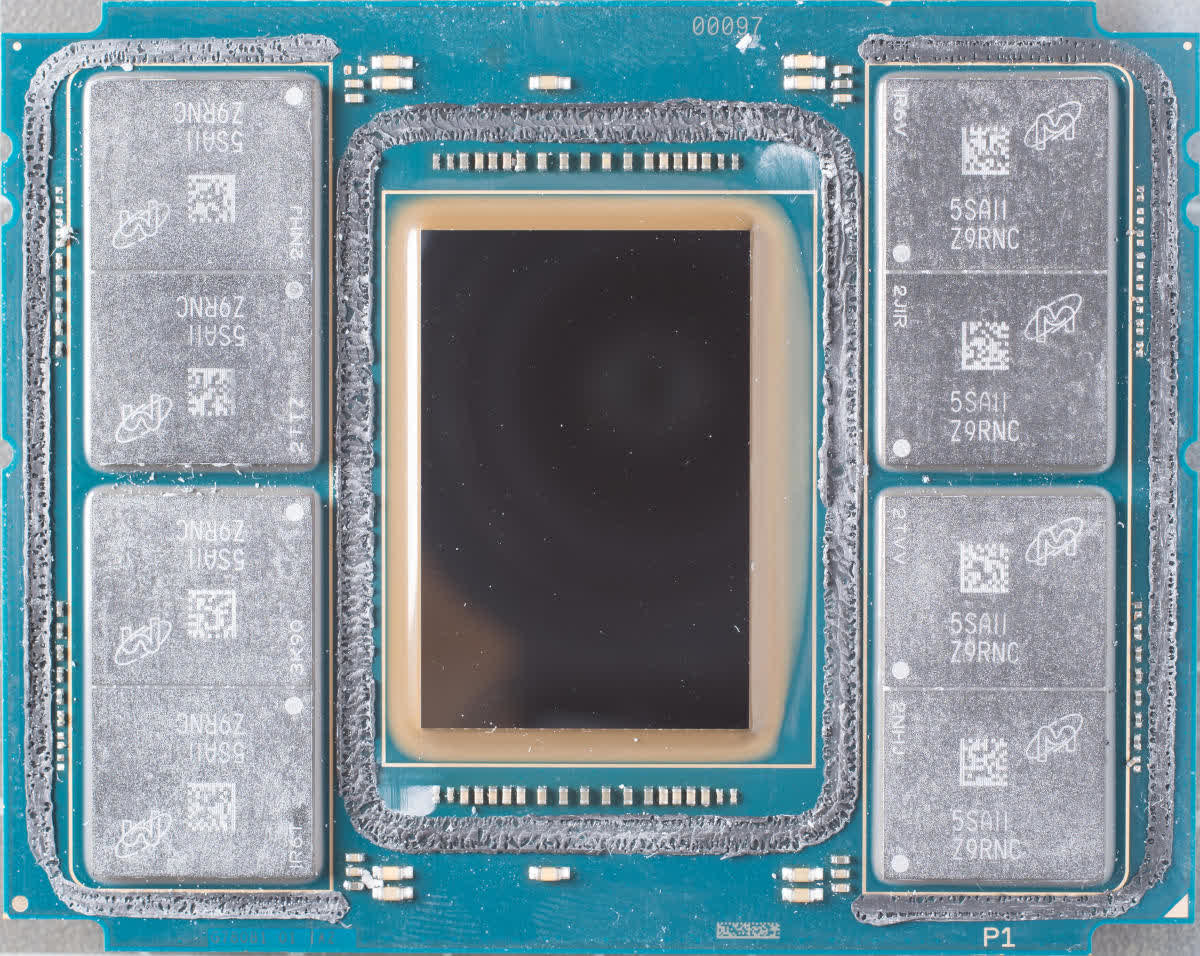
72-ядерный 288-потоковый Knights Landing Xeon Phi.
В отличие от всех предыдущих реализаций, новый набор векторных инструкций состоял из 19-и компонентов: базового – AVX-512F, – необходимого для обеспечения совместимости, и множества весьма специфических. Эти дополнительные наборы охватывают такие области операций, как обратная математика, целочисленные FMA и алгоритмы свёрточной (конволюционной) нейронной сети (CNN-алгоритмы).
Первоначально AVX-512 был только прерогативой крупнейших чипов Intel, предназначенных для рабочих станций и серверов, но теперь их недавние архитектуры Ice Lake и Tiger Lake также поддерживают его. Да, не удивляйтесь: вы можете купить легкий ноутбук с процессором, имеющим 512-битные векторные блоки.
Это может показаться круто. А может и не показаться – в зависимости от вашей точки зрения. Регистры на кристалле CPU обычно группируются в так называемом регистровом файле, как видно на макрофото ниже.
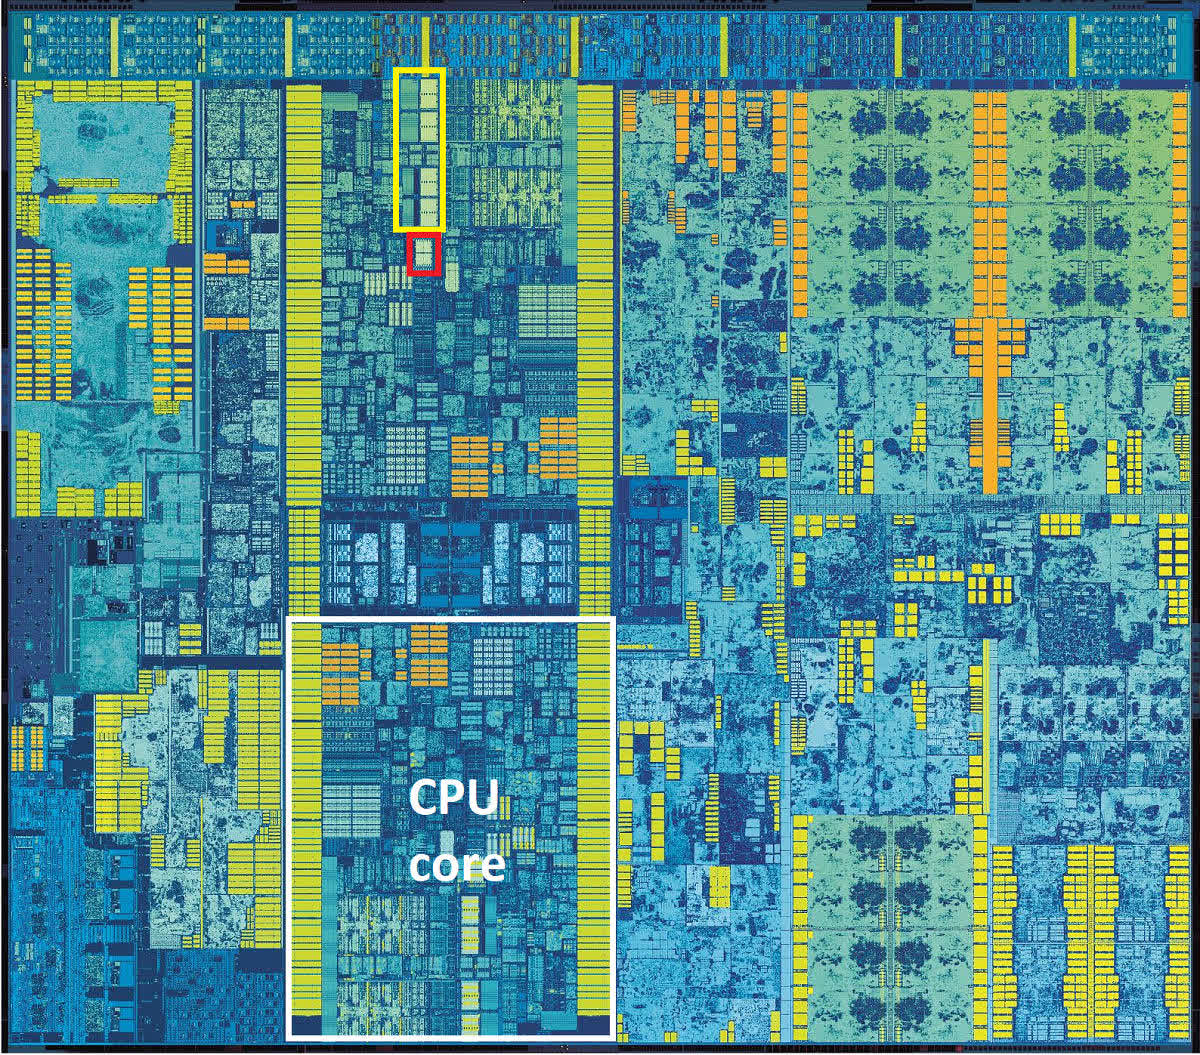 2-ядерный Intel Skylake
Желтым прямоугольником выделен файл векторных регистров, красный прямоугольник – это наиболее вероятное расположение файла целочисленного регистра. Обратите внимание, насколько файл векторного регистра больше integer-регистра. В Skylake используются 256-битные регистры AVX2, следовательно аналогичный векторный регистровый файл AVX-512 занял бы на таком же кристалле в четыре раза больше места: вдвое больше, потому что вдвое больше их размер, и ещё вдвое – потому что самих регистров вдвое больше.
А очень-ли нужно такое количество векторных регистров маленькому чипу, который должен быть максимально мобильным? Хоть речь и не о лишних килограммах в ноутбуке, а лишь о небольшой части площади ядра процессора, каждый квадратный миллиметр имеет значение, когда речь идет о миниатюризации мобильных устройств и наиболее эффективном использовании доступного пространства в них.
И учитывая, что использование AVX в любом виде приводит к автоматическому уменьшению тактовой частоты, использование AVX-512 на таких платформах скорее всего приведет к ещё более сомнительным издержкам по сравнению с любым из своих предшественников, поскольку при работе он потребляет еще больше энергии.
И проблема AVX-512 не только в применении к небольшим мобильным процессорам. Разработчикам, пишущим код для работы на рабочих станциях и серверах, и для которых увеличение возможностей векторных расширений действительно важный вопрос, потребуется создавать несколько версий кода. Это связано с тем, что не все процессоры с AVX-512 работают с одинаковым набором команд.
Например, набор IFMA (Integer Fused Multiply Add, «целочисленное умножение-сложение с однократным округлением») доступен только на процессорах Cannon, Ice и Tiger Lake. В то время как процессоры на архитектуре Cooper и Cascade Lake его не поддерживают, несмотря на то, что они относятся к сегменту процессоров для серверов и рабочих станций.
Стоит отметить, что AMD не предлагает поддержку AVX-512, и не собирается. По их мнению, обработка массивных векторных вычислений – это прерогатива GPU. С AMD полностью солидарна Nvidia, и обе компании уже выпустили продукты специально для таких нужд.
И дальше что?
Много лет назад процессор с возможностью обработки векторной математики ознаменовал собой эпохальный прорыв. Современные процессоры обладают огромными возможностями, предлагая множество наборов инструкций для обработки целочисленных операций и операций с плавающей запятой для скалярных, векторных и матричных данных.
Что касается последних двух типов данных, то CPU теперь напрямую конкурируют с GPU: ведь мир 3D-графики – это как раз всё, что связано с SIMD, векторами, плавающими точками и т.д. И производители GPU не спали – разработка графических ускорителей велась стремительными темпами. В начале 2010-х годов купить видеокарту, процессор которой способен выполнять почти 800 миллиардов инструкций SIMD в секунду, вы уже могли менее чем за 500 долларов.
Это больше, чем то, на что сейчас способны лучшие из десктопных CPU. Но они и не предназначены для рекордов в какой-то конкретной области – их задача обрабатывать очень обобщенный код, который зачастую не повторяется или легко распараллеливается. Поэтому, не стоит думать, что возможности SIMD столь жизненно-важны для CPU, скорее это полезное дополнение к его арсеналу.
 Вас интересует производительность SIMD в чистом виде? Ваш выбор – видеокарта, а не материнка!
Стремительное развитие графических процессоров недвусмысленно намекает, что для CPU нет нужды иметь чересчур большие векторные блоки, и почти наверняка именно поэтому AMD даже не пыталась разрабатывать своего собственного преемника для AVX2 (расширение, которое они используют в своих чипах с 2015 года). Давайте также не будем забывать, что процессоры следующего поколения могут больше походить на мобильные однокристальные (SoC, System-on-a-Chip), где под каждый тип задач выделена площадь на кристалле. Intel, в свою очередь, похоже, стремится внедрить AVX-512 в как можно большее количество продуктов.
Ждёт ли нас ещё и AVX-1024? Вряд ли, либо очень нескоро. Скорее всего, Intel займётся расширением AVX-512 с помощью дополнительных компонентов с инструкциями, чтобы повысить гибкость, а чистую SIMD-производительность переложит на плечи своей недавно разработанной линейки графических процессоров Xe.
Библиотеки SSE и AVX теперь являются неотъемлемой частью программного обеспечения: Adobe Photoshop требует, чтобы процессоры поддерживали как минимум SSE4.2; API машинного обучения TensorFlow требует поддержки AVX; Microsoft Teams может выполнять фоновые видеоэффекты, только если доступен AVX2.
Это говорит только об одном: несмотря на то, что в плане обработки SIMD графическим процессорам нет равных, этот функционал ещё долго будет в арсенале CPU. Так что будем ждать нового поколения векторных расширений и надеюсь, реклама нас впечатлит.
Использование Intel AVX: пишем программы завтрашнего дня
Чтобы убедиться в работоспособности AVX кода лучше написать к нему Unit-тесты. Однако встаёт вопрос: как запустить эти Unit-тесты, если ни один ныне продаваемый процессор не поддерживает AVX? В этом вам поможет специальная утилита от Intel — Software Development Emulator (SDE). Всё, что умеет SDE — это запускать программы, на лету эмулируя новые наборы инструкций. Разумеется, производительность при этом будет далека от таковой на реальном железе, но проверить корректность работы программы таким образом можно. Использовать SDE проще простого: если у вас есть unit-тест для AVX кода в файле avx-unit-test.exe и его нужно запускать с параметром «Hello, AVX!», то вам просто нужно запустить SDE с параметрами
sde — avx-unit-test.exe «Hello, AVX!»
При запуске программы SDE сэмулирует не только AVX инструкции, но также и инструкции XGETBV и CPUID, так что если вы используете предложенный ранее метод для детектирования поддержки AVX, запущенная под SDE программа решит, что AVX действительно поддерживается. Кроме AVX, SDE (вернее, JIT-компилятор pin, на котором SDE построен) умеет эмулировать SSE3, SSSE3, SSE4.1, SSE4.2, SSE4a, AES-NI, XSAVE, POPCNT и PCLMULQDQ инструкции, так что даже очень старый процессор не помешает вам разрабатывать софт под новые наборы инструкций.
Оценка производительности AVX кода
Некоторое представление о производительности AVX кода можно получить с помощью другой утилиты от Intel — Intel Architecture Code Analyzer (IACA). IACA позволяет оценить время выполнения линейного участка кода (если встречаются команды условных переходов, IACA считает, что переход не происходит). Чтобы использовать IACA, нужно сначала пометить специальными маркерами участки кода, которые вы хотите проанализировать. Маркеры выглядят следующим образом:
; Начало участка кода, который надо проанализировать
%macro IACA_START 0
mov ebx, 111
db 0x64, 0x67, 0x90
%endmacro
- -32 — означает, что входной объектный файл (MS COFF) содержит 32-битный код. Для 64-битного кода нужно указывать -64. Если на вход IACA подаётся не объектный файл (.obj), а исполняемый модуль (.exe или .dll), то этот аргумент можно не указывать.
- -arch AVX — показывает IACA, что нужно анализировать производительность этого кода на будущем процессоре Intel с поддержкой AVX (т.е. Sandy Bridge). Другие возможные значения: -arch nehalem и -arch westmere.
- -cp DATA_DEPENDENCY просит IACA показать, какие инструкции находятся на критическом путе для данных (т.е. какие инструкции нужно соптимизировать, чтобы результат работы этого кода вычислялся быстрее). Другое возможное значение: -cp PERFORMANCE просит IACA показать, какие инструкции «затыкают» конвеер процессора.
- -mark 0 говорит IACA проанализировать все помеченные маркерами участки кода. Если задать -mark n, IACA будет анализировать только n-ый размеченный участок кода.
- -o avx-sample задаёт имя файла, в который будут записаны результаты анализа. Можно опустить этот параметр, тогда результаты анализа будут выведены в консоль.
Analysis Report
—————
Total Throughput: 2 Cycles; Throughput Bottleneck: FrontEnd, Port2_ALU, Port2_DATA, Port4
Total number of Uops bound to ports: 6
Data Dependency Latency: 14 Cycles; Performance Latency: 15 Cycles
N — port number, DV — Divider pipe (on port 0), D — Data fetch pipe (on ports 2 and 3)
CP — on a critical Data Dependency Path
N — number of cycles port was bound
X — other ports that can be used by this instructions
F — Macro Fusion with the previous instruction occurred
^ — Micro Fusion happened
* — instruction micro-ops not bound to a port
@ — Intel(R) AVX to Intel(R) SSE code switch, dozens of cycles penalty is expected
! — instruction not supported, was not accounted in Analysis
| Num of | Ports pressure in cycles | |
| Uops | 0 — DV | 1 | 2 — D | 3 — D | 4 | 5 | |
————————————————————
| 1 | | | | 1 | 2 | X | X | | | CP | vmovups ymm0, ymmword ptr [ecx]
| 2^ | | | | X | X | 1 | 1 | | 1 | | vbroadcastss ymm1, dword ptr [edx]
| 1 | 1 | | | | | | | | | CP | vmulps ymm0, ymm0, ymm1
| 2^ | | | | 1 | | X | | 2 | | CP | vmovups ymmword ptr [ecx], ymm0
| 0* | | | | | | | | | | | vzeroupper
Самыми важными метриками здесь являются Total Throughput и Data Dependency Latency. Если код, который вы оптимизируете, это небольшая подпрограмма, и в программе есть зависимость по данным от её результата, то вам нужно стараться сделать Data Dependency Latency как можно меньше. В качестве примера может служить приведённый выше листинг подпрограммы vec4_dot_avx. Если же оптимизируемый код — это часть цикла, обрабатывающего большой массив элементов, то ваша задача — уменьшать Total Throughput (вообще-то эта метрика должна была бы называться Reciprocal Throughput, ну да ладно).
Использование AVX в коде на C/C++
- Microsoft C/C++ Compiler начиная с версии 16 (входит в Visual Studio 2010)
- Intel C++ Compiler начиная с версии 11.1
- GCC начиная с версии 4.4
- /arch:AVX — для Microsoft C/C++ Compiler и Intel C++ Compiler под Windows
- -mavx — для GCC и Intel C++ Compiler под Linux
- /QxAVX — для Intel C++ Compiler
- /QaxAVX — для Intel C++ Compiler
Определение поддержки AVX системой
- Windows 7
- Windows Server 2008 R2
- Linux с ядром 2.6.30 и выше
#define XSTATE_LEGACY_FLOATING_POINT 0
#define XSTATE_LEGACY_SSE 1
#define XSTATE_GSSE 2
#define XSTATE_MASK_LEGACY_FLOATING_POINT (1i64 << (XSTATE_LEGACY_FLOATING_POINT))
#define XSTATE_MASK_LEGACY_SSE (1i64 << (XSTATE_LEGACY_SSE))
#define XSTATE_MASK_LEGACY (XSTATE_MASK_LEGACY_FLOATING_POINT | XSTATE_MASK_LEGACY_SSE)
#define XSTATE_MASK_GSSE (1i64 << (XSTATE_GSSE))
#define MAXIMUM_XSTATE_FEATURES 64
Нетрудно заметить, что маски XSTATE_MASK_* соответствуют аналогичным битам регистра XFEATURE_ENABLED_MASK.
В дополнение к этому, в Windows DDK есть описание функции RtlGetEnabledExtendedFeatures и констант XSTATE_MASK_XXX, как две капли воды похожих на GetEnabledExtendedFeatures и XSTATE_MASK_* из WinNT.h. Т.о. для определения поддержки AVX со стороны Windows можно воспользоваться следующим кодом:
int isAvxSupportedByWindows() <
const DWORD64 avxFeatureMask = XSTATE_MASK_LEGACY_SSE | XSTATE_MASK_GSSE;
return GetEnabledExtendedFeatures( avxFeatureMask ) == avxFeatureMask;
>
Если ваша программа должна работать не только в Windows 7 и Windows 2008 R2, то функцию GetEnabledExtendedFeatures нужно подгружать динамически из kernel32.dll, т.к. в других версиях Windows этой функции нет.
В Linux, насколько мне известно, нет отдельной функции, чтобы узнать о поддержке AVX со стороны ОС. Но вы можете воспользоваться тем фактом, что поддержка AVX было добавлена в ядро 2.6.30. Тогда остаётся только проверить, что версия ядра не меньше этого значения. Узнать версию ядра можно с помощью функции uname.
Использование AVX-инструкций
Написание AVX-кода с использованием intrinsic-функций не вызовет у вас затруднений, если вы когда-либо использовали MMX или SSE посредством intrinsic’ов. Единственное, о чём нужно позаботиться дополнительно, это вызвать функцию _mm256_zeroupper() в конце подпрограммы (как нетрудно догадаться, эта intrinsic-функция генерирует инструкцию vzeroupper). Например, приведённая выше ассемблерная подпрограмма vec4_dot_avx может быть переписана на intrinsic’ах так:
double vec4_dot_avx( double a[4], double b[4] ) <
// mmA = a
const __m256d mmA = _mm256_loadu_pd( a );
// mmB = b
const __m256d mmB = _mm256_loadu_pd( b );
// mmAB = ( a3 * b3, a2 * b2, a1 * b1, a0 * b0 )
const __m256d mmAB = _mm256_mul_pd( mmA, mmB );
// mmABHigh = ( +0.0, +0.0, a3 * b3, a2 * b2 )
const __m256d mmABHigh = _mm256_permute2f128_pd( mmAB, mmAB, 0x81 );
// mmSubSum = ( +0.0, +0.0, a1 * b1 + a3 * b3, a0 * b0 + a2 * b2 )
const __m128d mmSubSum = _mm_add_pd(
_mm256_castpd256_pd128( mmAB ),
_mm256_castpd256_pd128( mmABHigh )
);
// mmSum = ( +0.0, +0.0, +0.0, a0 * b0 + a1 * b1 + a2 * b2 + a3 * b3 )
const __m128d mmSum = _mm_hadd_pd( mmSubSum, _mm_setzero_pd() );
const double result = _mm_cvtsd_f64( mmSum );
_mm256_zeroupper();
return result;
>
Тестирование AVX кода
Если вы используете набор инструкций AVX посредством intrinsic-функций, то, кроме запуска этого кода под эмулятором SDE, у вас есть ещё одна возможность — использовать специальный заголовочный файл, эмулирующий 256-битные AVX intrinsic-функции через intrinsic-функции SSE1-SSE4.2. В этом случае у вас получится исполняемый файл, который можно запустить на процессорах Nehalem и Westmere, что, конечно, быстрее эмулятора. Однако учтите, что таким методом не получиться обнаружить ошибки генерации AVX-кода компилятором (а они вполне могут быть).
Оценка производительности AVX кода
Использование IACA для анализа производительности AVX кода, созданного C/C++ компилятором из intrinsic-функций почти ничем не отличается от анализа ассемблерного кода. В дистрибутиве IACA можно найти заголовочный файл iacaMarks.h, в котором описаны макросы-маркеры IACA_START и IACA_END. Ими нужно пометить анализируемые участки кода. В коде подпрограммы маркер IACA_END должен находиться до оператора return, иначе компилятор «соптимизирует», выкинув код маркера. Макросы IACA_START/IACA_END используют inline-ассемблер, который не поддерживается Microsoft C/C++ Compiler для Windows x64, поэтому если для него нужно использовать специальные варианты макросов — IACA_VC64_START и IACA_VC64_END.
Заключение
В этой статье было продемонстрировано, как разрабатывать программы с использованием набора инструкций AVX. Надеюсь, что это знание поможет вам радовать своих пользователей программами, которые используют возможности компьютера на все сто процентов!