Титаны кластерного фронта: Решения для построения кластеров от Microsoft и Oracle

Как известно, кластеры позволяют решать проблемы, связанные с производительностью, балансировкой нагрузки и отказоустойчивостью. Для построения кластеров используются различные решения и технологии, как на программном, так и на аппаратном уровне. В этой статье будут рассмотрены программные решения, предлагаемые компаниями Microsoft и Oracle.
Виды кластеров
Кластер — это группа независимых компьютеров (так называемых узлов или нодов), к которой можно получить доступ как к единой системе. Кластеры могут быть предназначены для решения одной или нескольких задач. Традиционно выделяют три типа кластеров:
- Кластеры высокой готовности или отказоустойчивые кластеры (high-availability clusters или failover clusters) используют избыточные узлы для обеспечения работы в случае отказа одного из узлов.
- Кластеры балансировки нагрузки (load-balancing clusters) служат для распределения запросов от клиентов по нескольким серверам, образующим кластер.
- Вычислительные кластеры (compute clusters), как следует из названия, используются в вычислительных целях, когда задачу можно разделить на несколько подзадач, каждая из которых может выполняться на отдельном узле. Отдельно выделяют высокопроизводительные кластеры (HPC — high performance computing clusters), которые составляют около 82% систем в рейтинге суперкомпьютеров Top500.
Системы распределенных вычислений (gird) иногда относят к отдельному типу кластеров, который может состоять из территориально разнесенных серверов с отличающимися операционными системами и аппаратной конфигурацией. В случае грид-вычислений взаимодействия между узлами происходят значительно реже, чем в вычислительных кластерах. В грид-системах могут быть объединены HPC-кластеры, обычные рабочие станции и другие устройства.

Такую систему можно рассматривать как обобщение понятия «кластер». ластеры могут быть сконфигурированы в режиме работы active/active, в этом случае все узлы обрабатывают запросы пользователей и ни один из них не простаивает в режиме ожидания, как это происходит в варианте active/passive.
Oracle RAC и Network Load Balancing являются примерами active/ active кластера. Failover Cluster в Windows Server служит примером active/passive кластера. Для организации active/active кластера требуются более изощренные механизмы, которые позволяют нескольким узлам обращаться к одному ресурсу и синхронизовать изменения между всеми узлами. Для организации кластера требуется, чтобы узлы были объединены в сеть, для чего наиболее часто используется либо традиционный Ethernet, либо InfiniBand.

Программные решения могут быть довольно чувствительны к задержкам — так, например, для Oracle RAC задержки не должны превышать 15 мс. В качестве технологий хранения могут выступать Fibre Channel, iSCSI или NFS файловые сервера. Однако оставим аппаратные технологии за рамками статьи и перейдем к рассмотрению решений на уровне операционной системы (на примере Windows Server 2008 R2) и технологиям, которые позволяют организовать кластер для конкретной базы данных (OracleDatabase 11g), но на любой поддерживаемой ОС.
Windows Clustering
У Microsoft существуют решения для реализации каждого из трех типов кластеров. В состав Windows Server 2008 R2 входят две технологии: Network Load Balancing (NLB) Cluster и Failover Cluster. Существует отдельная редакция Windows Server 2008 HPC Edition для организации высокопроизводительных вычислительных сред. Эта редакция лицензируется только для запуска HPC-приложений, то есть на таком сервере нельзя запускать базы данных, web- или почтовые сервера.

NLB-кластер используется для фильтрации и распределения TCP/IPтрафика между узлами. Такой тип кластера предназначен для работы с сетевыми приложениями — например, IIS, VPN или межсетевым экраном.
Могут возникать сложности с приложениями, которые полага ются на сессионные данные, при перенаправлении клиента на другой узел, на котором этих данных нет. В NLB-кластер можно включать до тридцати двух узлов на x64-редакциях, и до шестнадцати — на x86.
Failoverclustering — это кластеризации с переходом по отказу, хотя довольно часто термин переводят как «отказоустойчивые кластеры».
Узлы кластера объединены программно и физически с помощью LAN- или WAN-сети, для multi-site кластера в Windows Server 2008 убрано требование к общей задержке 500 мс, и добавлена возможность гибко настраивать heartbeat. В случае сбоя или планового отключения сервера кластеризованные ресурсы переносятся на другой узел. В Enterprise edition в кластер можно объединять до шестнадцати узлов, при этом пятнадцать из них будут простаивать до тех пор, пока не произойдет сбой. Приложения без поддержки кластеров (cluster-unaware) не взаимодействуют со службами кластера и могут быть переключены на другой узел только в случае аппаратного сбоя.
Приложения с поддержкой кластеров (cluster-aware), разработанные с использованием ClusterAPI, могут быть защищены от программных и аппаратных сбоев.
Развертывание failover-кластера
Процедуру установки кластера можно разделить на четыре этапа. На первом этапе необходимо сконфигурировать аппаратную часть, которая должна соответствовать The Microsoft Support Policy for Windows Server 2008 Failover Clusters. Все узлы кластера должны состоять из одинаковых или сходных компонентов. Все узлы кластера должны иметь доступ к хранилищу, созданному с использованием FibreChannel, iSCSI или Serial Attached SCSI. От хранилищ, работающих с Windows Server 2008, требуется поддержка persistent reservations.
На втором этапе на каждый узел требуется добавить компонент Failover Clustering — например, через Server Manager. Эту задачу можно выполнять с использованием учетной записи, обладающей административными правами на каждом узле. Серверы должны принадлежать к одному домену. Желательно, чтобы все узлы кластера были с одинаковой ролью, причем лучше использовать роль member server, так как роль domain controller чревата возможными проблемами с DNS и Exchange.
Третий не обязательный, но желательный этап заключается в проверке конфигурации. Проверка запускается через оснастку Failover Cluster Management. Если для проверки конфигурации указан только один узел, то часть проверок будет пропущена.
На четвертом этапе создается кластер. Для этого из Failover Cluster Management запускается мастер Create Cluster, в котором указываются серверы, включаемые в кластер, имя кластера и дополнительные настройки IP-адреса. Если серверы подключены к сетям, которые не будут использоваться для общения в рамках кластера (например, подключение только для обмена данными с хранилищем), то в свойствах этой сети в Failover Cluster Management необходимо установить параметр «Do not allow the cluster to use this network».
После этого можно приступить к настройке приложения, которое требуется сконфигурировать для обеспечения его высокой доступности.
Для этого необходимо запустить High Availability Wizard, который можно найти в Services and Applications оснастки Failover Cluster Management.
Cluster Shared Volumes
В случае failover-кластера доступ к LUN, хранящему данные, может осуществлять только активный узел, который владеет этим ресурсом. При переключении на другой узел происходит размонтирование LUN и монтирование его для другого узла. В большинстве случаев эта задержка не является критичной, но при виртуализации может требоваться вообще нулевая задержка на переключение виртуальных машин с одного узла на другой.

Еще одна проблема, возникающая из-за того, что LUN является минимальной единицей обхода отказа, заключается в том, что при сбое одного приложения, находящегося на LUN, приходится переключать все приложения, которые хранятся на этом LUN, на другой сервер. Во всех приложениях (включая Hyper-V до второго релиза Server 2008) это удавалось обходить за счет многочисленных LUN, на каждом из которых хранились данные только одного приложения. В Server 2008 R2 появилось решение для этих проблем, но предназначенное для работы только с Hyper-V и CSV (Cluster Shared Volumes).
CSV позволяет размещать на общем хранилище виртуальные машины, запускаемые на разных узлах кластера — тем самым разбивается зависимость между ресурсами приложения (в данном случае виртуальными машинами) и дисковыми ресурсами. В качестве файловой системы CSV использует обычную NTFS. Для включения CSV необходимо в Failover Cluster Manage выполнить команду Enable Cluster Shared Volumes. Отключить поддержку CSV можно только через консоль:
Для использования этой команды должен быть загружен Failover Clusters, модуль PowerShell. Использование CSV совместно с live migration позволяет перемещать виртуальные машины между физическими серверами в считанные миллисекунды, без обрыва сетевых соединений и совершенно прозрачно для пользователей. Стоит отметить, что копировать любые данные (например, готовые виртуальные машины) на общие диски, использующие CSV, следует через узел-координатор.
Несмотря на то, что общий диск доступен со всех узлов кластера, перед записью данных на диск узлы запрашивают разрешение у узлакоординатора. При этом, если запись требует изменений на уровне файловой системы (например, смена атрибутов файла или увеличение его размера), то записью занимается сам узел-координатор.
Oracle RAC
Oracle Real Application Clusters (RAC) — это дополнительная опция Oracle Database, которая впервые появилась в Oracle Database 9i под названием OPS (Oracle Parallel Server). Опция предоставляет возможность нескольким экземплярам совместно обращаться к одной базе данных. Базой данных в Oracle Database называет ся совокупность файлов данных, журнальных файлов, файлов параметров и некоторых других типов файлов. Для того, чтобы пользовательские процессы могли получить доступ к этим данным, должен быть запущен экземпляр. Экземпляр (instance) в свою очередь состоит из структур памяти (SGA) и фоновых процессов. В отсутствии RAC получить доступ к базе данных может строго один экземпляр.

Опция RAC не поставляется с Enterprise Edition и приобретается отдельно. Стоит отметить, что при этом RAC идет в составе Standard Edition, но данная редакция обладает большим количеством ограничений по сравнению с Enterprise Edition, что ставит под сомнение целесообразность ее использования.
Oracle Grid Infrastructure
Для работы Oracle RAC требуется Oracle Clusterware (или стороннее ПО) для объединения серверов в кластер. Для более гибкого управления ресурсами узлы такого кластера могут быть организованы в пулы (с версии 11g R2 поддерживается два варианта управления — на основании политик для пулов или, в случае их отсутствия, администратором).
Во втором релизе 11g Oracle Clusterware был объединен с ASM под общим названием Oracle Grid Infrastructure, хотя оба компонента и продолжают устанавливаться по различным путям.
Automatic Storage Management (ASM) — менеджер томов и файловая система, которые могут работать как в кластере, так и с singleinstance базой данных. ASM разбивает файлы на ASM Allocation Unit.
Размер Allocation Unit определяется параметром AU_SIZE, который задается на уровне дисковой группы и составляет 1, 2, 4, 8, 16, 32 или 64 MB. Далее Allocation Units распределяются по ASM-дискам для балансировки нагрузки или зеркалирования. Избыточность может быть реализована, как средствами ASM, так и аппаратно.
ASM-диски могут быть объединены в Failure Group (то есть группу дисков, которые могут выйти из строя одновременно — например, диски, подсоединенные к одному контролеру), при этом зеркалирование осуществляется на диски, принадлежащие разным Failure Group. При добавлении или удалении дисков ASM автоматически осуществляет разбалансировку, скорость которой задается администратором.

На ASM могут помещаться только файлы, относящиеся к базе данных Oracle, такие как управляющие и журнальные файлы, файлы данных или резервные копии RMAN. Экземпляр базы данных не может взаимодействовать напрямую с файлами, которые размещены на ASM. Для обеспечения доступа к данным дисковая группа должна быть предварительно смонтирована локальным ASM-экземпляром.
Oracle рекомендует использовать ASM в качестве решения для управления хранением данных вместо традиционных менеджеров томов, файловых систем или RAW-устройств.
Развертывание Oracle RAC
Рассмотрим этапы установки различных компонентов, необходимых для функционирования Oracle RAC в режиме active/active кластера с двумя узлами. В качестве дистрибутива будем рассматривать последнюю на момент написания статьи версию Oracle Database 11g Release 2. В качестве операционной системы возьмем Oracle Enterprise Linux 5. Oracle Enterprise Linux — операционная система, базирующаяся на RedHat Enterprise Linux. Ее основные отличия — цена лицензии, техническая поддержка от Oracle и дополнительные пакеты, которые могут использоваться приложениями Oracle.
Подготовка ОС к установке Oracle стандартна и заключается в создании пользователей и групп, задании переменных окружения и параметров ядра. Параметры для конкретной версии ОС и БД можно найти в Installation Guide, который поставляется вместе с дистрибутивом.
На узлах должен быть настроен доступ к внешним общим дискам, на которых будут храниться файлы базы данных и файлы Oracle Clusterware. К последним относятся votingdisk (файл, определяющий участников кластера) и Oracle Cluster Registry (содержит конфигурационную информацию — например, какие экземпляры и сервисы запущены на конкретном узле). Рекомендуется создавать нечетное количество votingdisk. Для создания и настройки ASMдисков желательно использовать ASMLib, которую надо установить на всех узлах:
# rpm -Uvh oracleasm-support-2.1.3-1.el4.x86_64.rpm
rpm -Uvh oracleasmlib-2.0.4-1.el4.x86_64.rpm
rpm -Uvh oracleasm-2.6.9-55.0.12.ELsmp-2.0.3-1.x86_64.rpm
Кроме интерфейса для взаимодействия с хранилищем на узлах желательно настроить три сети — Interconnect, External и Backup.
Необходимо настроить IP-адресацию (вручную или с использованием Oracl e GNS) и DNS для разрешения всех имен (или только GNS).
Вначале осуществляется установка Grid Infrastructure. Для этого загружаем и распаковываем дистрибутив, затем запускаем установщик. В процессе установки необходимо указать имя кластера; указать узлы, которые будут входить в кластер; указать назначение сетевых интерфейсов; настроить хранилище.
В конце нужно выполнить с правами root скрипты orainstRoot.sh и root.sh. Первым на всех узлах выполняется скрипт orainstRoot.sh, причем запуск на следующем узле осуществляется только после завершения работы скрипта на предыдущем. После выполнения orainstRoot.sh последовательно на каждом узле выполняется root.sh. Проверить успешность установки можно с помощью команды:
/u01/grid/bin/crsctl check cluster –all
Выполнив проверку, можно приступать к установке базы данных. Для этого запускаем Oracle Universal installer, который используется и для обычной установки базы.
Кроме active/active-кластера в версии 11g R2 существуют две возможности для создания active/passive-кластера. Одна из них — Oracle RACOneNode. Другой вариант не требует лицензии для RAC и реализуется средствами Oracle Clusterware. В этом случае вначале создается общее хранилище; затем устанавливается Grid Infrastructure, с использованием ASM_CRS и SCAN; а после этого на узлы устанавливается база данных в варианте Standalone. Далее создаются ресурсы и скрипты, которые позволяют запускать экземпляр на другом узле в случае недоступности первого.
Заключение
Oracle RAC совместно с Oracle Grid Infrastructure позволяют реализовать разнообразные сценарии построения кластеров. Гибкость настройки и широта возможностей компенсируются ценой такого решения.
Решения же Microsoft ограничены не только возможностями самой кластеризации, но и продуктами, которые могут работать в такой среде. Хотя стоит отметить, что набор таких продуктов все равно шире, чем одна база данных.
Что нового в Windows Server 2016 Failover Clustering
Всем привет! Совсем недавно была объявлена глобальная доступность Windows Server 2016, означающая возможность уже сейчас начать использование новой версии продукта в Вашей инфраструктуре. Список нововведений довольно обширный и мы уже описывали часть из них (тут и тут), но в этой статье разберем службы высокой доступности, которые, на мой взгляд, являются самыми интересными и используемыми (особенно в средах виртуализации).
Cluster OS Rolling upgrade
Миграция кластера в прошлых версиях Windows Server является причиной значительного простоя из-за недоступности исходного кластера и создания нового на базе обновленной ОС на узлах с последующей миграцией ролей между кластерами. Такой процесс несет повышенные требования к квалификации персонала, определенные риски и неконтролируемые трудозатраты. Данный факт особенно касается CSP или других заказчиков, которые имеют ограничения по времени недоступности сервисов в рамках SLA. Не стоит описывать, что для поставщика ресурсов означает значительное нарушение SLA )
Windows Server 2016 ситуацию исправляет через возможность совмещения Windows Server 2012 R2 и Windows Server 2016 на узлах в рамках одного кластера во время его апгрейда (Cluster OS Rolling Upgrade (далее CRU)).

Из названия можно догадаться, что процесс миграции кластера заключается в основном в поэтапной переустановке ОС на серверах, но об этом поговорим подробнее чуть позже.
Определим сначала список «плюшек», которые CRU предоставляет:
- Полное отсутствие простоя при апгрейде кластеров WS2012R2 Hyper-V/SOFS. Для других кластерных ролей (к примеру, SQL Server) возможна их недоступность (менее 5 минут), необходимая для отработки разового failover.
- Нет необходимости в дополнительном аппаратном обеспечении. Как правило, кластер строится из учета возможной недоступности одного или нескольких узлов. В случае с CRU, недоступность узлов будет планируемой и поэтапной. Таким образом, если кластер может безболезненно пережить временное отстутствие хотя бы 1 из узлов, то для достижения zero-downtime дополнительных узлов не требуется. Если планируется апгрейд сразу нескольких узлов (это поддерживается), то необходимо заранее спланировать распределение нагрузки между доступными узлами.
- Создание нового кластера не требуется. CRU использует текущий CNO.
- Процесс перехода обратим (до момента повышения уровня кластера).
- Поддержка In-Place Upgrade. Но, стоит отметить, что рекомендуемым вариантом обновления узлов кластера является полноценная установка WS2016 без сохранения данных (clean-os install). В случае с In-Place Upgrade обязательна проверка полной функциональности после обновления каждого из узлов (журналы событий и т.д.).
- CRU полностью поддерживается VMM 2016 и может быть автоматизирован дополнительно через PowerShell/WMI.
-
Рекомендуется предварительное резервное копирование кластера (БД) и выполняемых ресурсов. Кластер должен быть в работоспособном состоянии, узлы доступны. При необходимости следует исправить имеющиеся проблемы перед миграцией и приостановить задачи резервного копирования перед стартом перехода.


PS C:\Windows\system32> Update-ClusterFunctionalLevel
Updating the functional level for cluster hvcl.
Warning: You cannot undo this operation. Do you want to continue?
[Y] Yes [A] Yes to All [N] No [L] No to All [S] Suspend [?] Help (default is Y): a
Перечень версий ВМ, поддерживаемые 2016 RTM:
Cloud Witness
В любой кластерной конфигурации необходимо учитывать особенности размещения Witness для обеспечения дополнительного голоса и общего кворума. Witness в 2012 R2 может строиться на базе общего внешнего файлового ресурса или диска, доступных каждому из узлов кластера. Напомню, что необходимость конфигурации Witness рекомендована при любом количестве узлов, начиная с 2012 R2 (динамический кворум).
В Windows Server 2016 для обеспечения возможности построения DR на базе Windows Server и для других сценариев доступна новая модель кворумной конфигурации на базе Cloud Witness.
Cloud Witness использует ресурсы Microsoft Azure (Azure Blob Storage, через HTTPS, порты на узлах должны быть доступны) для чтения/записи служебной информации, которая изменяется при смене статуса кластерных узлов. Наименование blob-файла производится в соответствии с уникальным идентификатором кластера, — поэтому один Storage Account можно предоставлять нескольким кластерам сразу (1 blob-файл на кластер в рамках создаваемого автоматически контейнера msft-cloud-witness). Требования к размеру облачного хранилища минимальны для обеспечения работы witness и не требует больших затрат на его поддержку. Так же размещение в Azure избавляет от необходимости третьего сайта при конфигурации Stretched Cluster и решения по его аварийному восстановлению.

Cloud Witness может применяться в следующих сценариях:
- Для обеспечения DR кластера, размещенного в разных сайтах (multi-site).
- Кластеры без общего хранилища (Exchange DAG, SQL Always-On и другие).
- Гостевые кластеры, выполняющиеся как в Azure, так и в on-premises.
- Кластеры хранения данных с или без общего хранилища (SOFS).
- Кластеры в рамках рабочей группы или разных доменах (новая функциональность WS2016).
-
Создайте новый Azure Storage Account (Locally-redundant storage) и в свойствах аккаунта скопируйте один из ключей доступа.


Для упрощения можно использовать PowerShell:

Workgroup and Multi-Domain Clusters
В Windows Server 2012 R2 и предыдущих версиях необходимо соблюдение глобального требования перед созданием кластера: узлы должны быть членами одного и того же домена. Active Directory Detached кластер, презентованный в 2012 R2, имеет подобное требование и не упрощает его существенным образом.
В Windows Server 2016 возможно создание кластера без привязки к AD в рамках рабочей группы или между узлами, являющиеся членами разных доменов. Процесс схож с созданием deattached -кластера в 2012 R2, но имеет некоторые особенности:
- Поддерживается только в рамках среды WS2016.
- Требуется роль Failover Clustering.

При появлении ошибки “Requested Registry access is not allowed” необходимо изменить значение политики LocalAccountTokenFilterPolicy.

Virtual Machine Load Balancing / Node Fairness
Динамическая оптимизация, доступная в VMM, частично перекочевала в Windows Server 2016 и предоставляет базовое распределение нагрузки на узлах в автоматическом режиме. Для перемещения ресурсов используется Live Migration и эвристики, на базе которых кластер каждые 30 минут решает проводить балансировку или нет:
- Текущий % использования памяти на узле.
- Средняя загрузка по CPU в 5 минутном интервале.
| AutoBalancerLevel | Агрессивность балансировки | Комментарий |
|---|---|---|
| 1 (по умолчанию) | Low | Осуществлять балансировку при загрузке узла более 80% по одной из эвристик |
| 2 | Medium | При загрузке более 70% |
| 3 | High | При загрузке более 60% |
Параметры балансировщика можно определить и в GUI (cluadmin.msc). По умолчанию, используется Low уровень агрессивности и режим постоянной балансировки.

Для проверки я использую следующие параметры:
AutoBalancerLevel: 2
AutoBalancerMode: 2
Имитируем нагрузку сначала по CPU (около 88%) и затем по RAM (77%). Т.к. определен средний уровень агрессивности при принятии решения о балансировке и наши значения по загрузке выше определенного значения (70%) виртуальные машины на загруженном узле должны переехать на свободный узел. Скрипт ожидает момент живой миграции и выводит затраченное время (от точки начала загрузки на узла до осуществления миграции ВМ).
В случае с большой нагрузкой по CPU балансировщик переместил более 1 ВМ, при нагрузке RAM – 1 ВМ была перемещена в рамках обозначенного 30 минутного интервала, в течение которого происходит проверка загрузки узлов и перенос ВМ на другие узлы для достижения <=70% использования ресурсов.

При использовании VMM встроенная балансировка на узлах автоматически отключается и заменяется на более рекомендуемый механизм балансировки на базе Dynamic Optimization, который позволяет расширенно настроить режим и интервал выполнения оптимизации.
Virtual machine start ordering
Изменение логики старта ВМ в рамках кластера в 2012 R2 строится на понятии приоритетов (low,medium,high), задача которых обеспечивать включение и доступность более важных ВМ перед запуском остальных «зависимых» ВМ. Обычно это требуется для multi-tier сервисов, построенных, к примеру, на базе Active Directory, SQL Server, IIS.
Для повышения функциональности и эффективности в Windows Server 2016 добавлена возможность определять зависимости между ВМ или группами ВМ для решения обеспечения корректного их старта, используя Set или наборы кластерных групп. Преимущественно нацелены на использование совместно с ВМ, но могут быть использованы и для других кластерных ролей.

Для примера используем следующий сценарий:
1 ВМ Clu-VM02 является приложением, зависимым от доступности Active Directory, выполняемой на вирт. машине Clu-VM01. А ВМ Clu-VM03, в свою очередь, зависит от доступности приложения, расположенного на ВМ Clu-VM02.
Создадим новый set, используя PowerShell:

ВМ с Active Directory:
PS C:\> New-ClusterGroupSet -Name AD -Group Clu-VM01
Name: AD
GroupNames:
ProviderNames: <>
StartupDelayTrigger: Delay
StartupCount: 4294967295
IsGlobal: False
StartupDelay: 20
Приложение:
New-ClusterGroupSet -Name Application -Group Clu-VM02
Зависимый сервис от приложения:
New-ClusterGroupSet -Name SubApp -Group Clu-VM03
Добавляем зависимости между set’ами:
Add-ClusterGroupSetDependency -Name Application -Provider AD
Add-ClusterGroupSetDependency -Name SubApp -Provider Application
В случае необходимости можно изменить параметры set’а, используя Set-ClusterGroupSet. Пример:
StartupDelayTrigger определяет действие, которое необходимо произвести после старта группы:
- Delay – ожидать 20 секунд (по умолчанию). Используется совместно с StartupDelay.
- Online – ожидать состояния доступности группы в set.
isGlobal – определяет необходимость запуска set’а перед стартом других наборов кластерных групп (к примеру, set с группами ВМ Active Directory должен быть глобально доступен и, следовательно, стартовать раньше других коллекций).
Попробуем стартовать ВМ Clu-VM03:
Происходит ожидание доступности Active Directory на Clu-VM01 (StartupDelayTrigger – Delay, StartupDelay – 20 секунд)

После запуска Active Directory происходит запуск зависимого приложения на Clu-VM02 (StartupDelay применяется и на этом этапе).

И последним шагом является запуск самой ВМ Clu-VM03.

VM Compute/Storage Resiliency
В Windows Server 2016 появились новые режимы работы узлов и ВМ для повышения степени их устойчивости в сценариях проблемного взаимодействия между кластерными узлами и для предотвращения полной недоступности ресурсов за счет реакции на «малые» проблемы перед возникновением более глобальных (проактивное действие).
Режим изоляции (Isolated)
На узле HV01 внезапно стала недоступна служба кластеризации, т.е. у узла появляются проблемы интра-кластерного взаимодействия. При таком сценарии узел помещается в состояние Isolated (ResiliencyLevel) и временно исключается из кластера.

Виртуальные машины на изолированном узле продолжают выполняться* и переходят в статус Unmonitored (т.е. служба кластера не «заботится» о данных ВМ).

*При выполнении ВМ на SMB: статус Online и корректное выполнение (SMB не требует «кластерного удостоверения» для доступа). В случае с блочным типом хранилища ВМ уходят статус Paused Critical из-за недоступности Cluster Shared Volumes для изолированного узла.
Если узел в течение ResiliencyDefaultPeriod (по умолчанию 240 секунд) не вернет службу кластеризации в строй (в нашем случае), то он переместит узел в статус Down.
Режим карантина (Quarantined)
Предположим, что узел HV01 успешно вернул в рабочее состояние службу кластеризации, вышел из Isolated режим, но в течение часа ситуация повторилась 3 или более раза (QuarantineThreshold). При таком сценарии WSFC поместит узел в режим карантина (Quarantined) на дефолтные 2 часа (QuarantineDuration) и переместит ВМ данного узла на заведомо «здоровый».


При уверенности, что источник проблем был ликвидирован, можем ввести узел обратно в кластер:

Важно отметить, что в карантине одновременно могут находиться не более 25% узлов кластера.
Для кастомизации используйте вышеупомянутые параметры и cmdlet Get-Cluster:
Storage Resiliency
В предыдущих версиях Windows Server отработка недоступности r/w операций для вирт. диска (потеря соединения с хранилищем) примитивная – ВМ выключаются и требуется cold boot на последующем старте. В Windows Server 2016 при возникновении подобных проблем ВМ переходит в статус Paused-Critical (AutomaticCriticalErrorAction), предварительно «заморозив» своё рабочее состояние (её недоступность сохранится, но неожиданного выключения не будет).
При восстановлении подключения в течение таймаута (AutomaticCriticalErrorActionTimeout, 30 минут по умолчанию), ВМ выходит из paused-critical и становится доступной с той «точки», когда проблема была идентифицирована (аналогия – pause/play).
Если таймаут будет достигнут раньше возвращения хранилища в строй, то произойдет выключение ВМ (действие turn off)

Site-Aware/Stretched Clusters и Storage Replica
Тема, заслуживающая отдельного поста, но постараемся кратко познакомиться уже сейчас.
Ранее нам советовали сторонние решения (много $) для создания полноценных распределенных кластеров (обеспечение SAN-to-SAN репликации). С появлением Windows Server 2016 сократить бюджет в разы и повысить унификацию при построении подобных систем становится действительностью.
Storage Replica позволяет осуществлять синхронную (!) и асинхронную репликацию между любыми системами хранения (включая Storage Spaces Direct) и поддерживающая любые рабочие нагрузки, — лежит основе multi-site кластеров или полноценного DR -решения. SR доступна только в редакции Datacenter и может применяться в следующих сценариях:
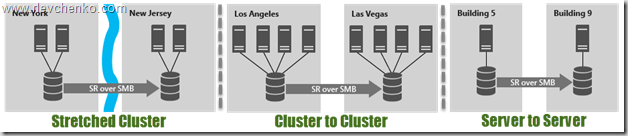
Использование SR в рамках распределенного кластера особенно ещё наличием автоматической отработки по отказу и тесной работы с site-awareness, который был презентован так же в Windows Server 2016. Site-Awarieness позволяет определять группы узлов кластера и привязывать их к физическому месторасположению (site fault domain/сайт) для формирования кастомных политик отказа (failover), размещения данных Storage Spaces Direct и логики распределения VM. Кроме того, возможна привязка не только на уровне сайтов, но и на более низкие уровни (node, rack, chassis).
Кластер для отказоустойчивости
Меня зовут Денис Рожков, я работаю в компании «Газинформсервис». Участвую в проекте по разработке СУБД Jatoba. Мы делаем свою реализацию СУБД на основе PostgreSQL – форк с необходимыми нам расширениями.
СУБД Jatoba появилась в результате нашего многолетнего опыта по внедрению проектов на другом программном обеспечении – у нас есть опыт работы не только с PostgreSQL и MS SQL, но и с Oracle, как с большой корпоративной СУБД, которая долгое время являлась стандартом.
PostgreSQL, как тренд последних лет, затронул нас настолько сильно, что мы начали разрабатывать на его основе свою СУБД. Мы не просто конфигурируем продукт на уровне пользователей, но и ковыряемся внутри, разрабатываем СУБД на уровне ядра и дописываем функциональность, которая нам нужна, на языке C.
Наша компания разрабатывает разные продукты, где СУБД используется как хранилище, и мы успешно реализовали ряд задач по миграции больших проектов с иностранных СУБД на PostgreSQL и отечественные СУБД. Поэтому опыт миграции у нас большой – это уже многолетняя история.
Сначала будет теория – мы вспомним и обобщим знания по кластеризации, проговорим, что мы должны знать о кластерах при выборе реализации для того или иного решения.
Поговорим о том, какие технические решения уже есть для PostgreSQL, чтобы не изобретать велосипед и не делать то, что сделал уже кто-то другой.
Расскажу о паре граблей, с которыми можно столкнуться в процессе настройки.
Сосредоточимся на вопросе повышения доступности СУБД
Что касается отказоустойчивости, то этот вопрос очень широкий и глубокий, поэтому с самого начало надо разделить:
есть High Availability – высокая доступность;
и есть Disaster Recovery – как восстановить систему в случае сбоев. Сюда входят бэкапы, регламенты восстановления и т.д. – это более широкий термин, чем высокая доступность.
Мы сегодня не будем говорить про disaster recovery, мы обсудим только первый раздел – High Availability.
С точки зрения высокой доступности мы сосредоточимся на аспекте СУБД. Пробежимся по верхам и попробуем обобщить, вспомнить, что можно использовать для повышения доступности, и какие есть нюансы.
Виды кластеров
Начнем с того, что такое кластер и зачем он нужен?
Сейчас вопрос создания кластера для отказоустойчивости не так актуален, как 10 лет назад. Сейчас и железо уже стало мощнее и серьезнее, и внутренние реализации отказоустойчивости другие, и системы виртуализации присутствуют почти везде – механизмов обеспечения разного рода отказоустойчивости достаточное количество.
Так или иначе, кластер – это разновидность параллельной или распределенной системы, которая состоит из нескольких связанных между собой компьютеров. Эти компьютеры должны использоваться вместе, как единый ресурс – именно это может сделать группу компьютеров кластером.
Сами кластеры бывают разные:
отказоустойчивые кластеры – это и есть кластеры высокой доступности (High-availability clusters, HA, кластеры высокой доступности);
кластеры с балансировкой нагрузки, которые в зависимости от настроек умеют распределять входящую нагрузку (входящих клиентов) на определенные сервера (Load balancing clusters);
вычислительные кластеры (High performance computing clusters, HPC);
системы распределенных вычислений.
Два последних раздела нашей темы совсем не касаются, но в стандартной классификации они присутствуют.
Типы отказоустойчивых кластеров
Есть три варианта обеспечения отказоустойчивости, три типа отказоустойчивых кластеров:
с холодным резервом или активный/пассивный (master\slave). Активный узел выполняет запросы, а пассивный ждет его отказа и включается в работу, когда таковой произойдет. Пример – резервные сетевые соединения, в частности, алгоритм связующего дерева. Например, связка DRBD и HeartBeat /Corosync. Хотя многие говорят, что это не про отказоустойчивость, но это самый распространенный вариант. Если у вас все правильно настроено, именно master\slave-конфигурация позволяет с минимальным простоем продолжить обслуживание клиентов.
с горячим резервом или активный/активный (master\master) – когда все сервера работают в системе равнозначно, все узлы выполняют запросы, в случае отказа одного нагрузка перераспределяется между оставшимися. То есть кластер распределения нагрузки с поддержкой перераспределения запросов при отказе. Примеры – практически все кластерные технологии, например, Microsoft Cluster Server или OpenSource-проект OpenMosix. Эта конфигурация имеет свои плюсы и свои минусы, для некоторых инсталляций СУБД она вообще недоступна. Но такой вариант резервирования существует, и я потом расскажу, где конкретно в PostgreSQL его можно встретить и увидеть.
с модульной избыточностью, когда мы спускаемся на уровень RAID или реализуем избыточность на аппаратном уровне. Применяется в случае, когда простаивание системы недопустимо. Все узлы одновременно выполняют один и тот же запрос (либо части его, но так, что результат достижим и при отказе любого узла), из результатов берется любой. Необходимо гарантировать, что результаты разных узлов всегда будут одинаковы (либо различия гарантированно не повлияют на дальнейшую работу). Примеры – RAID и Triple modular redundancy. К самой СУБД это имеет опосредованное отношение, но такой вид классификации среди типов кластеров присутствует.
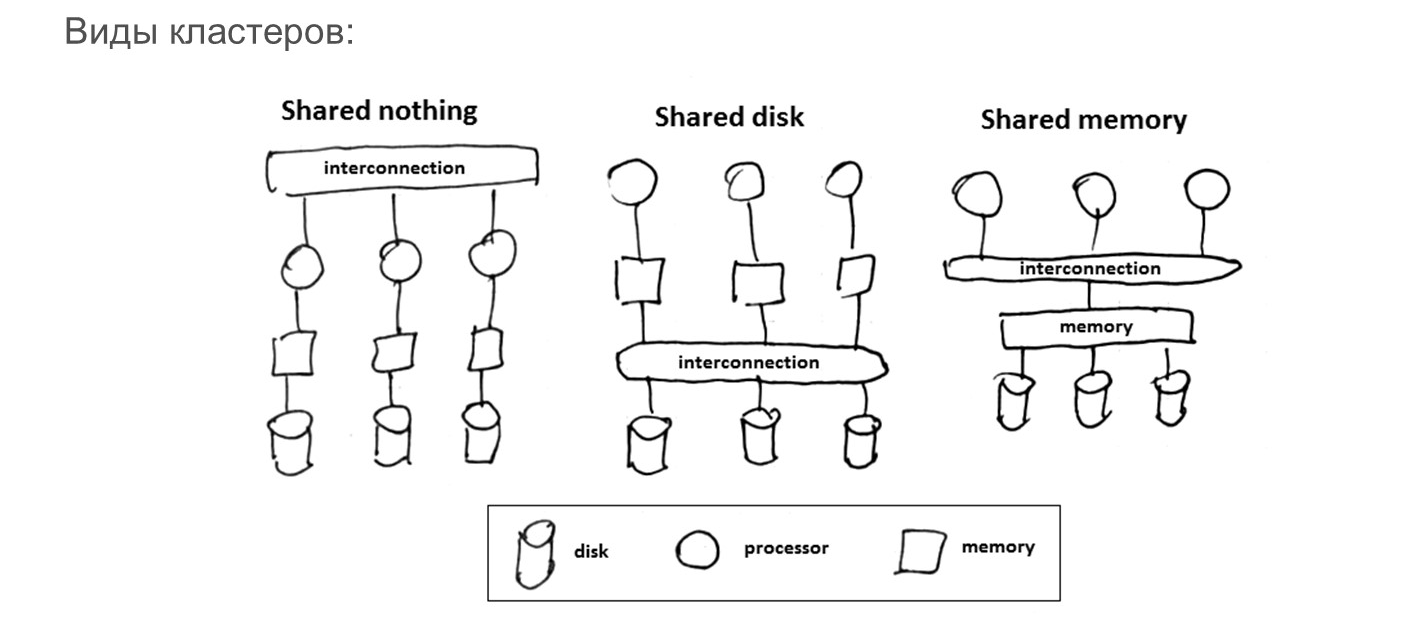
И последний теоретический момент, который нужно упомянуть – в разных семействах СУБД есть принципиальные различия в реализации определенных видов кластеров по распределению и использованию ресурсов.
Shared nothing – конфигурация, в которой когда каждый из серверов работает сам по себе, у каждого сервера есть собственный дисковый ресурс, где он автономно ведет все, что ему нужно. Серверы между собой ничего не делят, но они умеют между собой по определенной схеме взаимодействовать, передавая друг другу информацию и таким образом поддерживают консистентность.
Shared disk – конфигурация, когда несколько узлов могут работать с одним диском и умеют консистентно сопровождать данные на этом диске.
Shared memory – конфигурация, в которой можно шарить память и процессоры. Это не очень актуально в MS SQL и PostgreSQL, но в общей классификации этот вариант кластера тоже присутствует.
Таким образом, есть системы с разделением и неразделением ресурсов, когда ресурс (в частности, дисковая подсистема) используется на каждом сервере автономно или неавтономно.
Механизмы кластеризации в MS SQL Server
Я не буду проводить параллели, не буду устраивать битву MS SQL и PostgreSQL – я сначала напомню, какие механизмы кластеризации есть в Microsoft SQL Server и потом будем подробнее говорить про PostgreSQL.
Так или иначе, в ходе доклада мы рассмотрим обе эти системы с точки зрения основных аспектов. А параллели вы сами сможете провести. И в конце мы попробуем это обобщить.
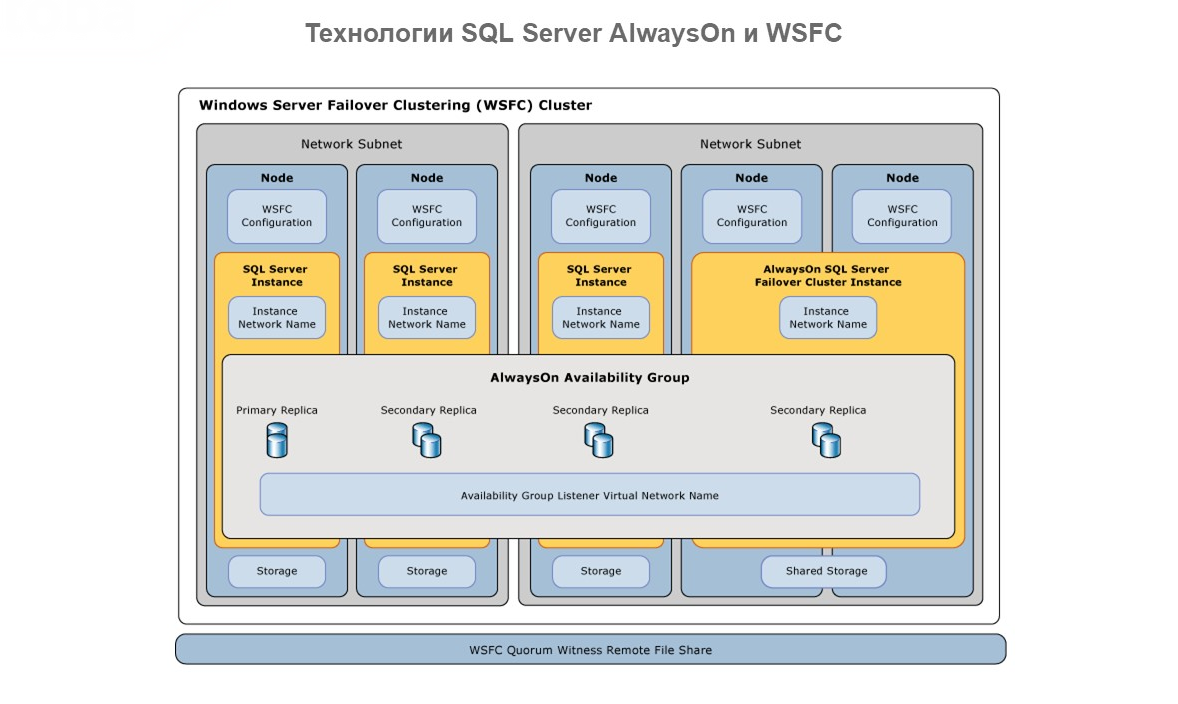
Напомню, что основные механизмы обеспечения отказоустойчивости в кластере СУБД MS SQL – это Microsoft Windows Server Failover Clustering (WSFC) и технология AlwaysOn.
Технология AlwaysOn представляет собой интегрированное непосредственно в операционную систему гибкое решение, которое обеспечивает высокий уровень доступности и аварийного восстановления.
AlwaysOn поддерживает три основных режима доступности:
Последний режим нам совсем не интересен, потому что в нем не фигурируют данные, но асинхронная и синхронная фиксация – это про нас.
Здесь нужно понять принципиальный нюанс в реализации кластеризации: чем эти два режима отличаются между собой – причем, они примерно одинаково отличаются как в семействе MS SQL, так и в PostgreSQL.
Asynchronous-commit mode (асинхронная фиксация) – это режим, когда первичная реплика фиксирует транзакции, не ожидая подтверждения того, что вторичная реплика записала журнал на диск. При этом каждая вторичная реплика работает в режиме асинхронной фиксации – ей передается информация, и уже неважно, что происходит дальше. Вместо ожидания запись журнала сразу помещается в локальный файл первичной реплики, и клиенту отправляется подтверждение транзакции. Главное, записать данные к себе и вторично проинформировать второй сервер о том, что транзакция была выполнена. За счет этого первичная реплика минимизирует задержку транзакций в базах данных-получателях, но позволяет им не успевать за базами данных-источниками, что создает риск возможной потери данных.
Synchronous-commit mode (синхронная фиксация) – это режим, в котором прежде чем фиксировать транзакции, первичная реплика ждет, чтобы вторичная реплика подтвердила, что запись журнала на диск завершена. В этом режиме возникает ожидание, и тайминги завершения транзакций будут другими. Но после синхронизации базы данных-получателя с базой данных-источником зафиксированные транзакции будут полностью защищены.
С одной стороны, при асинхронной фиксации транзакции вы можете увеличить скорость, но с другой стороны, если у вас на реплике транзакция не была получена, то восстановить эти данные на реплике можно только в том случае, если у вас останутся журналы с основного сервера. Это и есть нюанс использования механизма асинхронной транзакции – его можно использовать для повышения скорости транзакций, но есть риски.
Поскольку 1С – это система с высокой ценностью информации, мы, с одной стороны, рекомендуем асинхронный режим, но с другой стороны, это зависит от нагрузки и того, насколько тайминги и лаги в целом влияют на механизм работы.
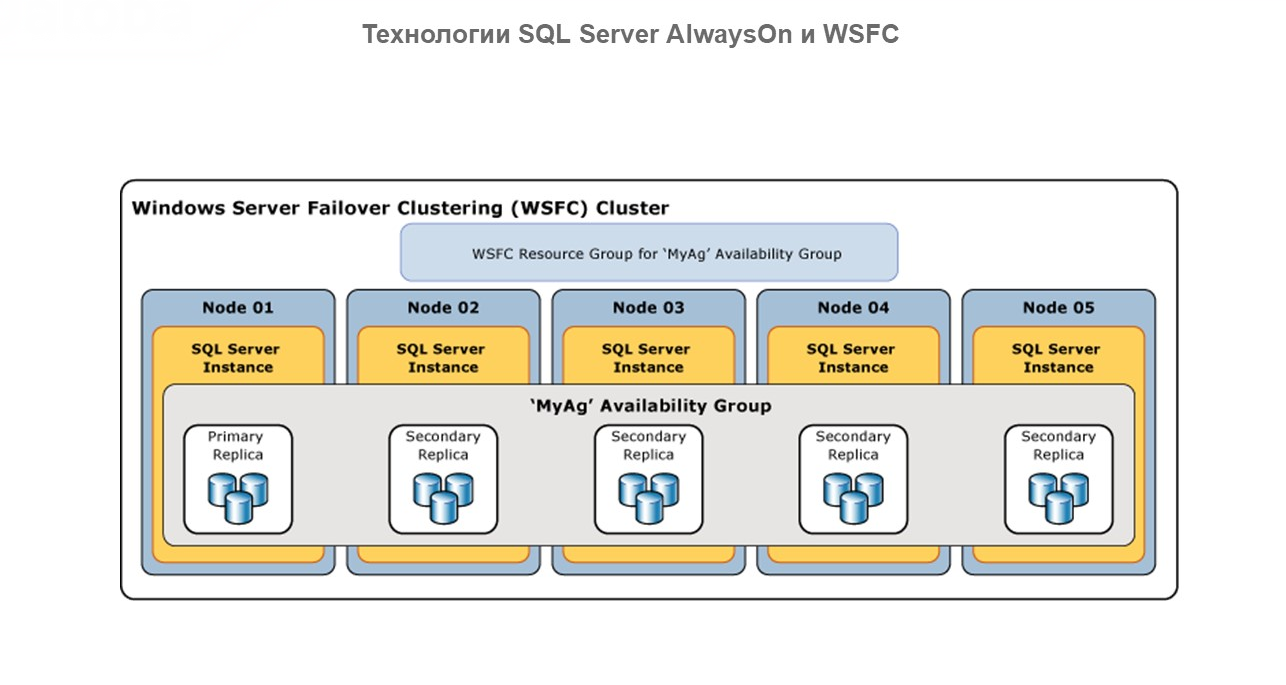
При масштабировании кластера на несколько узлов у нас есть понятие «Группа доступности» – это группа баз данных, для которых отработка отказа выполняется одновременно.
Группу доступности для чтения можно использовать для масштабирования нагрузки. В этом режиме наши реплики работают на read-only, снижая нагрузку с основной мастер-базы, позволяя распределять клиентов на вторичные базы. При этом основной первичный узел – единственный, кто работает read/write.
Здесь вопрос отказоустойчивости вторичен, потому что мы работаем для распределения нагрузки.
Нюансы при реализации кластера отказоустойчивости в MS SQL Server
Еще раз обобщим основные нюансы, которые нужно помнить при реализации кластера отказоустойчивости в SQL Server.
Режим доступности – свойство каждой реплики. Он определяет, ждет ли первичная реплика перед фиксацией транзакции, чтобы данные на вторичной реплике записались в журнал транзакции на диск.
Группы доступности AlwaysOn поддерживают два режима: режим синхронной и асинхронной фиксации.
В этих двух режимах доступности есть следующие ограничения:
При асинхронной фиксации транзакции переход на другой ресурс возможен только вручную. Причем здесь может возникнуть потеря данных – из-за того, что основной сервер не успел сообщить какую-то информацию резервному.
В синхронном commit mode переход на другой ресурс возможен как вручную, так и автоматически. При этом вы получите практически идентичный набор данных. Потеря данных здесь практически невозможна, хотя из-за некоторых технических нюансов могут быть некоторые потери транзакции на резервных серверах.
Важно, что экземпляры отказоустойчивого кластера MS SQL Server не поддерживают автоматический переход на другой ресурс с учетом групп доступности, поэтому любая реплика доступности, размещенная в них, должна быть настроена для перехода на другой ресурс вручную.
Механизмы кластеризации в PostgreSQL
В PostgreSQL зоопарк решений для кластеризации гораздо больше – сначала мы проговорим технические нюансы, а в конце обобщим, какие решения у нас есть.
Логическая репликация
В PostgreSQL есть логическая и физическая репликации.
Начнем с логической репликации.
Плюсы логической репликации:
Логическая репликация умеет копировать данные между разными версиями и архитектурами PostgreSQL. Ее можно использовать в случае, когда у вас в рамках одного комплекса используются разные версии Postgres, и вы хотите постепенно сделать апгрейд. В таких случаях логическая репликация позволяет постепенно обновлять версии и дойти до нужной.
Можно реплицировать не всю СУБД, а только отдельные объекты, которые вас интересуют. Например, иногда журналирование и какая-то отладочная информация являются для системы избыточными, их можно не реплицировать. В этих случаях вы можете ограничить логическую репликацию только теми объектами, которые вас интересуют.
Так как 1С генерирует в СУБД много динамических объектов, то логическая репликация с точки зрения 1С менее актуальна, чем физическая репликация, которая также присутствует для PostgreSQL.
Минусы логической репликации:
Практически невозможно реализовать синхронную репликацию, потому что двухфазный коммит на уровне логики триггеров затруднителен.
Также это решение дает дополнительную нагрузку на ЦПУ, поэтому если вы используете логическую репликацию, будьте готовы, что производительность ваших серверов еще больше просядет.
Из существующих решений по логической репликации можно отметить: Pglogical, Slony и менее известные – Londiste (Skytools) и Bucardo.
Физическая репликация
Физическая репликация в семействе Postgres используется более активно. Основные плюсы:
Минимальные накладные расходы на использование ресурсов.
Легко настраивать и сопровождать, но все относительно. Иногда для разработчиков СУБД легкая настройка – это час работы, а для разработчиков прикладных систем это конфигурирование – ад. Но относительно логической репликации здесь явно будет меньше времени потрачено.
Минусы этого решения:
все слейв-Standby-сервера будут работать в режиме только на чтение. Если у вас есть необходимость использовать конфигурацию с двумя read/write, то это уже другая технология.
Не могут работать с разными версиями и архитектурами по оборудованию, по умолчанию надо предполагать, что все сервера должны быть в одной версии. Они могут быть в разных минорных версиях, но мажорные версии точно должны совпадать, иначе не сможет работать.
Вы не сможете ограничиться отдельными объектами репликации: либо вся СУБД, либо ничего.
Схема физической репликации в PostgreSQL
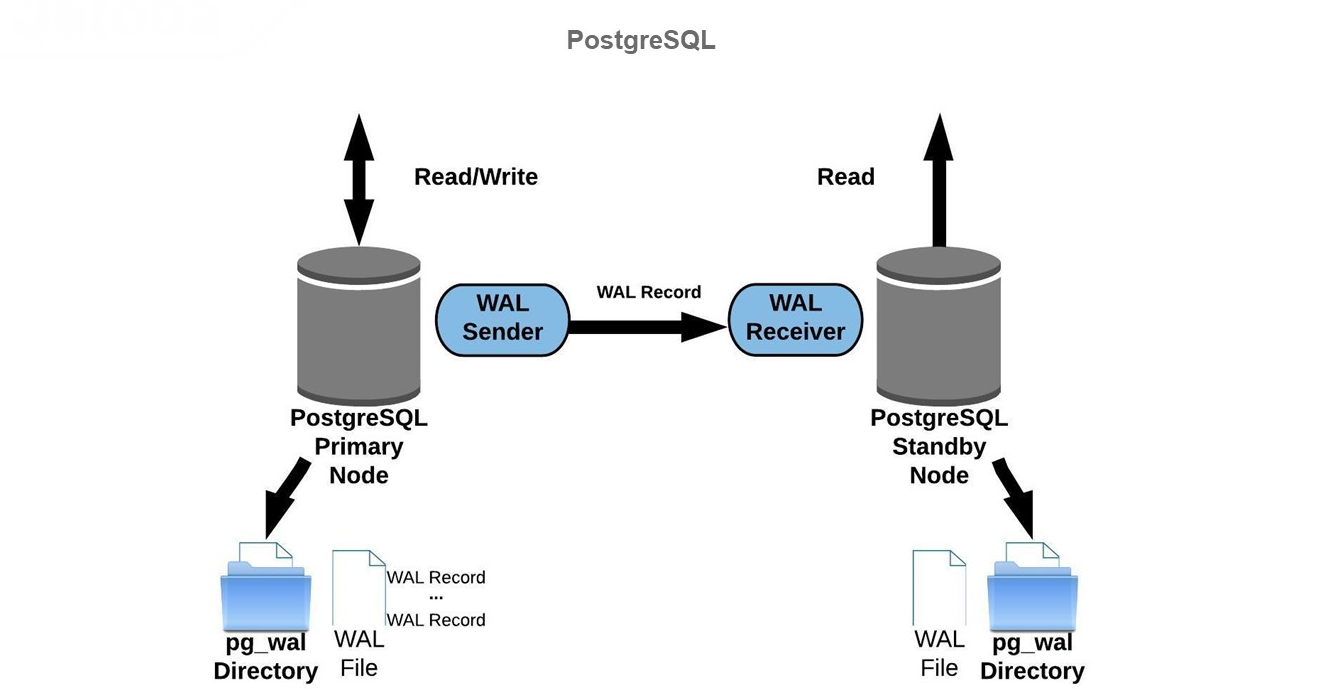
Почему присутствуют эти ограничения?
В PostgreSQL у нас есть основная Primary Node – мастер-база, которая работает на read/write. Она пишет журнал предзаписи – так называемые WAL-файлы, которые содержат информацию, позволяющую СУБД восстановиться, и несут в себе журнал транзакций. Благодаря этим WAL-файлам мы можем поддерживать в актуальном состоянии все остальные слейв-базы (Standby Node)/
Standby Node на PostgreSQL получают данные из WAL-файлов, обновляя свои данные на текущее состояние, тем самым проводя актуализацию.
Механизм похожий, он используется не только в PostgreSQL, но здесь он оперирует только журналами предзаписи (WAL-файлами).
В PostgreSQL надо помнить, что запись попадает в журнал предзаписи, а затем в файл данных. Это позволяет обеспечить консистентность и целостность.
Варианты репликации PostgreSQL
В PostgreSQL есть следующие варианты репликации:
синхронная и асинхронная репликация;
One-directional и Bi-directional.
Bi-directional в PostgreSQL – это вариант кластеризации с горячим резервом master/master. Это немногим известно, технология не так широко распространена. Для этого есть свои причины, но так или иначе она существует.
Синхронная и асинхронная репликации знакомы почти всем.
Каскадная репликация – это когда вы с одной реплики можете сделать еще одну и так далее. Часто на мастер в высоконагруженных системах нельзя подключать несколько слейвов, которые могут вам позволить обслуживать нагрузку read-only, потому что от канал мастер-базы к многим слейвам будет перегружаться из-за дублирования передачи информации для каждого слейва.
Поэтому иногда в высоконагруженных системах целесообразно сделать первый слейв, а с него – что-то другое. Здесь есть определенные задержки при передаче и актуализации информации, надо это понимать и помнить, слейв со слейва не будет так же актуален, как первый слейв, но это позволяет разгружать каналы и основной мастер, потому что факт передачи нагружает не только каналы, но и другие ресурсы – выделение памяти и т.д., что негативно влияет на работу продуктива.
Создание кластера master/slave на PostgreSQL
Что делать в семействе баз данных PostgreSQL, чтобы получить конфигурацию master/slave – кластер, который может использоваться для отказоустойчивости.
В первую очередь нужно сконфигурировать мастер – мы всегда начинаем с мастера, нельзя просто развернуть слейв и сконфигурировать все на слейве.
Для получения слейва вам нужно создать полную бэкап-копию текущего мастера. Это отдельная процедура, она на продуктиве всегда не очень приятна. В любом случае, вторым шагом после настройки мастера вам придется делать слейв-копию.
Потом эту слейв-standby-копию нужно доконфигуровать.
В результате правильной настройки, если вы запускаете слейв-базу, то процедура донаката WAL-файлов должна идти стандартно.
Вы это можете проверить, посмотрев стандартные вьюшки и выполнив некоторые мероприятия, которые я покажу чуть позже.
Конфигурация MASTER server
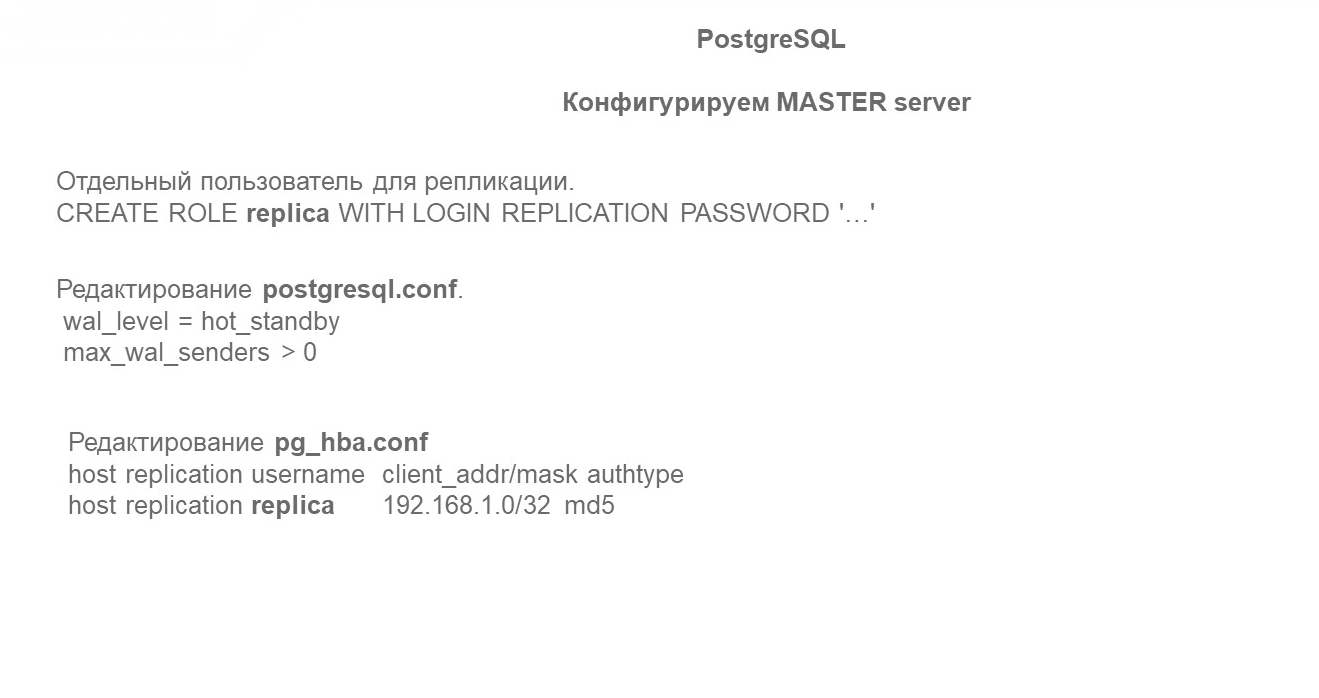
Для конфигурирования мастер-сервера в обязательном порядке нужно:
Создать отдельного пользователя с определенными параметрами аутентификации, чтобы передавать через него файлы на резервную копию. Это можно сделать запросом:
CREATE ROLE replica WITH LOGIN REPLICATION PASSWORD ‘…’;
Несмотря на то, что этот шаг я назвал обязательным, его можно не делать, можно использовать стандартного пользователя PostgreSQL. Но я считаю, что нужно вводить отдельную аутентификацию, делать отдельный пароль, потому что здесь идет речь о передаче между двумя СУБД. Чтобы контролировать этого пользователя, нужно настраивать параметры для его доступа отдельно, не используя внутреннего, предустановленного в PostgreSQL пользователя, который в СУБД всегда присутствует. Мои рекомендации – создавайте пользователя для конфигурирования резервных серверов.
В postgresql.conf указать необходимый уровень wal_level и количество процессов отправки max_wal_senders:
wal_level=hot_standby
max_wal_senders > 0
В pg_hba.conf указать параметры аутентификации для пользователя, которого мы отдельно создали, в формате:
host replication username client_addr/mask authtype
В качестве метода аутентификации лучше указать md5:
host replication replica 192.168.1.0/32 md5
Нельзя использовать метод аутентификации trust, хоть это и упрощает работу. Поскольку слейв-сервер – это второй сервер, для него будет сетевое взаимодействие, поэтому даже если серверы у вас в отдельном сегменте сети, все-таки целесообразно указывать отдельную аутентификацию.
Создание копии БД
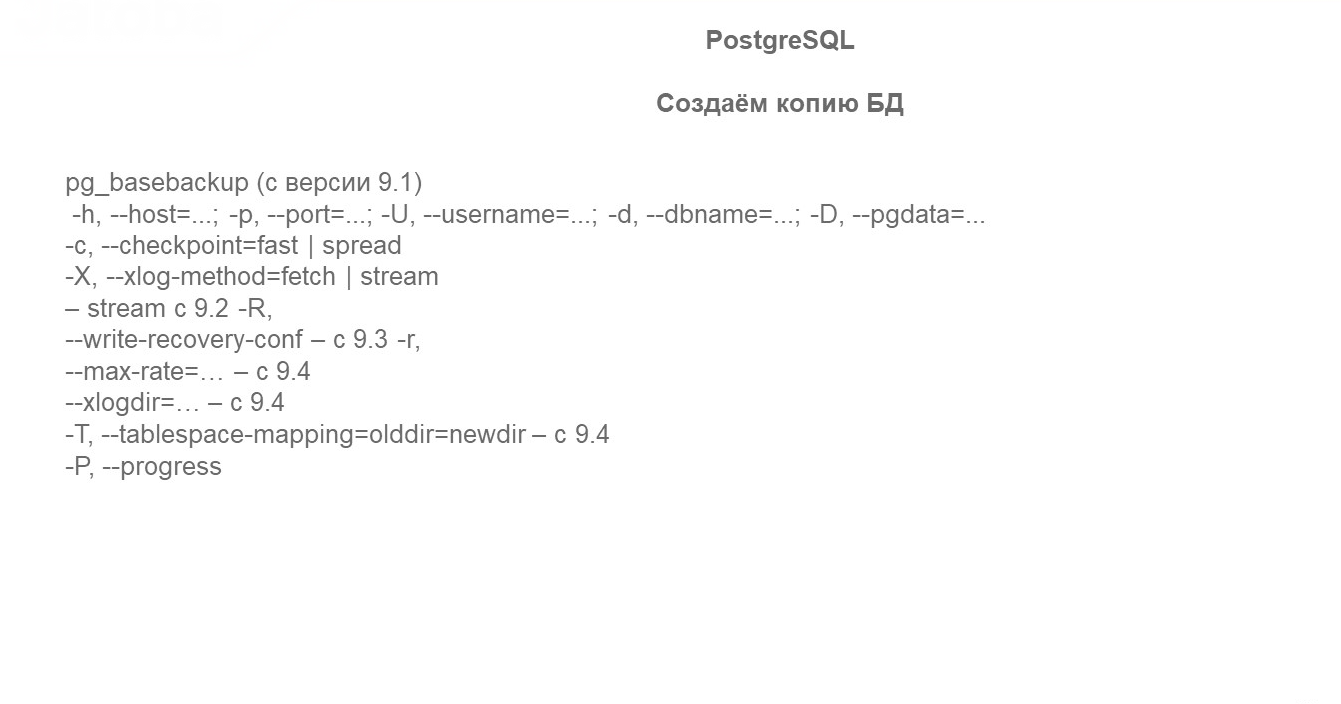
Для создания копии удобнее всего использовать утилиту pg_basebackup, потому что в нем есть возможность указывать скорость записи для передачи информации через параметр —max-rate, что позволяет не забивать канал при создании реплики.
Использование этой утилиты сводится к тому, что вы в определенный момент вводите нужные параметры и ждете, когда же у вас на резервном сервере создается полная копия на момент начала создания бэкапа.
Но в продуктиве выполнение этой операции трудоемко и занимает много часов – у нас были случаи, когда создание первого слейва занимало десятки часов. Поэтому сначала стоит подумать, как это можно оптимизировать.
Например, можно добавлять архивацию, можно использовать отдельное копирование самого файла и другие приемы – для этого могут быть полезны следующие утилиты из операционных систем Linux:
Lbzip2 – bzip2-сжатие, которое позволит архивировать в несколько потоков с использованием нескольких ядер, если нужно запаковать быстрее (аналоги: pbzip2, pigz);
Ionice – регулировка класса и приоритета для планировщика ввода-вывода (также можно использовать nice для регулировки приоритета процессов для CPU планировщика);
pv – контролируем объем передаваемых данных через pipe и т.о. используем для ограничения объема передаваемых данных в единицу времени (аналог — throttle);
tar – утилита архивирования, нужна для вспомогательных целей когда не используется сжатие bzip2/gzip;
tee – чтение с stdin c записью в stdout и другие файлы (является частью coreutils);
gpg – позволит обеспечить шифрование при передаче бэкапа на слейв-сервера.
Те, кто знаком с Linux, эти утилиты хорошо знают. В семействе Windows этот набор ограничивается, но можно найти и применить альтернативные решения – все зависит от того, в каком контексте вы хотите их использовать.
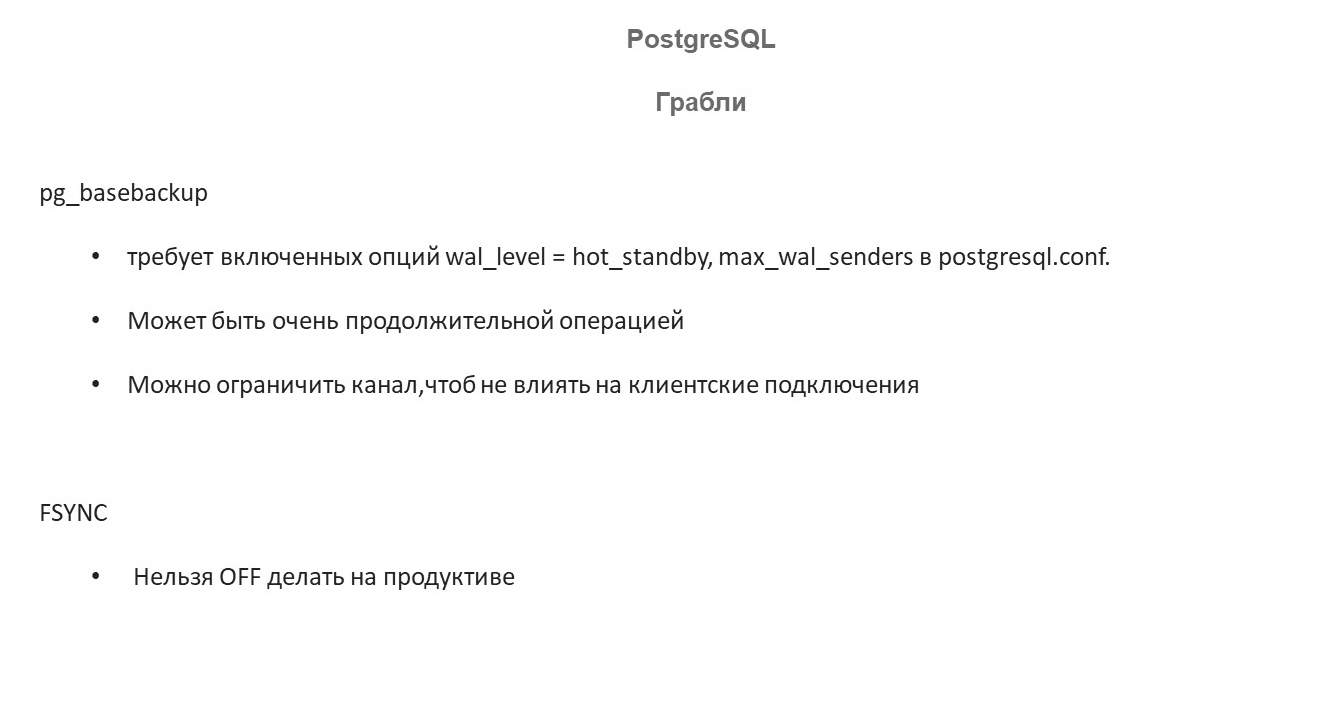
Грабли при использовании стандартной утилиты pg_basebackup.
Не забывайте включать в конфигурационном файле postgresql.conf параметры, о которых я рассказывал:
wal_level=hot_standby
max_wal_senders > 0
Операция создания бэкапа может быть очень продолжительной.
На больших базах помните, что клиенты работают на том же канале, что используется для создания резервной базы. Это может быть неочевидно, но помните об этом. Если есть возможность разносить на разные адаптеры – это замечательно, но тогда перед использованием настройте правильную маршрутизацию перед тем, как будете использовать. Или ограничьте скорость передачи через параметр —max-rate.
Ни в коем случае не ставьте в продуктиве на Linux для ускорения работы PostgreSQL в настройках fsync = off. Это известные грабли, которые не имеют отношения к pg_basebackup, но люди иногда меняют этот параметр, потом в продуктиве может возникнуть очень неприятная проблема, потому что консистентность базы в режиме бэкапа – отдельная история.
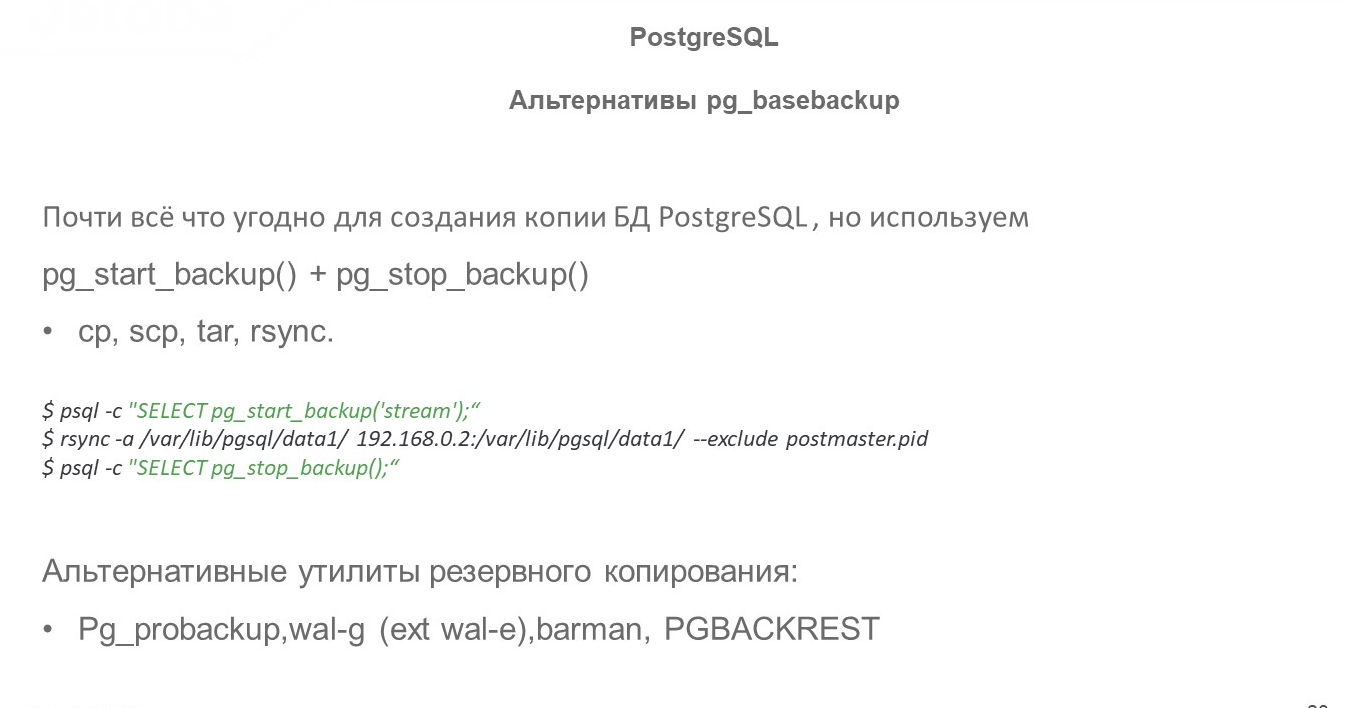
Все мы знаем, что pg_basebackup работает не особенно быстро. Ее плюс в том, что она входит в дистрибутив PostgreSQL и развивается одновременно с базой данных – все новшества, которые появляются в СУБД, также поддерживаются в pg_basebackup. По этой причине, она наиболее качественно протестирована для соответствия новым возможностям PostgreSQL. Но поскольку она уже не очень новая, отсюда ее минусы в производительности.
Для создания слейва и бэкапа можно использовать не только утилиту pg_basebackup, есть и совсем простой вариант:
затем перенести файлы на резервную копию на уровне ОС;
потом сделать pg_stop_backup();
и донакатить те WAL-файлы, которые были созданы в процессе.
Подчеркну, что вам просто нужно создать слейв-базу, каким образом вы это сделаете – это ваше решение.
Кроме утилиты pg_basebackup для создания бэкапов есть утилиты pg_probackup, wal-g (ext wal-e), barman, PGBACKREST.
Многие знают утилиту pg_probackup – ее поддерживают и выпускают наши отечественные коллеги из Postgres Professional.
Утилита wal-g сложнее, она умеет работать с облачными решениями – там другой технологический стек. Предшественником этой утилиты была утилита wal-e, ее развитие подхватили наши отечественные коллеги из Яндекса и сделали новое решение.
Есть еще PGBACKREST.
И есть barman – утилита со своим синтаксисом, плюсами и минусами.
Большинство из вновь созданных утилит поддерживают инкрементальный бэкап, иногда это тоже может понадобиться.
Как только вы начинаете работать с Postgre, вы понимаете, что pg_basebackup вас не устраивает, вам нужно что-то большее. Можете погуглить, поизучать альтернативные утилиты для бэкапов.
Донастройка STANDBY
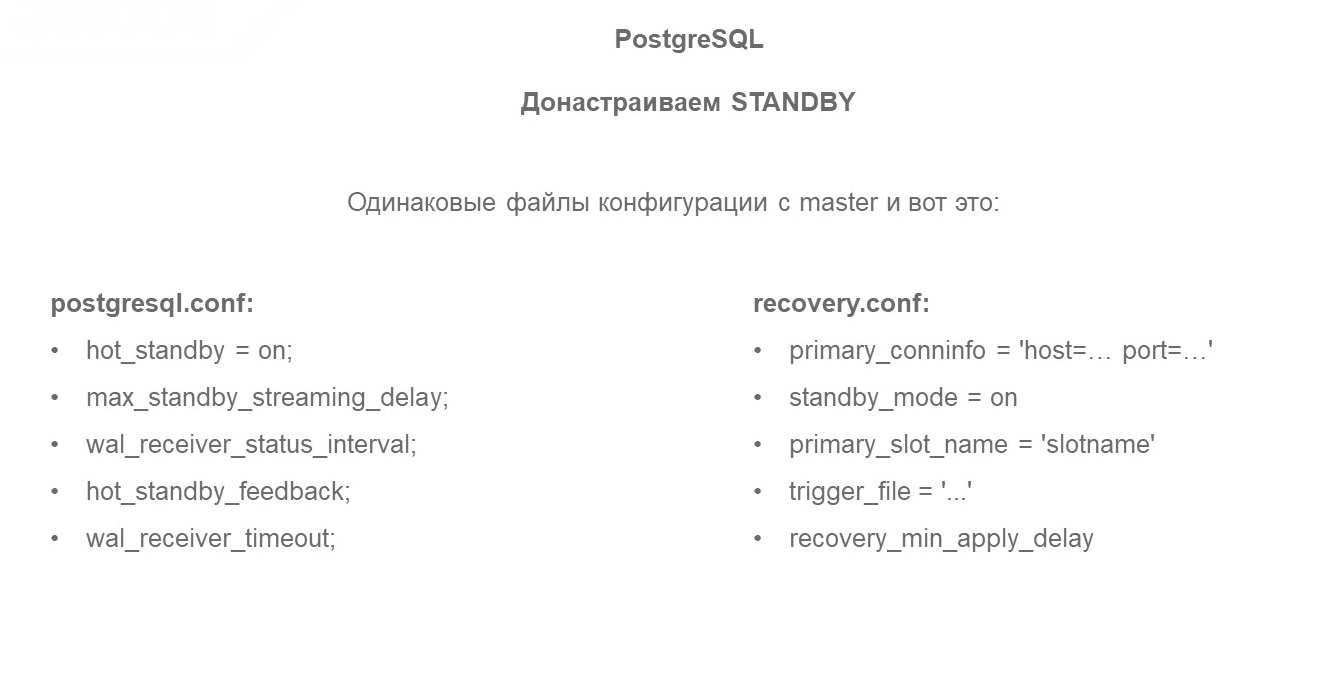
Последний этап – донастройка STANDBY-базы. Вам необходимо убедиться, что параметры конфигурирования в мастере и на слейве совпадают.
В мастере должно быть включено то, что показывает, что у вас есть стендбай сервер:
hot_standby = on
На слейве должен быть включен standby_mode:
standby_mode = on
Параметр wal_receiver_timeout влияет на то, через какой период времени база данных будет понимать, что таймаут для приема WAL-файлов уже истек.
В документации Postgre эти параметры хорошо расписаны, обязательные и самые интересные я указал на слайде.
Проверки
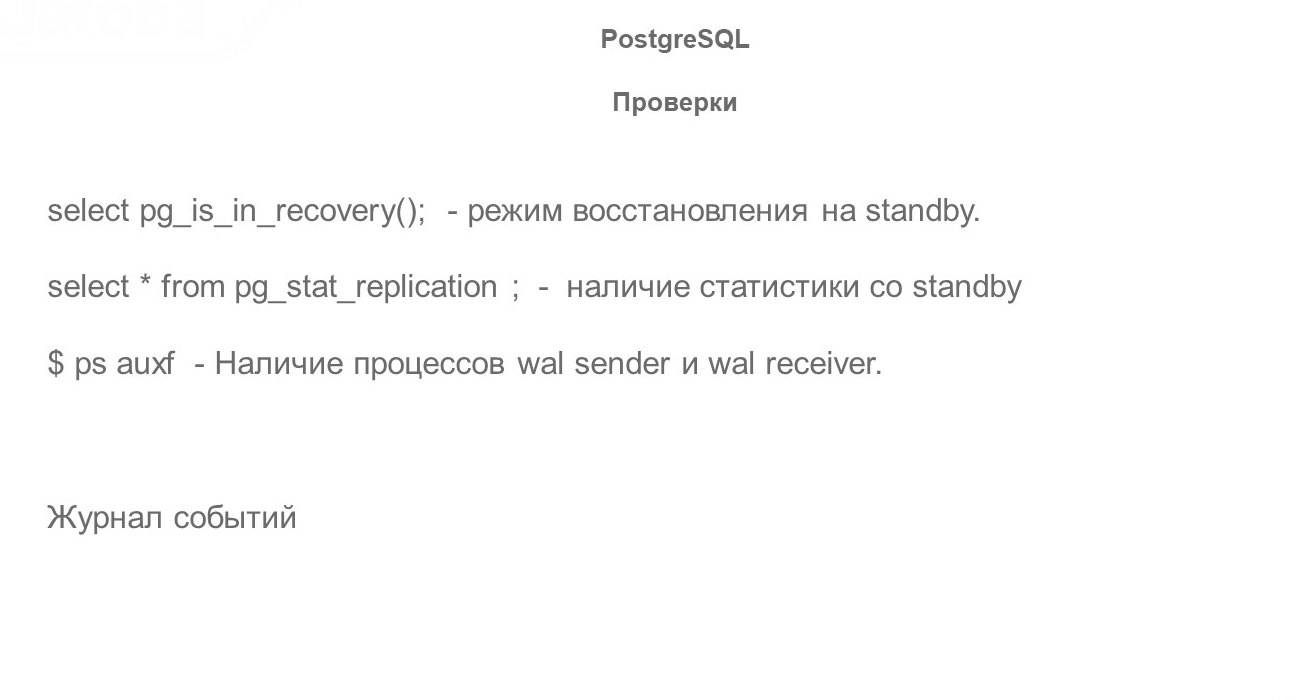
Как проверить, что слейв работает?
К сожалению, в PostgreSQL нет инструментов с графическим интерфейсом по определению состояния кластера, но вы можете выполнить команды в командной и посмотреть:
в том ли у вас режиме восстановления находится база:
select pg_is_in_recovery();
посмотреть статистику со standby через вьюху pg_stat_replication:
select * from pg_stat_replication ;
посмотреть наличие процессов wal sender и wal receiver в Linux – эти процессы должны присутствовать на мастере и слейве, чтобы обеспечить донакат WAL-файлов, о которых я говорил:
ps auxf
Это минимальный диагностический механизм, чтобы проверить, что слейв работает корректно.
В журнале событий можно увидеть ошибки, как при передаче, так и при получении – это тоже иногда полезно смотреть.
Как автоматизировать поднятие кластера
Все сложно, куча непонятных команд – зачем это знать и проверять руками? Неужели нет решений, которые обеспечат обычный FAILOVER, чтобы реализовывать стандартную отказоустойчивость – автоматически поднять резервную базу, чтобы она стала мастером. Не думать о том, что что-то случилось, чтобы клиенты в случае неполадок могли спокойно продолжать работу.
В коробочном решении PostgreSQL такого механизма переключения нет, но есть отдельные проекты, которые позволяет это реализовывать.
FAILOVER – это стандартная процедура, которая в PostgreSQL закрывается не одним и не двумя разными распространенными решениями, по которым мы сейчас пробежимся.
Большинство решений идут для Linux-like, поэтому проверяйте, работает ли это на Windows и сможете ли вы это использовать в своей инфраструктуре.
Ситуация со SPLITBRAIN также может быть неочевидной, может некорректно обрабатываться некоторыми утилитами, поэтому неплохо бы смотреть документацию, насколько там все хорошо проработано.
Давайте посмотрим, какие решения у нас присутствуют.
PGPOOL-II
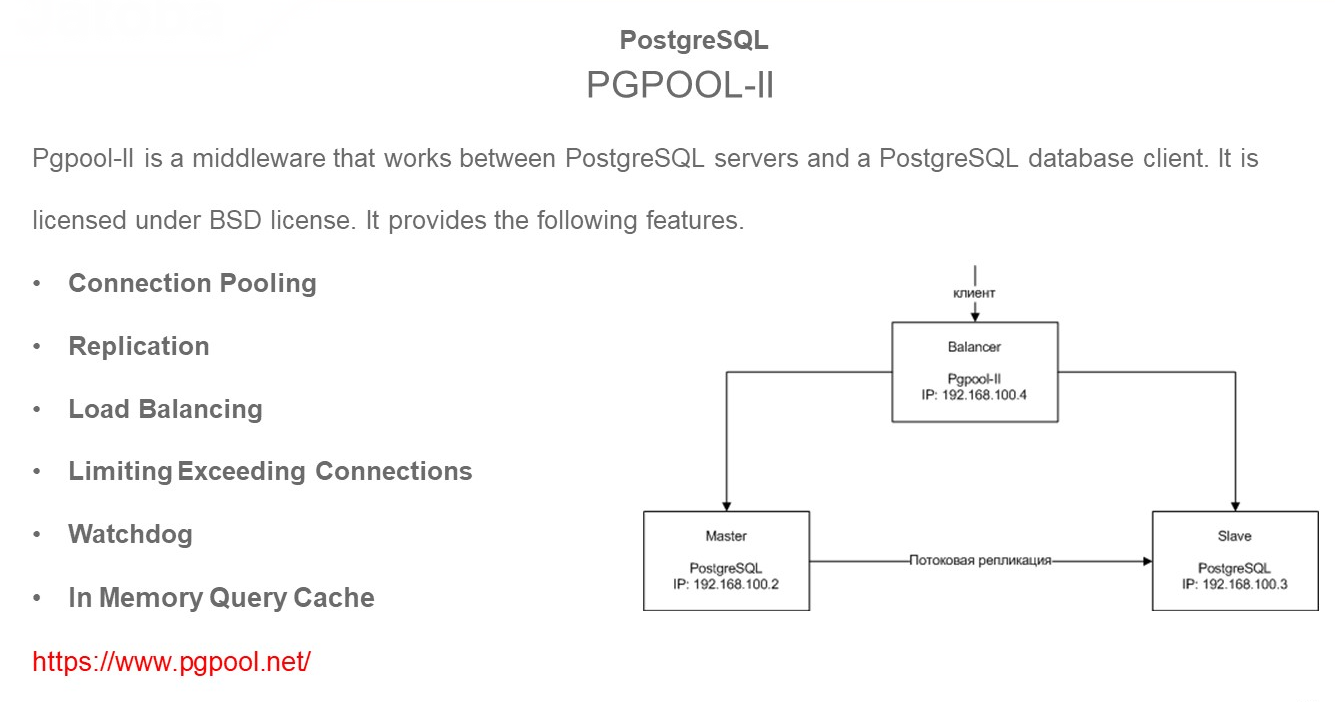
Начну не с самого очевидного и популярного – скажу про PGPOOL-II.
Это отдельная утилита, которая забирает на себя входящий трафик, и, контролируя сервера в кластере, определяет, куда этот трафик можно настраивать.
Этот инструмент может выполнять следующие роли:
Connection Pooling – забирать весь входящий трафик, при этом не контролируется количество соединений на СУБД.
Replication – он контролирует и помогает настраивать репликацию. То, что я вам рассказывал про команды создания вручную в PostgreSQL, он умеет настраивать сам и преднастроенные скрипты для выполнения у него есть.
Load Balancing – может выполнять балансировку нагрузки на read-only узлах. Если вы знаете, что для определенных отчетов определенные SQL-команды должны уходить на узлы read-only, можно в конфиг-файле настроить и использовать. Хотя для 1С это будет очень непросто, но такая функция у него есть.
Limiting Exceeding Connections – позволяет ограничивать использование памяти, предполагая использование кэша.
Это не простой FAILOVER. это утилита, которая позволяет работать с большим набором функций.
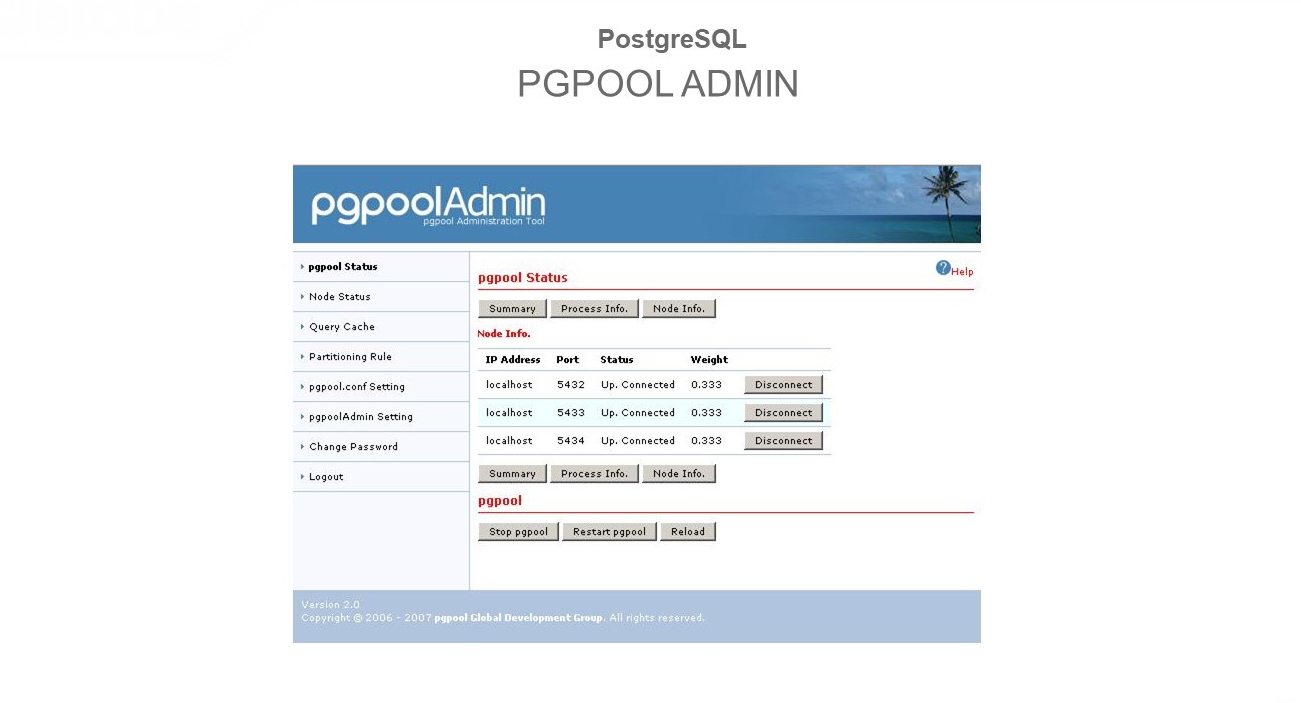
У утилиты PGPOOL-II есть отдельный, достаточно скромный интерфейс – это PGPOOL ADMIN.
Вы можете управлять этим решением кнопками и посмотреть, сколько серверов у вас есть. Подключиться, посмотреть статистику и т.д.
Даже если PGPOOL-II принимал автоматические решения, вы можете эти результаты тут увидеть.
Плюс администрировать ее здесь можете.
Patroni
Про Patroni сегодня в отдельном докладе рассказал Семен Трошкин.
Это отличное решение под Linux, которое строится на ZooKeeper, etcd и Consul. В Windows вам будет сложно его использовать.
Помните о том, что если вы делаете кластер, то Patroni вы можете использовать только тогда, когда у вас есть серверы на Linux.
CITUSDATA
Расширение для PostgreSQL Citus Data попало в мой доклад не потому, что это рекомендуемое решение для High Availability, а потому, что с его помощью можно построить на PostgreSQL хорошее горизонтальное масштабирование – распределить нагрузку между базами, используя шардирование.
Расширение Citusdata в поставку PostgreSQL для 1С не входит, но если вам нужно использовать шардирование и распределить нагрузку между разными базами, оставив их на read/write, то помните, что такое решение в семействе PostgreSQL есть.
Pgbouncer и HaProxy
Готовые решения под названием Pgbouncer и HaProxy нужны не для того, не для обеспечения отказоустойчивости и переключения FAILOVER. Эти решения нужны, чтобы распределять нагрузку и обеспечивать экономию ресурсов на серверах PostgreSQL в связи с тем, что каждый клиент PostgreSQL – это отдельный процесс с выделенными ресурсами на сервере PostgreSQL.
Если у вас много клиентов, на сервере это становится проблемой. Когда клиентов больше 1000, реально нужно экономить и взаимодействие между этими процессами становится проблемой для самой СУБД.
Поэтому, если в приложении нет стандартного пулинга, приходится думать, какой же пулинг использовать.
У нас есть опыт работы с Pgbouncer и HaProxy. HaProxy замечательно работает не только с СУБД – с его помощью можно также достаточно хорошо можно перенастраивать трафик на уровне TCP.
Но эти решения опять же можно использовать только в Linux, а вот в Windows они не работают. Мы даже пробовали их пересобрать, чтобы использовать на Windows, но это оказалось слишком сложно и остановились на другом решении.
Bi-Directional Replication
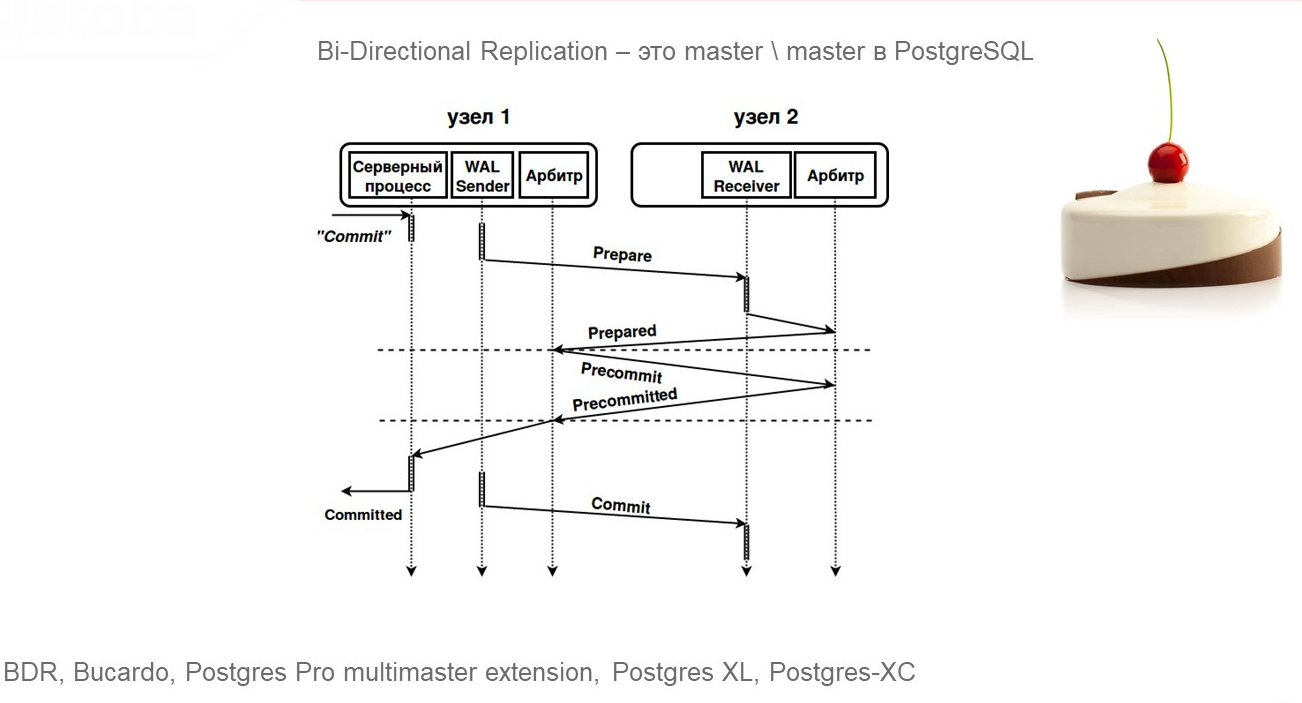
Bi-Directional Replication – интересная фича. Та самая функция, когда вы, выполняя одну транзакцию, можете убедиться, что она попала на резервный сервер.
Здесь идет использование двух-трех серверов в режиме read/write.
Выглядит это шикарно – когда у вас много серверов. они все работают на read/write, вы можете работать с любым из них.
Но здесь нужно помнить, что как и в MS SQL Server, здесь у вас будут задержки при синхронизации транзакции. Вам нужно подтвердить получение на резервном сервере, только после этого транзакция становится закоммиченной – это та многофазность транзакции, которая используется во всех решениях master/master.
В бесплатных версиях PostgreSQL поддержку Bi-Directional Replication вы можете найти только в очень древних версиях, которые вы не сможете использовать для 1С.
Но такая возможность есть в платных решениях отечественных производителей – Postgres Pro multimaster extension, Postgres XL, Postgres-XC.
В Bucardo такая возможность тоже есть. И иностранный вендор 2ndQuadrant в решении BDR тоже используют технологию Bi-Directional Replication для реализации кластерных серверов в режиме master/master.
Можно ли использовать эту технологию для серверов больше 3-5? Наш опыт показывает, что вряд ли. Мы использовали для двух серверов с хорошей нагрузкой. Лаг при подключении – минимальный, у вас будет работать практически два мастера. Но при этом будут действовать ограничения, которые есть на физической репликации.
По этой и некоторым другим причинам работоспособность этой технологии, на наш взгляд, под вопросом.
Jatoba
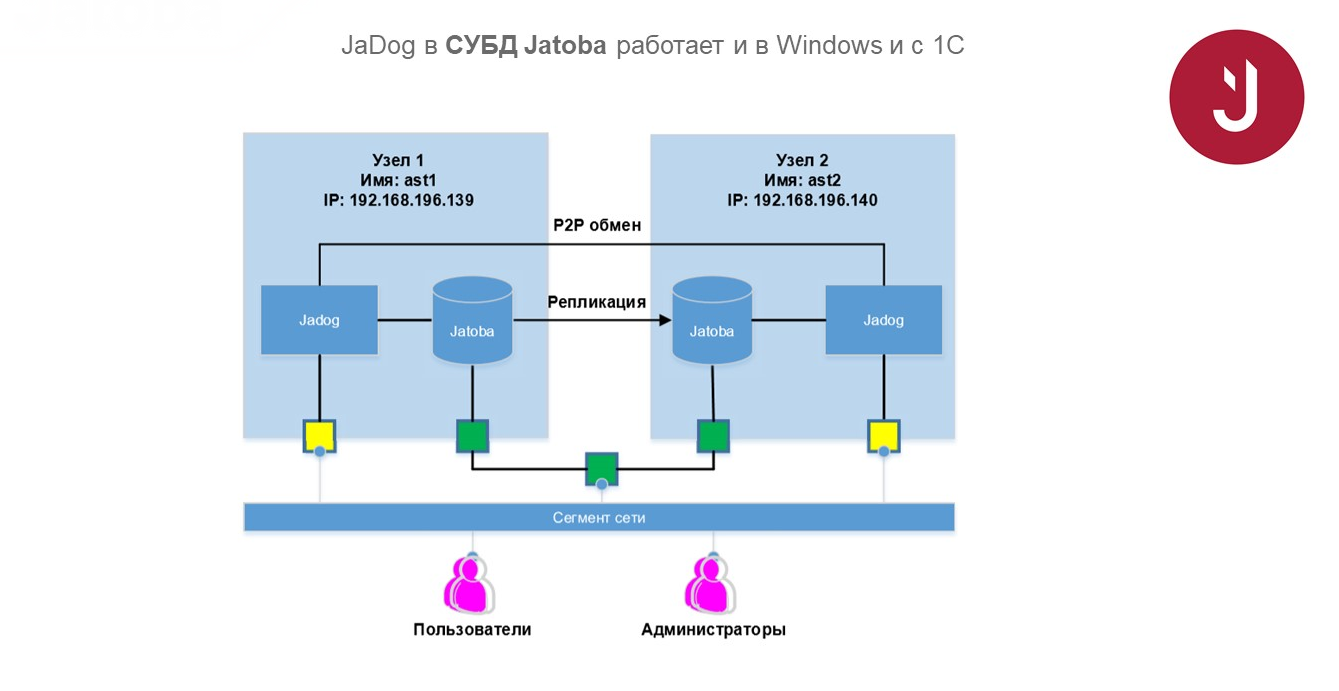
В СУБД Jatoba нами написан отдельный агент, обеспечивающий переключение нагрузки. Он контролирует, что с ним происходит, и автоматически принимает решение, куда переключиться.
Это позволяет избавить администратора от принятия решений вручную – наши утилиты делают это автоматически.
Возможность настроить PostgreSQL для работы с WSFC
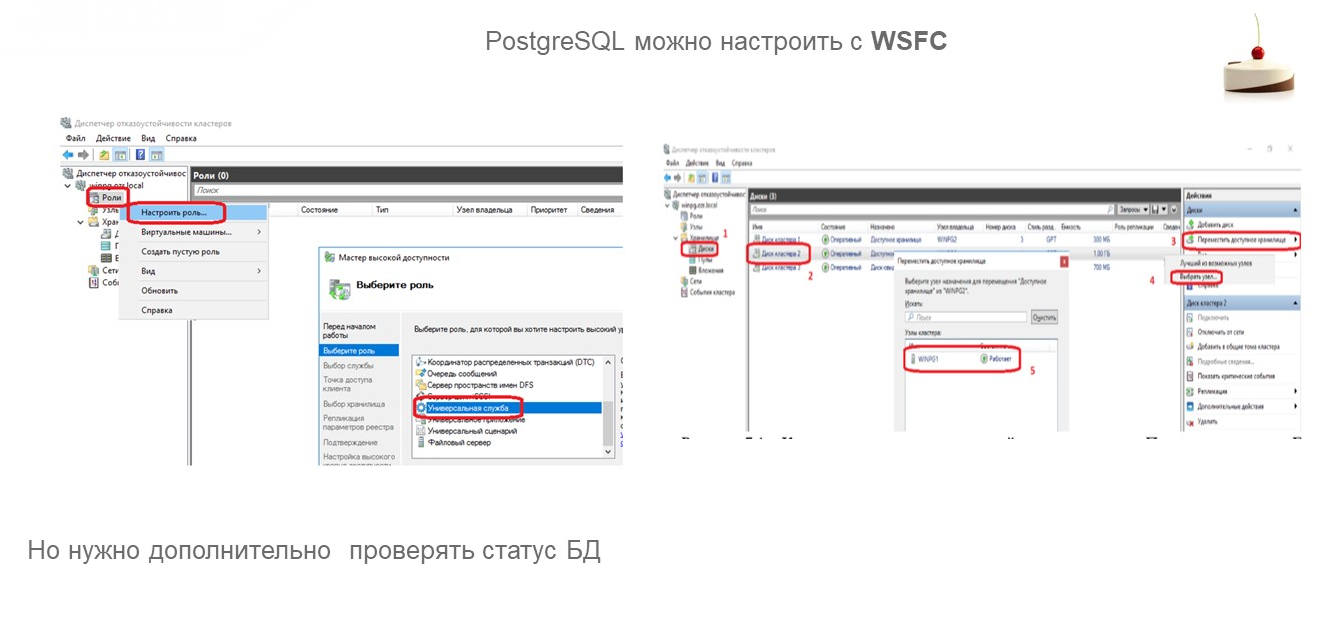
Можно ли на Windows PostgreSQL подключить к WSFC так же, как и MS SQL Server?
Да, вы можете в Windows добавить службу PostgreSQL Server так же, как обычную службу MS SQL Server.
Там есть нюанс, потому что автоматически статус подключения определяться не будет, плюс нужно будет запускать отдельные скрипты, которые будут пытаться подключиться к СУБД и активировать слейв, мастер – помогать кластеру WSFC принять решение о том, что пора мигрировать.
У нас такие скрипты есть. Если кого-то интересует, как это настроить – пишите в комментарии. Я скажу, каким образом настроить на Windows кластер WSFC с PostgreSQL любой конфигурации – даже с Postgres Pro Enterprise заработает.
Данная статья написана по итогам доклада (видео), прочитанного на онлайн-митапе "PostgreSQL VS Microsoft SQL".
Приглашаем 11-13 октября на Infostart Tech Event 2023 — самое масштабное событие в сфере 1С-индустрии, 1500+ участников, 130+ докладов.
Создание отказоустойчивого кластера высокой доступности на Windows.
Импортозамещение систем хранения данных! Акция! При покупке любой российской СХД Аэродиск — серверный шкаф в подарок. Количество ограничено!
Кластеры от компании Microsoft.
Несмотря на неоднозначное отношение к Microsoft необходимо отметить, что компания сделала высокие технологии доступными для простых пользователей. Так или иначе, но современное положение сферы информационных технологий не в последнюю очередь определено именно компанией Microsoft.
Далеко не всегда решения и продукты от компании Microsoft сразу занимали позиции на уровне специализированных решений, однако наиболее важные все равно постепенно выбивались в лидеры в соотношении цена/функциональность, а также по простоте внедрения. Одним из таких примеров являются кластеры.
Разработка вычислительных кластеров не является сильной стороной Microsoft. Об этом свидетельствует, в том числе, тот факт, что разработки компании не попали в список Top-500 суперкомпьютеров. Поэтому совершенно логично, что в линейке Windows Server 2012 отсутствует редакция HPC (High-performance computing –высокопроизводительные вычисления).
Кроме того, учитывая особенности высокопроизводительных вычислений, платформа Windows Azure кажется более перспективной. Поэтому компания Microsoft сосредоточила свое внимание на кластерах высокой доступности.
Кластеры в Windows.
Впервые поддержка кластеров была реализована компанией Microsoft еще в операционной системе в Windows NT 4 Server Enterprise Edition в виде технологии Microsoft Cluster Service (MSCS). В операционной системе Windows Server 2008 она превратилась в компонент Failover Clustering. По сути это кластеры с обработкой отказа или высокодоступные кластеры, хотя иногда их не вполне корректно называют отказоустойчивыми.
В общем случае при выходе из строя узла, к которому идет запрос, как раз и будет проявляться отказ в обслуживании, однако при этом произойдет автоматический перезапуск кластеризуемых сервисов на другом узле, и система будет приведена в состояние готовности в кратчайший срок.
Кластер высокой доступности на Windows включает в себя как минимум два узла с установленными операционными системами и соответствующими ролями. Узлы должны быть подключены к внешней сети и внутренней сети, необходимой для обмена служебными сообщениями, к общему хранилищу служебных ресурсов (например, диск-свидетель для кворума). Кроме того, в систему входят и данные кластеризуемых приложений. В ситуации, когда сервисы исполняются только на одном из узлов, реализуется схема Active-Passive, то есть сервисы выполняются на одном узле, а второй работает в дежурном режиме. Когда оба узла несут полезную нагрузку, реализуется схема Active-Active.
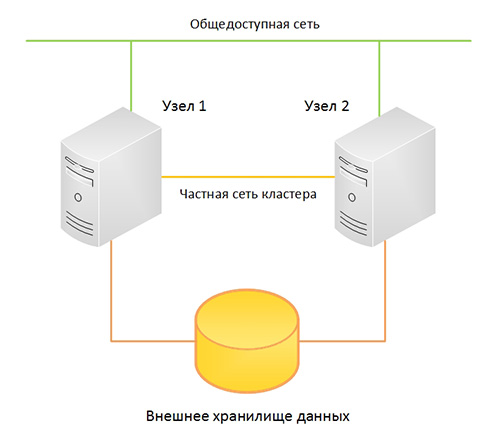
С момента первой реализации, поддержка кластеров в Windows существенно изменилась. Была реализована поддержка файловых и сетевых служб, позже SQL Server (в операционной системе Windows Server 2000), Exchange Server ( в Windows Server 2003), и другие стандартные службы и роли, включая Hyper-V (в операционной системе Windows Server 2008). Была улучшена масштабируемость (до 64 узлов в Windows Server 2012), список кластеризуемых сервисов был расширен.
Поддержка виртуализации, а также позиционирование Windows Server как облачной операционной системы, стали поводом для дальнейшего развития поддержки кластеров, поскольку высокая плотность вычислений предъявляет высокие требования к надежности и доступности инфраструктуры. Поэтому, начиная с операционной системы Windows Server 2008, именно в этой области сосредоточена основная масса усовершенствований.
В операционной системе Windows Server 2008 R2 реализованы общие тома кластера Hyper-V (CSV), позволяющие узлам одновременно обращаться к одной файловой системе NTFS. В результате несколько кластерных виртуальных машин могут использовать один адрес LUN и мигрировать с узла на узел независимо.
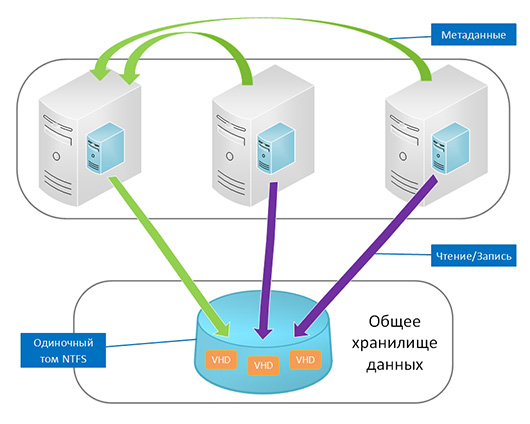
В Windows Server 2012 кластерная поддержка Hyper-V была усовершенствована. Была добавлена возможность управления на уровне целого кластера приоритетами виртуальных машин, определяющих порядок перераспределения памяти, восстановления вирутальных машин в случае выхода из строя узлов или запланированной массовой миграции. Были расширены возможности мониторинга – в случае сбоя контролируемой службы появилась возможность перезапуска не только самой службы, но и всей виртуальной машины. Есть возможность осуществления миграции на другой, менее загруженный узел. Реализованы и другие, не менее интересные нововведения, касающиеся кластеризации.
Кластеры в Windows Server 2012.
Сначала остановимся на нововведениях в базовых технологиях, которые используются кластерами или помогаю расширить их возможности.
SMB 3.0
Новая версия протокола SMB 3.0 используется для сетевого обмена данными. Этот протокол востребован при выполнении чтения, записи и других файловых операций на удаленных ресурсах. В новой версии реализовано большое количество усовершенствований, которые позволяют оптимизировать работу SQL Server, Hyper-V и файловых кластеров. Обратим внимание на следующие обновления:
- прозрачная отказоустойчивость. Это новшество обеспечивает непрерывность выполнения операций. При сбое одного из узлов файлового кластера текущие операции автоматически передаются другому узлу. Благодаря этому нововведению стала возможной реализация схемы Active-Active с поддержкой до 8 узлов.
- масштабирование. Благодаря новой реализации общих томов кластера (версия 2.0) существует возможность одновременного доступа к файлам через все узлы кластера, за счет чего достигается агрегация пропускной способности и осуществляется балансировка нагрузки.
- SMB Direct. Реализована поддержка сетевых адаптеров с технологией RDMA. Технология RDMA (удаленный прямой доступ к памяти) позволяет передавать данные непосредственно в память приложения, существенно освобождая центральный процессор.
- SMB Multichannel. Позволяет агрегировать пропускную способность и повышает отказоустойчивость при наличии нескольких сетевых путей между сервером с поддержкой SMB 3.0 и клиентом.
Необходимо сказать, что для использования этих возможностей поддержка SMB 3.0 должна присутствовать на обоих концах соединения. Компания Microsoft рекомендует использование серверов и клиентов одного поколения (в случае с Windows Server 2012 такой клиентской платформой является Windows 8). К сожалению, на сегодня Windows 7 поддерживает только SMB версии 2.1.
Storage Spaces.
Технология Storage Spaces реализована впервые в операционных системах Windows Server 2012 и Windows 8. Реализована поддержка новой файловой системы ReFS, которая обеспечивает функции повышения отказоустойчивости. Есть возможность назначения дисков в пуле для горячей замены (в случае отказа других носителей или для быстрой замены исчерпавшего свой ресурс SSD). Кроме того, расширены возможности тонкой настройки с использованием PowerShell.
По сути, технология Storage Spaces является программной реализацией RAID, расширенной за счет большого числа дополнительных функций. Во-первых, накопители с прямым доступом должны быть объединены в пулы. В принципе накопители могут быть любых типов и мощностей, однако для организации стабильной работы необходимо четкое понимание принципов функционирования технологии.
Далее на пулах можно создавать виртуальные диски следующих типов (не путать с VHD/VHDX):
- простой (является аналогом RAID 0);
- зеркало (двухстороннее зеркало является аналогом RAID1, трехстороннее зеркало представляет собой более сложную схему наподобие RAID 1E)
- с контролем четности (является аналогом RAID 5. Данный вариант обеспечивает минимальный перерасход пространства при минимальной отказоустойчивости).
Технология Storage Spaces не является абсолютным новшеством. Похожие возможности были давно реализованы в Windows Server, например в форме динамических дисков. Технология Storage Spaces позволяет сделать использование всех этих возможностей более удобными и обеспечить новый уровень использования. Среди прочих преимуществ Storage Spaces необходимо отметить тонкую инициализацию (thin provisioning), которая дает возможность назначать виртуальным дискам размеры сверх доступных в реальности из расчета на добавление в соответствующий пул новых накопителей впоследствии.
Один из наиболее непростых вопросов, связанных с технологией Storage Spaces – это производительность. Как правило, программные реализации RAID уступают по производительности аппаратным вариантам. Однако, если речь идет о файловом сервере, то Storage Spaces получает в свое распоряжение большой объем оперативной памяти и мощный процессор, поэтому необходимо тестирование с учетом различных видов нагрузки. С этой точки зрения особую ценность приобретают возможности тонкой настройки с использованием PowerShell.
Технология Storage Spaces предлагает отказ от RAID-контроллеров и дорогих систем хранения, перенеся из логику на уровень операционной системы. Эта идея раскрывает все свои достоинства и оказывается достаточно привлекательной вместе с еще одним новшеством.
Scale-Out File Server (SOFS).
Еще одним новшеством является режим кластеризуемой роли File Server в Windows Server 2012, который получил название Scale-Out File Server. Теперь реализована поддержка двух типов кластеризации, названия которых полностью звучат как File Sever for General Use и Scale-Out File Server (SOFS) for application data. Каждая из технологий имеет свои сферы применения, а также свои достоинства и недостатки.
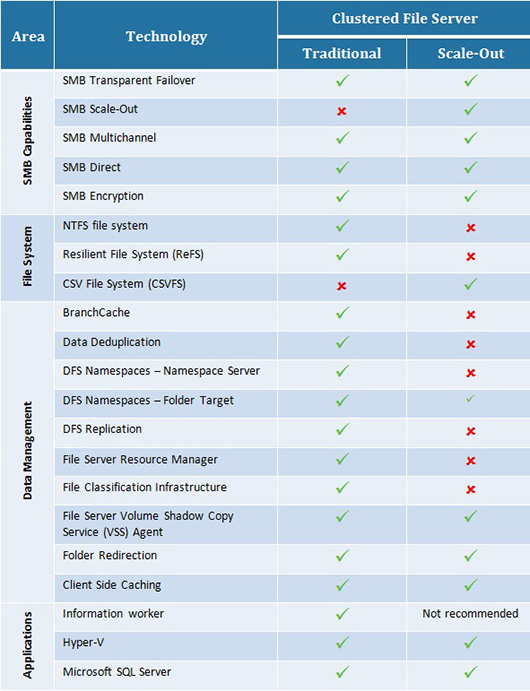
Всецелевой файловый сервер представляет собой хорошо известный тип кластера Active-Passive. В свою очередь SOFS представляет собой кластер Active-Active, являясь действительно отказоустойчивой конфигурацией. Для совместного доступа к соответствующим папкам используется опция Continuously Available.
Помимо отличных характеристик отказоустойчивости это обеспечивает повышение пропускной способности при условии рационального проектирования сетевой архитектуры. Проксирующая файловая система CSV 2.0 (CSVFS) позволяет уменьшить влияние CHKDSK, позволяя утилите выполнять необходимые операции, сохраняя при этом возможность работы с томом активных приложений. Реализовано кэширование чтения с CSV. Использование CSV обеспечивает простоту и удобство развертывания и управления. Пользователю нужно создать обычный кластер, настроить том CSV и активировать роль файлового сервера в режиме Scale-Out File Server for application data.
Благодаря простоте и функциональности предложенного решения сформировался новый класс оборудования «кластер-в-коробке» (Сluster-in-a-Box, CiB). Как правило, это шасси с двумя блейд-серверами и дисковым массивом SAS JBOD с поддержкой Storage Spaces. Здесь важно, чтобы SAS JBOD были двухпортовыми, и имелся SAS HBA для реализации перекрестного подключения.
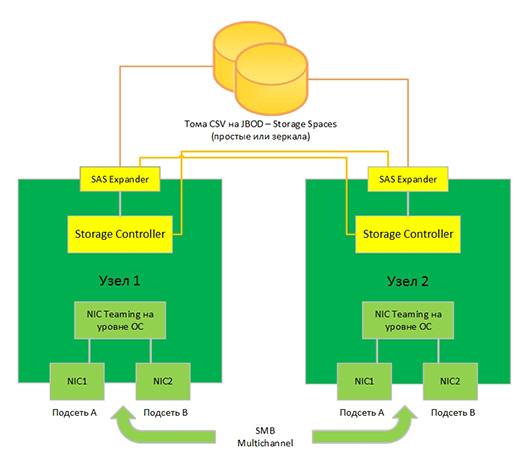
Такая организация системы ориентирована именно на поддержку SOFS. Учитывая, что iSCSI target стандартно интегрирован в Windows Server 2012 и также может быть кластеризована, таким образом может реализовать «самодельную» систему хранения данных на базе всецелевой операционной системы.
Однако следует иметь ввиду, что владельцем CSV по-прежнему является один из узлов, который отвечает за все операции с метаданными. При большом количестве метаданных может наблюдаться снижение производительности, поэтому для SOFS не рекомендуется использовать сценарий Information Worker, тогда как Hyper-V и SQL Server идеально подходят для этого, в том числе благодаря функциям агрегации пропускной способности.
Другие новшества технологий кластеризации Windows.
Выше мы перечислили только самые важные и крупные новшества в области кластеризации в Windows Server 2012. Другие менее крупные нововведения, однако, тоже появились не случайно.
Была расширена поддержка виртуализации за счет существенного упрощения создания гостевых кластеров (из виртуальных машин). В отличие от Windows Server 2008 R2, где для этого нужно было предоставить iSCSI Target в общее пользование виртуальных машин, в операционной системе Windows Server 2012 появилась функция, позволяющая виртуализировать FC-контроллер (по аналогии с сетевыми адаптерами), за счет чего виртуальные машины получают возможность непосредственного доступ к LUN. Реализован и более простой вариант с использованием общей сетевой папки SMB 3.0 для гостевых Windows Server 2012.
Одной из важных, но нетривиальных задач является установка программных обновлений в кластере. При этом может потребоваться перезагрузка узлов, поэтому процедура должна контролироваться. В операционной системе Windows Server 2012 предлагается инструмент Cluster-Aware Updating, который работает следующим образом: один из узлов назначается координатором и следит за наличием обновлений, загружает их на остальные узлы и выполняет поочередное обновление узлов, начиная с тех, которые загружены меньше всего. Благодаря этому доступность кластера сохраняется на максимально возможном уровне в течение всего процесса обновления.
Есть новшества и в управлении кворумом. Например, реализована возможность давать право голоса только некоторым узлам. Это может быть полезно при размещении отдельных узлов на удаленной площадке, но имеет наибольшую ценность при реализации новой модели динамического кворума. Основная идея динамического кворума состоит в том, что узел, прекративший свою работу и недоступный в течение определенного промежутка времени по любой причине, теряет право голоса вплоть до повторного подключения. Таким образом, общее число голосов сокращается и кластер сохраняет доступность максимально долго.
Новшества в Windows Server 2012 R2.
Операционная система Windows Server 2012 R2 не является простым обновлением Windows Server 2012, а представляет собой полноценную новую операционную систему. Новшества, реализованные в Windows Server 2012 R2 переводят некоторые возможности серверной платформы на качественно новый уровень. В первую очередь это касается SOFC и Hyper-V.
Высокодоступные виртуальные машины.
Упрощена процедура создания гостевых кластеров, поскольку теперь появилась возможность использовать в качестве общего хранилища обычные VHDX, которые внутри виртуальной машины будут представлены как Shared SAS-диски. При этом сами VHDX должны быть размещены на CSV или в общих папках SMB 3.0. При этом в виртуальных машинах могут использоваться как Windows Server 2012 R2, так и Windows Server 2012 (с обновленными интеграционными компонентами).
Опция DrainOnShutdown призвана избавить системных администраторов от ошибок и лишней работы. Функция активирована по умолчанию и при плановых перезагрузках или выключениях заранее переводит узел в такой режим обслуживания при котором эвакуируются все кластеризованные роли. При этом происходит миграция активных виртуальных машин на другие узлы кластера Hyper-V.
Также в новой операционной системе Windows Server 2012 R2 Hyper-V производит мониторинг сетевых интерфейсов в виртуальных машинах и в случае возникновения проблемы запускает процесс их миграции на узел, где доступна внешняя сеть.
Кворум.
Кроме динамического кворума в Windows Server 2012 R2 реализован еще и динамический диск-свидетель (witness). При изменении числа узлов его голос может быть автоматически учтен, так, чтобы общее число голосов оставалось нечетным. В случае, если сам диск окажется недоступным, его голос будет просто обнулен. Такая схема позволяет полностью положиться на автоматические механизмы, отказавшись от моделей кворума.
Увеличена надежность работы кластеров, размещенных на двух площадках. Часто при такой реализации на каждой площадке находится ровно половина узлов, поэтому нарушения коммуникации между площадками может возникнуть проблема с формированием кворума. Хотя с большинством подобных ситуаций успешно справляется механизм динамического кворума, в Windows Server 2012 R2 существует возможность назначить одной из площадок низкий приоритет, для того, чтобы в случае сбоя кластер всегда функционировал на основной площадке. В случае, если кластер был запущен с принудительным кворумом, то при восстановлении связи с удаленной площадкой службы кластера будут перезапущены в автоматическом режиме и весь кластер будет вновь объединен.
CSV 2.1
Существенные изменения коснулись и реализации CSV. Теперь роли владельцев томов равномерно распределяются по узлам в автоматическом режиме, в соответствии с изменением их числа. Увеличена отказоустойчивость CSV благодаря тому, что на каждом узле кластера запускается по два экземпляра серверной службы. Один используется для обслуживания клиентского SMB-трафика, другой обеспечивает коммуникацию между узлами. При этом обязательно производится мониторинг службы и в случае сбоя роль владельца CSV мигрирует на другой узел.
Целый ряд новшеств в CSV обеспечивает более эффективное использование SOFC и Storage Spaces. Добавлена поддержка файловой системы ReFS, которая обладает более совершенной, чем NTFS внутренней организацией. Скорее всего постепенно эта файловая система займет ведущее положение в продуктах компании Microsoft. Также в Windows Server 2012 R2 реализован механизм дедупликации, который ранее был прерогативой всецелевого файлового сервера. Активация дедупликации приводит к отключению CSV Block Cache, однако в некоторых случаях она может быть достаточно эффективной. Тома CSV могут создаваться на дисковых пространствах с контролем четности.
В Windows Server 2012 R2 возможность комбинировать накопители различных типов приобрела особый смысл с многоуровневыми пространствами. Появилась возможность формировать два уровня быстрый (на основе SSD) и емкий (на основе жестких дисках) и при создании виртуального диска выделять определенный объем из каждого из них. Далее в соответствии с некоторым расписанием содержимое виртуального диска будет анализироваться и размещаться блоками по 1 МБ на более быстрых или медленных носителях в зависимости от востребованности. Другим применением многоуровневых пространств является реализация кэша с обратной записью на SSD. В моменты пиковых нагрузок запись осуществляется на быстрые твердотельные накопители, а позже холодные данные перемещаются на более медленные жесткие диски.
Новшества, касающиеся CSV и Storage Spaces, являются наиболее существенными в Windows Server 2012 R2. На их основе можно разворачивать не просто надежные файловые серверы, а мощные и гибкие системы хранения данных с прекрасными возможностями масштабирования и отличной отказоустойчивостью, предоставляющие в распоряжение пользователя широкий спектр современных инструментов.