AVX512
Go 1.11 release introduces AVX-512 support.
This page describes how to use new features as well as some important encoder details.
Terminology
Most terminology comes from Intel Software Developer’s manual.
Suffixes originate from Go assembler syntax, which is close to AT&T, which also uses size suffixes.
Some terms are listed to avoid ambiguity (for example, opcode can have different meanings).
| Term | Description |
|---|---|
| Operand | Same as «instruction argument». |
| Opcode | Name that refers to instruction group. For example, VADDPD is an opcode. It refers to both VEX and EVEX encoded forms and all operand combinations. Most Go assembler opcodes for AVX-512 match Intel manual entries, with exceptions for cases where additional size suffix is used (e.g. VCVTTPD2DQY is VCVTTPD2DQ ). |
| Opcode suffix | Suffix that overrides some opcode properties. Listed after «.» (dot). For example, VADDPD.Z has «Z» opcode suffix. There can be multiple dot-separated opcode suffixes. |
| Size suffix | Suffix that specifies instruction operand size if it can’t be inferred from operands alone. For example, VCVTSS2USIL has «L» size suffix. |
| Opmask | Used for both Related to masking support in EVEX prefix. |
| Register block | Multi-source operand that encodes register range. Intel manual uses +n notation for register blocks. For example, +3 is a register block of 4 registers. |
| FP | Floating-point |
New registers
EVEX-enabled instructions can access additional 16 X (128-bit xmm) and Y (256-bit ymm) registers, plus 32 new Z (512-bit zmm) registers in 64-bit mode. 32-bit mode only gets Z0-Z7 .
New opmask registers are named K0-K7 .
They can be used for both masking and for special opmask instructions (like KADDB ).
Masking support
Instructions that support masking can omit K register operand.
In this case, K0 register is implied («all ones») and merging-masking is performed.
This is effectively «no masking».
K1-K7 registers can be used to override default opmask.
K register should be placed right before destination operand.
Zeroing-masking can be activated with Z opcode suffix. Zeroing-masking requires that a mask register other than K0 be specified.
For example, VADDPD.Z (AX), Z30, K3, Z10 uses zeroing-masking and explicit K register.
— If Z opcode suffix is removed, it’s merging-masking with K3 mask. — If K3 operand is removed, it generates an assembler error. — If both Z opcode suffix and K3 operand are removed, it is merging-masking with K0 mask.
It’s compile-time error to use K0 register for
EVEX broadcast/rounding/SAE support
Embedded broadcast, rounding and SAE activated through opcode suffixes.
For reg-reg FP instructions with
- RU_SAE to round towards +Inf
- RD_SAE to round towards -Inf
- RZ_SAE to round towards zero
- RN_SAE to round towards nearest
For reg-reg FP instructions with
For reg-mem instrictons with m32bcst/m64bcst operand, broadcasting can be turned on with BCST opcode suffix.
Zeroing opcode suffix can be combined with any of these.
For example, VMAXPD.SAE.Z Z3, Z2, Z1 uses both Z and SAE opcode suffixes.
It is important to put zeroing opcode suffix last, otherwise it is a compilation error.
Register block (multi-source) operands
Register blocks are specified using register range syntax.
It would be enough to specify just first (low) register, but Go assembler requires explicit range with both ends for readability reasons.
For example, instructions with +3 range can be used like VP4DPWSSD Z25, [Z0-Z3], (AX) .
Range [Z0-Z3] reads like «register block of Z0, Z1, Z2, Z3».
Invalid ranges result in compilation error.
AVX1 and AVX2 instructions with EVEX prefix
Previously existed opcodes that can be encoded using EVEX prefix now can access AVX-512 features like wider register file, zeroing/merging masking, etc. For example, VADDPD can now use 512-bit vector registers.
See encoder details for more info.
Supported extensions
Best way to get up-to-date list of supported extensions is to do ls -1 inside test suite directory.
Latest list includes:
128-bit and 256-bit instructions additionally require avx512vl .
That is, if VADDPD is available in avx512f , you can’t use X and Y arguments without avx512vl .
Filenames follow GNU as (gas) conventions.
avx512extmap.csv can make naming scheme more apparent.
Instructions with size suffix
Some opcodes do not match Intel manual entries.
This section is provided for search convenience.
| Intel opcode | Go assembler opcodes |
|---|---|
| VCVTPD2DQ | VCVTPD2DQX , VCVTPD2DQY |
| VCVTPD2PS | VCVTPD2PSX , VCVTPD2PSY |
| VCVTTPD2DQ | VCVTTPD2DQX , VCVTTPD2DQY |
| VCVTQQ2PS | VCVTQQ2PSX , VCVTQQ2PSY |
| VCVTUQQ2PS | VCVTUQQ2PSX , VCVTUQQ2PSY |
| VCVTPD2UDQ | VCVTPD2UDQX , VCVTPD2UDQY |
| VCVTTPD2UDQ | VCVTTPD2UDQX , VCVTTPD2UDQY |
| VFPCLASSPD | VFPCLASSPDX , VFPCLASSPDY , VFPCLASSPDZ |
| VFPCLASSPS | VFPCLASSPSX , VFPCLASSPSY , VFPCLASSPSZ |
| VCVTSD2SI | VCVTSD2SI , VCVTSD2SIQ |
| VCVTTSD2SI | VCVTSD2SI , VCVTSD2SIQ |
| VCVTTSS2SI | VCVTSD2SI , VCVTSD2SIQ |
| VCVTSS2SI | VCVTSD2SI , VCVTSD2SIQ |
| VCVTSD2USI | VCVTSD2USIL , VCVTSD2USIQ |
| VCVTSS2USI | VCVTSS2USIL , VCVTSS2USIQ |
| VCVTTSD2USI | VCVTTSD2USIL , VCVTTSD2USIQ |
| VCVTTSS2USI | VCVTTSS2USIL , VCVTTSS2USIQ |
| VCVTUSI2SD | VCVTUSI2SDL , VCVTUSI2SDQ |
| VCVTUSI2SS | VCVTUSI2SSL , VCVTUSI2SSQ |
| VCVTSI2SD | VCVTSI2SDL , VCVTSI2SDQ |
| VCVTSI2SS | VCVTSI2SSL , VCVTSI2SSQ |
| ANDN | ANDNL , ANDNQ |
| BEXTR | BEXTRL , BEXTRQ |
| BLSI | BLSIL , BLSIQ |
| BLSMSK | BLSMSKL , BLSMSKQ |
| BLSR | BLSRL , BLSRQ |
| BZHI | BZHIL , BZHIQ |
| MULX | MULXL , MULXQ |
| PDEP | PDEPL , PDEPQ |
| PEXT | PEXTL , PEXTQ |
| RORX | RORXL , RORXQ |
| SARX | SARXL , SARXQ |
| SHLX | SHLXL , SHLXQ |
| SHRX | SHRXL , SHRXQ |
Encoder details
Bitwise comparison with older encoder may fail for VEX-encoded instructions due to slightly different encoder tables order.
This difference may arise for instructions with both
This does not affect code behavior, nor makes it bigger/less efficient.
New encoding selection scheme is borrowed from Intel XED.
EVEX encoding is used when any of the following is true:
- Instruction uses new registers (High 16 X / Y , Z or K registers)
- Instruction uses EVEX-related opcode suffixes like BCST
- Instruction uses operands combination that is only available for AVX-512
In all other cases VEX encoding is used.
This means that VEX is used whenever possible, and EVEX whenever required.
Compressed disp8 is applied whenever possible for EVEX-encoded instructions.
This also covers broadcasting disp8 which sometimes has different N multiplier.
Experienced readers can inspect avx_optabs.go to learn about N multipliers for any instruction.
For example, VADDPD has these: * N=64 for 512-bit form; N=8 when broadcasting * N=32 for 256-bit form; N=8 when broadcasting * N=16 for 128-bit form; N=8 when broadcasting
Examples
Exhaustive amount of examples can be found in Go assembler test suite.
Each file provides several examples for every supported instruction form in particular AVX-512 extension.
Every example also includes generated machine code.
Here is adopted «Vectorized Histogram Update Using AVX-512CD» from Intel® Optimization Manual:
Знак на крышке процессора Intel позволит отличить модели с огромным скрытым потенциалом. Стало известно, как определить CPU с поддержкой AVX-512
В Сети описали способ, как быстро визуально отличить процессор Intel Alder Lake с поддержкой инструкций AVX-512 от версии без такой поддержки.
Как оказалось, у новой ревизии на крышке новый логотип. Сначала некоторые пользователи даже думали, что это поддельные CPU, но тут никаких проблем нет.
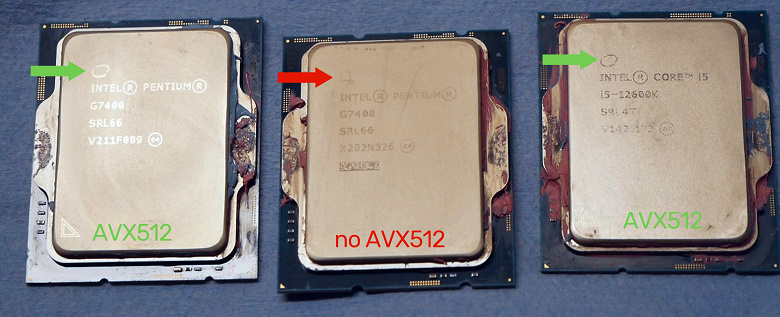
Процессоры новой ревизии с новым логотипом как раз не имеют поддержки AVX-512 на аппаратном уровне. Intel начала поставлять такие CPU в марте, так что, скорее всего, встретить старую ревизию в продаже будет уже не так просто, но вероятность всё равно имеется.
Напомним, CPU Alder Lake изначально вышли с поддержкой инструкций AVX-512, хотя Intel официально сначала ничего об этом не говорила. Позже компания выпустила обновление BIOS для системных плат, которое блокирует такой режим работы, а с начала весны начала поставлять уже новую ревизию, где поддержка этих инструкций отсутствует уже на аппаратном уровне.
Поддержка AVX-512 нужна далеко не всем, но в ряде приложений в таком режиме этот набор инструкций делает процессор в два-три раза производительнее, но за это придётся заплатить сильно возросшим энергопотреблением.
Intel заставляет производителей матплат отключать поддержку AVX-512

Блоки векторных инструкций AVX-512 на процессоре Core i9-12900K
Всем производителям материнских плат Z690 на процессорах Alder Lake пришло обновление микрокода от Intel, которое полностью запрещает использование инструкций AVX-512.
Физически модуль AVX-512 остался на ядрах P. Его можно было активировать через BIOS и повысить производительность в 14–32 раза в некоторых специфических задачах, отключив при этом малополезные ядра E. Теперь лазейку закрыли.
Таким образом Intel окончательно убрала официальную поддержку AVX-512 из новых процессоров 12-го поколения Alder Lake. Изначально предполагалось, что этот модуль физически убрали с микросхемы, потому что он занимает много места. Но потом выяснилось, что блоки остались на месте, но только в производительных ядрах P.
Обновление микрокода пришло производителям буквально за несколько дней до начала выставки CES 2022, где Intel собирается представить ряд младших процессоров в семействе Alder Lake. Естественно, все они работают на материнских платах с чипсетом Z690. И вот теперь компания решила окончательно закрыть вопрос с поддержкой AVX-512.
Причины отключения AVX-512
Официально причины не разглашаются. Мы можем только предполагать. Дело в том, что единственным условием для активации AVX-512 является отключение ядер E. При этом во многих задачах такая замена (AVX-512 вместо ядер E) практически не отражается на производительности или даже улучшает её.

Отключение ядер E практически не отражается на производительности после активации AVX-512
Другая причина: усложнение настроек с отключением/включением ядер создаёт дополнительную нагрузку на службу технической поддержки Intel.
Наконец, самое главное. Программное отключение AVX-512 в десктопных процессорах создаёт дополнительный спрос на процессоры для рабочих станций и серверов, где набор инструкций будет работать как положено. В данном случае компании совершенно не нужно, чтобы коммерческие клиенты использовали более дешёвые настольные процессоры.
В проигрыше остаются пользователи, которые хотели воспользоваться преимуществами AVX-512 именно на последнем поколении настольных процессоров Intel. Теперь им остаётся использовать другие процессоры с поддержкой AVX-512, то есть все предыдущие поколения Intel или будущее поколение AMD Ryzen, которое выйдет очень скоро.
Искусственная рыночная сегментация и распределение пользователей по секторам рынка с разной рентабельностью — известный приём, который позволяет максимизировать прибыль. Им пользуются очень многие компании, которые выпускают примерно одинаковые товары, но для разных рыночных сегментов и по разным ценам.
Intel многократно использовала этот приём. Говорят, в первых семи поколениях Core специально не выпускались настольные процессоры более чем с четырьмя ядрами, чтобы не повредить более прибыльному серверному сегменту.
Выпуск одинаковых процессоров в «залоченной» и «разлоченной» версиях, с отключенными/включенными ядрами и т. д. — это стандартный арсенал грязных приёмов у производителей компьютерных комплектующих.
Ограничения на AVX2
Проблема с блокировкой AVX-512 усугубляется тем, что в оставшемся наборе инструкций AVX2 стоит ограничение на максимальный множитель тактовой частоты х51, пишет Igor’s Lab.
То есть при выполнении инструкций AVX2 тактовая частота процессора принудительно понижается до 5,1 ГГц не может быть поднята даже до 5,2 ГГц ни при каких настройках BIOS, независимо от охлаждения, энергопотребления, реальной температуры CPU или запущенного приложения. Например, в программе HWInfo режим принудительного ограничения частоты можно распознать по строке IA: Max Turbo Limit – Yes .

Активирован режим IA: Max Turbo Limit – Yes
Неофициальные хаки
К счастью, уже разработаны методы обхода программных ограничений, установленных Intel, как в отношении блокировки AVX-512, так и по троттлингу AVX2.
Например, компания Asus в материнских платах серии Maximus реализовала патч BIOS, который отключает троттлинг AVX2 при условии принудительного выставления тактовой частоты в BIOS.
Активировать AVX-512 сложнее, но тоже возможно. Сообщество уже нашло способ внедрить в новую прошивку старую версию микрокода от Intel, что эффективно включает обратно AVX-512.

Конечно, в этом случае мы получаем неофициальную версию BIOS с лишением гарантии и всеми вытекающими последствиями. Но это хотя бы доказывает, то отключение AVX-512 является обратимым.
AVX-512, инструкции Intel SIMD для искусственного интеллекта и мультимедиа
Инструкции AVX-512 — один из уникальных элементов Intelx86 ЦП архитектуры. Но что это за инструкции, связанные с их реализацией на процессорах Intel? Продолжайте читать, чтобы понять причину существования этих инструкций, какие у них есть варианты и почему они не используются AMD в своих процессорах.
Инструкции AVX были впервые реализованы в процессорах Intel, заменив старые инструкции SSE. С тех пор они стали стандартными инструкциями SIMD для процессоров x86 в двух вариантах, 128-битном и 256-битном, которые также были приняты AMD. С другой стороны, если говорить об инструкциях AVX-512, ситуация иная, и они используются только в процессорах Intel.
Что такое SIMD-модуль?
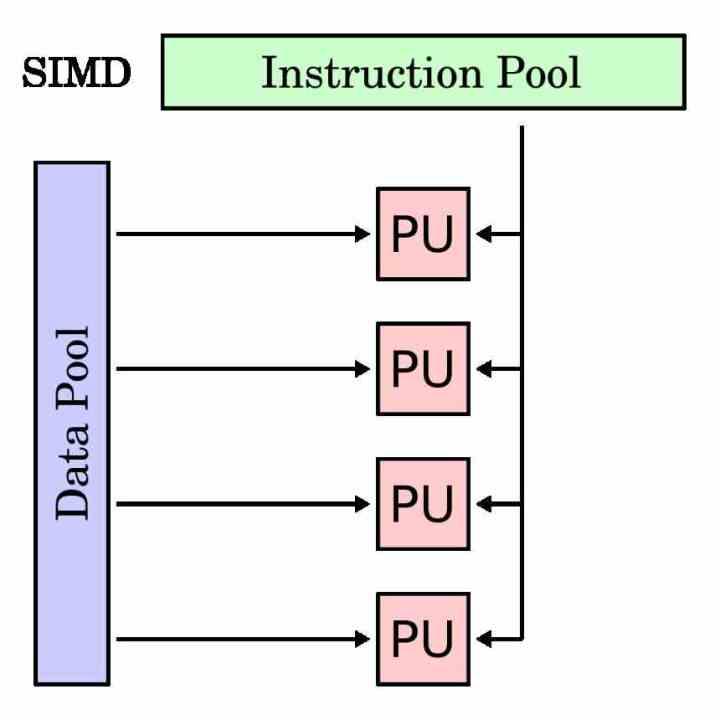
Модуль SIMD — это тип исполнительного модуля, который предназначен для одновременного выполнения одной и той же инструкции для нескольких данных. Следовательно, его регистр накопителя длиннее, чем у традиционной инструкции, поскольку он должен группировать различные данные, с которыми он должен работать с той же самой инструкцией.
Блоки SIMD традиционно использовались для ускорения так называемых мультимедийных процессов, в которых необходимо манипулировать различными данными в соответствии с одними и теми же инструкциями. Блоки SIMD позволяют распараллеливать выполнение программы в этих частях и ускорить время выполнения.
В каждом процессоре, чтобы отделить исполнительные блоки SIMD от традиционных, они имеют собственное подмножество инструкций, которое обычно является зеркалом скалярных инструкций или с одним операндом. Хотя есть случаи, которые невозможно сделать со скалярным модулем и они относятся исключительно к модулям SIMD.
История AVX-512
Инструкции AVX, Advanced Vector eXtensions, находятся внутри процессоров Intel в течение многих лет, но происхождение инструкций AVX-512 отличается от остальных. Причина? Его источником является проект Intel Larrabee, попытка Intel в конце 2000-х годов создать GPU / ГРАФИЧЕСКИЙ ПРОЦЕССОР которые в конечном итоге стали ускорителями Xeon Phi. Серия процессоров, предназначенных для высокопроизводительных вычислений, выпущенная Intel несколько лет назад.
Архитектура Xeon Phi / Larrabee включает специальную версию инструкций AVX с размером регистра накопителя 512 бит, что означает, что они могут работать с 16 32-битными данными. Причина такой суммы связана с тем фактом, что типичное соотношение операций на тексель для графического процессора обычно составляет 16: 1. Не будем забывать, что инструкции AVX-512 взяты из неудачного проекта Larrabee и были перенесены оттуда в Xeon Phi.
По сей день Xeon Phi больше не существует, причина в том, что то же самое можно сделать с помощью традиционного графического процессора для вычислений. Это заставило Intel передать эти инструкции своей основной линейке процессоров.
Тарабарщина в виде инструкций AVX-512
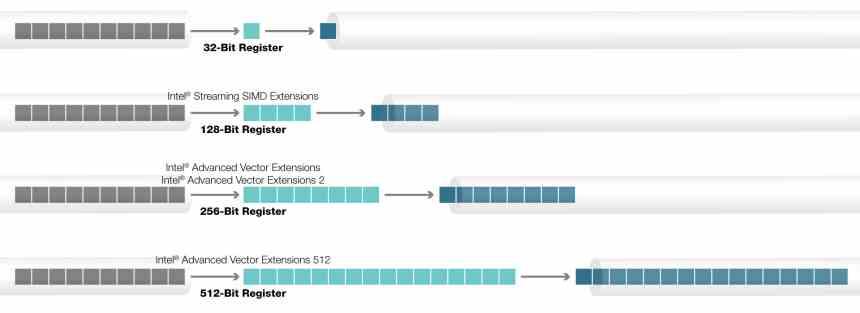
Инструкции AVX-512 не являются однородным блоком, который реализован на 100%, а скорее имеют различные расширения, которые, в зависимости от типа процессора, были добавлены или нет. Все процессоры называются AVX512F, но есть дополнительные инструкции, которые не являются частью исходного набора команд и которые Intel со временем добавила.
Расширения AVX512 следующие:
- AVX-512-CD: Обнаружение конфликтов, позволяет векторизовать циклы и, следовательно, векторизовать их. Впервые они были добавлены в Skylake-X или Skylake-SP.
- AVX-512-ER: Взаимные и экспоненциальные инструкции, которые предназначены для выполнения трансцендентных операций. Они были добавлены в серию Xeon Phi под названием Knights Landing.
- АВХ-512-ПФ: Еще одно включение в Knights Landing, на этот раз для повышения предупредительных или предпочтительных возможностей инструкций.
- AVX-512-BW: Инструкции байтового (8-битного) и уровня слов (16-битного) уровней. Это расширение позволяет работать с 8-битными и 16-битными данными.
- AVX-512-DQ: Добавьте новые инструкции с 32-битными и 64-битными данными.
- АВХ-512-ВЛ : Позволяет инструкциям AVX работать с регистрами накопителя XMM (128-бит) и YMM (256-бит)
- АВХ-512-ИФМА: Fused Multiply Add, которая в просторечии является инструкцией A * (B + C) с 52-битной целочисленной точностью.
- АВХ-512-ВБМИ: Инструкции по манипулированию вектором байтового уровня являются расширением AVX-512-BW.
- АВХ-512-ВННИ: Инструкции векторной нейронной сети — это серия инструкций, добавленных для ускорения алгоритмов глубокого обучения, используемых в приложениях, связанных с искусственным интеллектом.
Почему AMD еще не реализовала это на своих процессорах?
Причина этого очень проста: AMD стремится к комбинированному использованию своих ЦП и ГП при ускорении определенных типов приложений. Давайте не будем забывать происхождение AVX-512 в вышедшем из строя графическом процессоре от Intel и AMD. Благодаря своим графическим процессорам Radeon им не нужны инструкции AVX-512.
Вот почему инструкции AVX-512 являются эксклюзивными для процессоров Intel, не для полной исключительности, а потому, что AMD не заинтересована в использовании этого типа инструкций в своих ЦП, поскольку она намерена продавать свои графические процессоры, особенно недавно выпущенный AMD Instinct. высокопроизводительные вычисления с архитектурой CDNA.
Есть ли будущее у инструкций AVX-512?
Что ж, мы не знаем, это зависит от успеха Intel Xe, особенно Xe-HPC, который даст Intel архитектуру GPU на уровне AMD и NVIDIA. Это означает конфликт между инструкциями Intel Xe и AVX-512 для решения тех же проблем.
Проблема с AVX-512 заключается в том, что активация части процессора, которая его использует, в конечном итоге влияет на тактовую частоту процессора, снижая ее примерно на 25% в программе, которая использует эти инструкции в определенные моменты. Кроме того, его инструкции предназначены для высокопроизводительных вычислений и приложений искусственного интеллекта, которые не важны в том, что является домашним процессором, а появление специализированных блоков делает его пустой тратой транзисторов и пространства.
На самом деле ускорители или процессоры для конкретной области медленно заменяют блоки SIMD в ЦП, поскольку они могут делать то же самое, занимая меньше места и с незначительным энергопотреблением по сравнению.